阿里同传模型2.3秒的延迟,让AI第一次摸到了人类译员的门槛
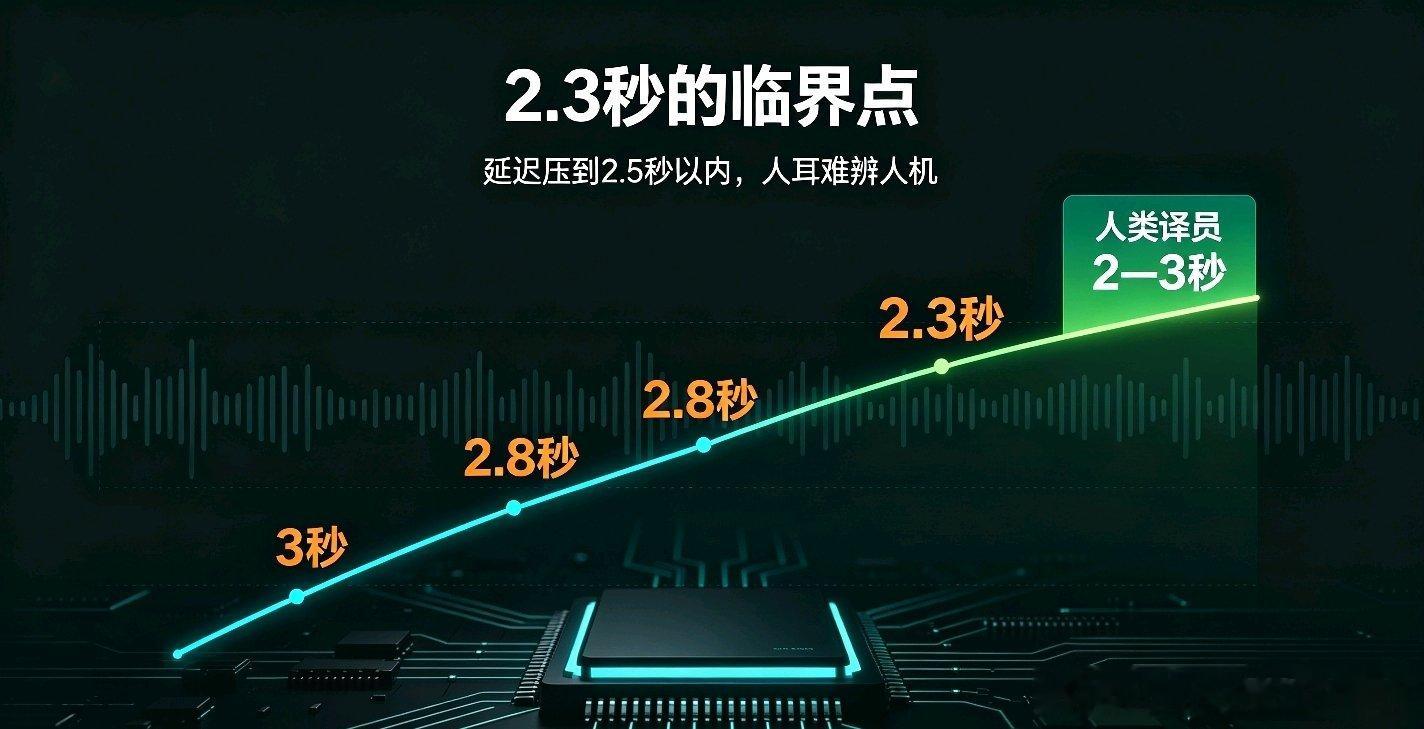
9月19日,阿里发布同声传译大模型Qwen3.8-LiveTranslate,字均延迟从2.8秒降到了2.3秒。
0.5秒,听起来是个小数字。
但在同传这个场景里,0.5秒的差距可能会改变整个体验。
做过同传的人都知道,人类专业译员的“耳到口”延迟大约在2到3秒之间。
一年前,AI同传的起步线还是3秒。今年5月上一代压到2.8秒,现在直接2.3秒。
2.3秒和2.8秒的区别在哪儿?
2.8秒的时候,听众能感觉到明显的滞后感,一句话说完了要等一会儿才能听到翻译。
2.3秒的时候,基本跟人类译员的节奏同步了。
有分析说,延迟一旦压到2.5秒以内,人耳基本分辨不出对面是人还是AI。
而且延迟降低的背后是架构的重新设计。
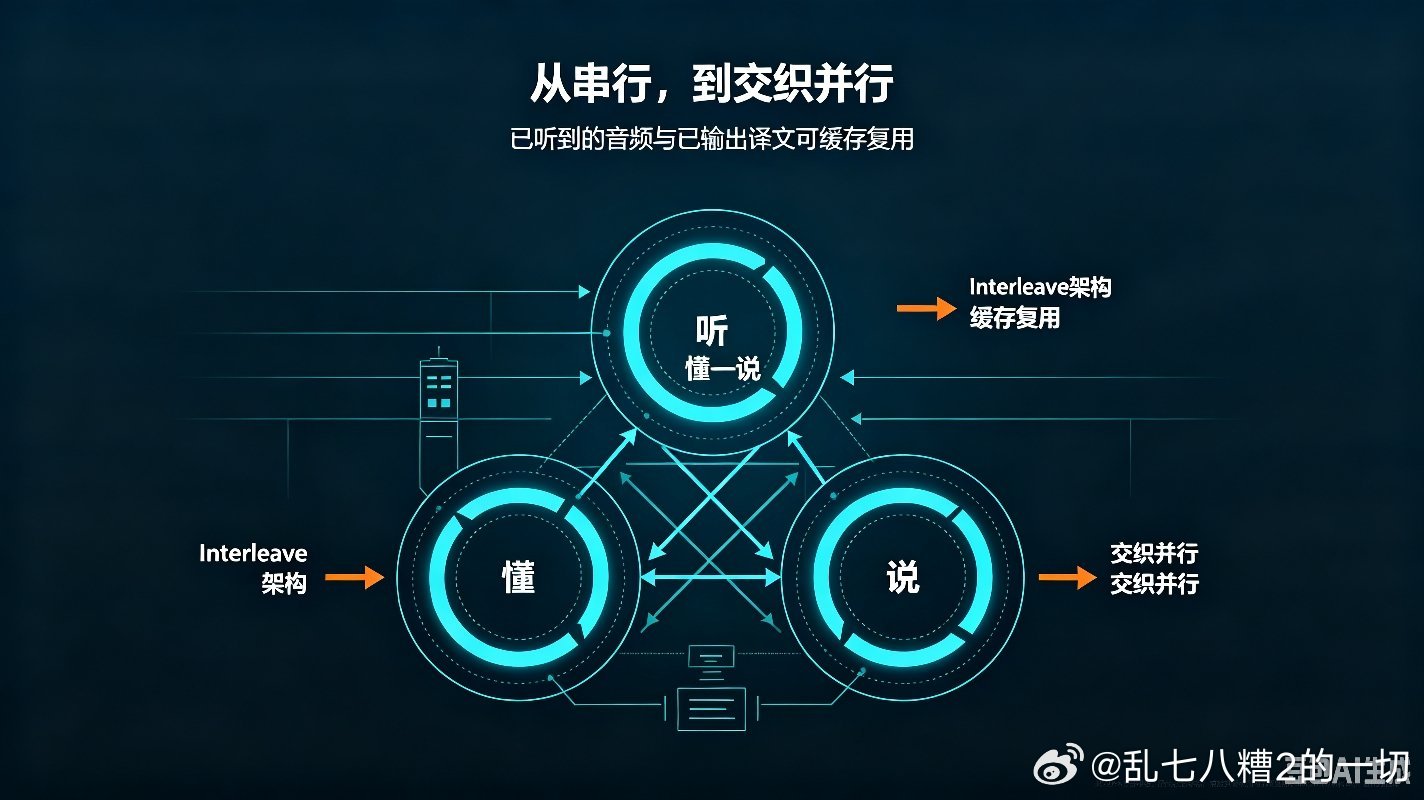
这次用了Interleave架构,把“听—懂—说”三件事从串行变成了交织并行。
已听到的音频和已输出的译文可以缓存复用,不用从头再跑一遍。
但2.3秒的背后,更大的意义在于算力。
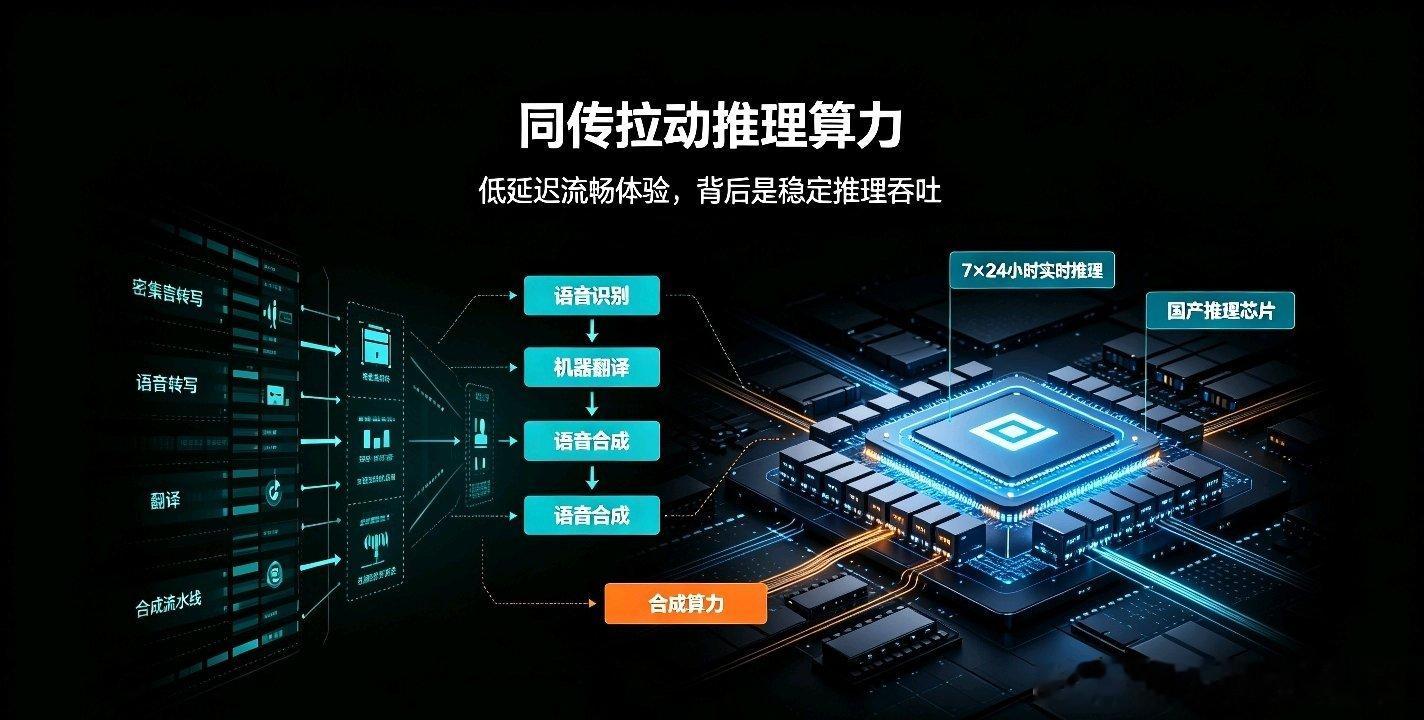
实时同传是所有AI应用里最吃推理算力的场景。
你聊天一次,几百个token就完事了。但同传是7×24小时不间断地“听—译—说”。
每一句话都要实时跑一遍语音识别、机器翻译和语音合成,token吞吐量是纯文本对话的好几倍。
这意味着什么?意味着同传越流畅、用的人越多,后端推理芯片的订单就越实在。
训练端我们暂时追不上英伟达,但推理端对单卡峰值性能要求没那么极端,更看重单位成本、延迟和功耗。
这恰恰是国产芯片的主场。
翻译行业有个残酷的规律:延迟卡在3秒以上,观众觉得“机器味重”。
压到2.5秒以内,人耳基本分不出对面是人还是AI。阿里这一步,正好卡在了临界点上。
而且同传的市场规模不小。有机构预测,全球AI同传市场2026年约12.8亿美元,到2035年可能冲到79.5亿美元。
短剧出海、跨境直播、跨国会议这些场景,全在抢这个能力。
从2.8秒到2.3秒,只是一个开始。真正要看的,是这条曲线接下来还能往下压多少。