半个月前和几个创投圈的朋友聊天,聊到一个挺有意思的现象:现在大家都在追几千亿参数的大模型,但真到企业要用的核心任务,反而不敢用了。
原因很简单。机密数据不敢传公有云,这是一个;能本地部署的小模型,经常只给你一段模棱两可的总结,数据还可能是猜的,落不了地,这是另一个。
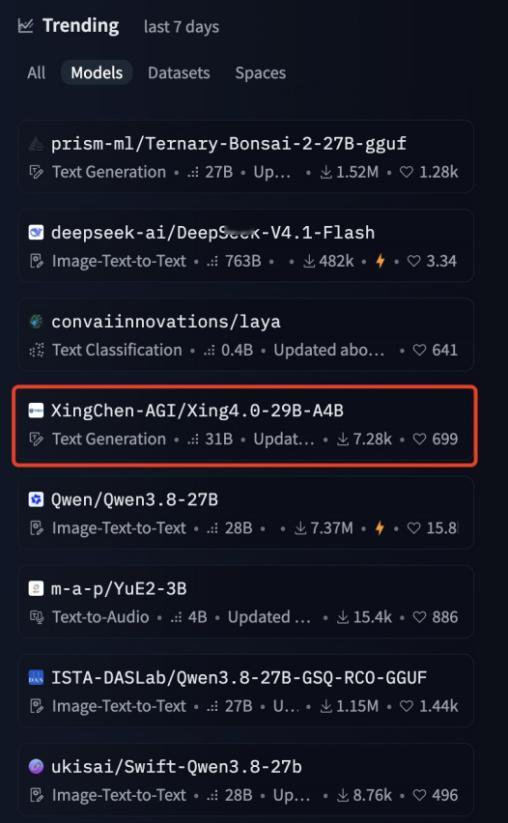
最后就很尴尬,聪明的模型不敢用,本地的小模型又太笨。今天翻开源社区,我注意到一个新发布的星辰大模型 Xing4.0-29B-A4B,开源3天,就登上了 Hugging Face Trending 榜全球第四。
Trending 榜主要反映模型近期在社区里的关注度和活跃度,它有一个很重要的参考价值:说明它迅速吸引了全球开发者的注意,引发了大量技术讨论。
而星辰大模型这次之所以受到关注,核心可能就在于:它试图用相对小的部署成本,解决真正复杂的任务。
1、先说架构。
这个模型总参数29B,采用MoE架构。它处理每个token时只激活4B参数,所以推理开销比同体量的稠密模型轻不少。
同时,它原生支持256K上下文,公开评测里,部分智能体和复杂工程任务的表现已经能跟更大模型掰手腕。小尺寸、全能力,大概就是这个意思。
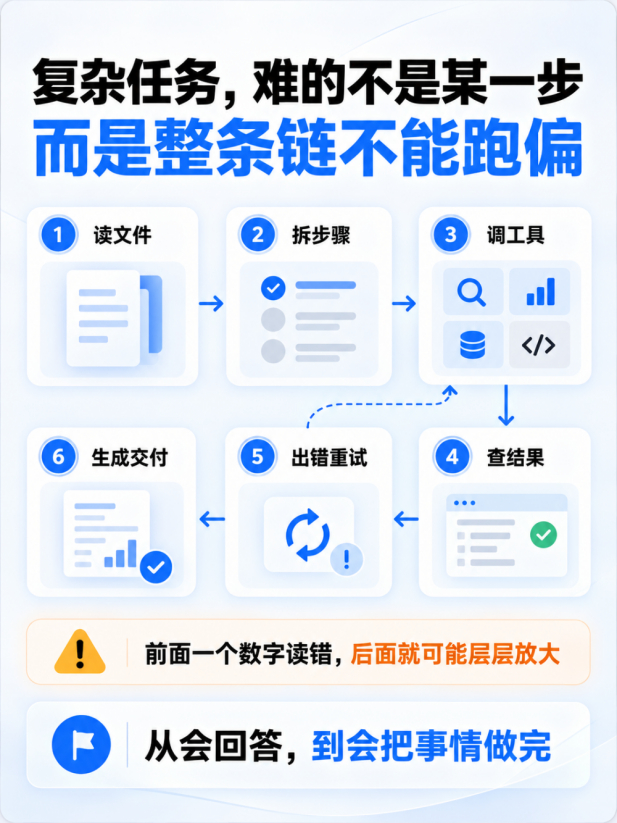
这里说的“复杂任务”,是给它一个目标后,让它自己拆步骤、读文件、调用搜索、表格或代码工具,再检查中间结果,出错了还能回到上一步重试。
比如把一堆财务报表整理成分析结论,或者把课程要求做成一套能交互的练习网页,往往要连续跑十几步。
模型需要保证整个链条不跑偏:前面一个数字读错、一次工具调用失败,后面都可能层层放大。
2、再说部署。
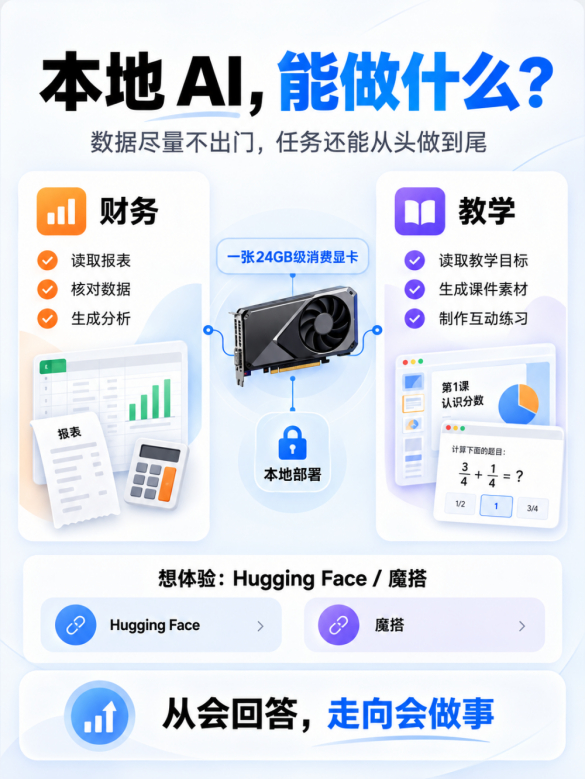
4-bit量化后,模型权重约15GB。实际运行还要给上下文缓存和推理框架预留显存,但一张24GB级消费显卡,已经有机会把它放到本地跑起来。
财务、人事这类天天接触机密报表的部门,可以让数据尽量留在自己的设备或内网里,隐私和合规压力都小很多。
还有一点容易被忽略,Agent任务动辄十几步调用,每一步都要等模型出结果。
每次只激活4B参数,意味着单步响应更轻,整条任务链也更有机会顺畅跑完。对复杂任务来说,速度不只是体验问题,还决定了这套流程到底能不能真正用起来。
再往大了看,它是从芯片到训练框架的全栈国产路线——基于昇腾集群和MindSpore完成训练。
放到真实场景里,老师可以让它读取教学目标、生成课件素材,再做出能直接运行的数学练习网页;财务人员也可以让它读取报表、核对数据、生成分析说明。这种从“会回答”走向“会做事”的小模型,比单纯堆参数更有意思。
我是在Hugging Face上看到它的,想自己试试的话,可以去Hugging Face,或者到魔搭搜索 Xing4.0-29B-A4B,下载权重、查看部署说明,或按文档接入自己的应用。
一张显卡、本地部署、数据不出门,还能把一件事从头做到尾,这才是普通人和中小团队真正能用上的AI。