这下美国媒体高兴不起来了,半年时间不到,中国团队就把他们刚庆祝完的里程碑,直接翻篇了!
今年3月,来自斯坦福的模型Merlin登上《自然》,它能识别腹部CT上的30种疾病。
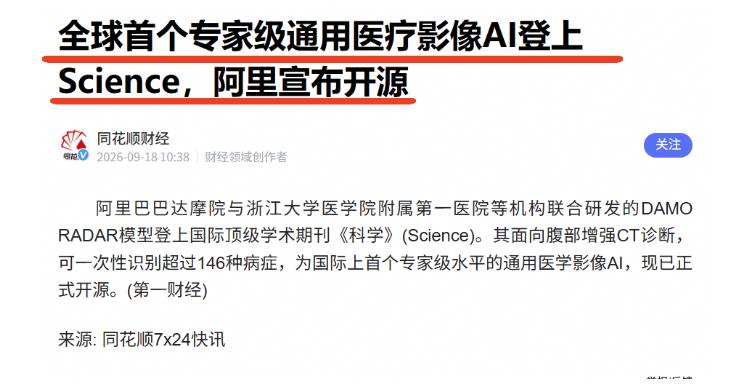
然后9月18号,达摩院联合浙大一院在《科学》上交了另一份答卷:一个模型覆盖18个器官、146种病症,近4万次真实世界检查中AUC达到0.913,人机对比中平均准确率超过26名放射科医生里的23名,成果直接开源。
斯坦福Merlin的贡献是真实的,它第一次证明了3D视觉语言模型能从CT影像里同时捕捉多种疾病信号,论文发了752项任务评估,数据集和代码都公开了,这是正经的学术推进。但它有一个绕不过去的硬伤:识别归识别,准确率始终没摸到临床可用的门槛。
当时有分析直接点出来,Merlin在多项任务上的表现“还没到医生平均水平”。一个AI能“看见”30种病,和它能在诊室里帮医生“判断”30种病,中间隔着一整个临床验证的鸿沟。
这半年里中国团队做的事情,本质上不是把30变成146,而是把“看见”变成了“可用”。
达摩院用的“器官级细粒度对齐”策略,说白了就是模拟医生的读片逻辑—不是把整个腹部搅成一锅粥去学,而是按肝、胆、胰、胃肠逐个器官做图像与报告文本的精确匹配。这个技术路线上的选择,决定了模型不是在“认标签”,而是在“读解剖”。
一个学过解剖学的学生和一个背过题库的学生,考同一张卷子可能分数差不多,但换一张卷子就分道扬镳了。DAMO RADAR在急腹症—也就是训练数据之外的场景——上依然跑出AUC 0.904,这才是“学过解剖”和“背过题”的分水岭。
更关键的是那个“超过23名医生”的人机对比。这不是实验室里跟上一个版本的自己比,是拉到14家真实医院、26名在岗放射科医生面前打擂台。赢了23个,输了3个。输了的那3个还是资深医生,也就是说,AI至少达到了中高年资住院医的水准。
而且AI辅助之下,医生识别疾病的敏感性提高了10%,读片用时减少30%以上,低年资医生能拉到高年资医生的水平。这不是“AI能不能替代医生”的老套辩论,这是“AI能不能让一个县医院的年轻医生拥有三甲主治的判断力”的真问题。
中国医疗体系最大的结构性痛点从来不是缺AI,是优质医生资源的分布极度不均。一个能开源、能一次覆盖146种腹部病症、能实时辅助的通用模型,对基层医院的意义和对顶级三甲的意义完全不是一回事。前者是“用得上”,后者只是“用得好”。
说到开源,这个动作本身值得单独拎出来看。美国团队做Merlin,数据集和代码也公开了,这点必须承认,学术圈的基本规矩是守住了的。但DAMO RADAR把模型直接开源,意味着任何一家医院——哪怕是没有AI研发能力的地市级医院——都可以拿过来部署。
斯坦福发布了知识,达摩院发布了工具。知识让人知道“这件事能做”,工具让人真去做。两者都重要,但对临床现场来说,工具的杠杆率远高于知识。
过去十年医疗AI的老路,说穿了就是“一病一模”:做个肺结节模型花两年,做个肝囊肿模型再花两年,每个模型都要海量人工标注,做完还是只会看一种病。这条路走不通的根本原因在于,病人不会按AI的能力清单来生病。
一个腹痛患者推进CT室,可能同时存在胆囊炎、胰腺渗出、肠壁增厚,你让医生开三个模型挨个跑?真实的临床场景不给你这个时间。
从“一病一模”到“一个模型看一个器官系统”,这才是这半年里真正的范式跳跃。斯坦福开了这个方向,达摩院把这条路修到了可以通车的地步。论文发在《自然》和《科学》上都是荣誉,但临床不看期刊影响因子,临床看的是你扫完CT之后多久能给出有用的判断。
美国媒体的失落其实可以理解。他们习惯的叙事是“美国提出概念,全球跟随验证”,Merlin发在《自然》上的那一刻,这个叙事看起来还在运转。
但半年后《科学》上的这篇论文把这个叙事截断了:概念是你提的,方向是你开的,但第一个把通用医疗影像AI做到“临床可用”这个标准线上的,不是美国团队。
DAMO RADAR不是终点。146种病症覆盖了腹部CT能查出来的大部分情况,但“大部分”在临床上永远不够—剩下的“小部分”往往才是致命的。开源意味着后面会有更多人在这条路上往前走,也意味着DAMO RADAR很快会被更新的版本超越。