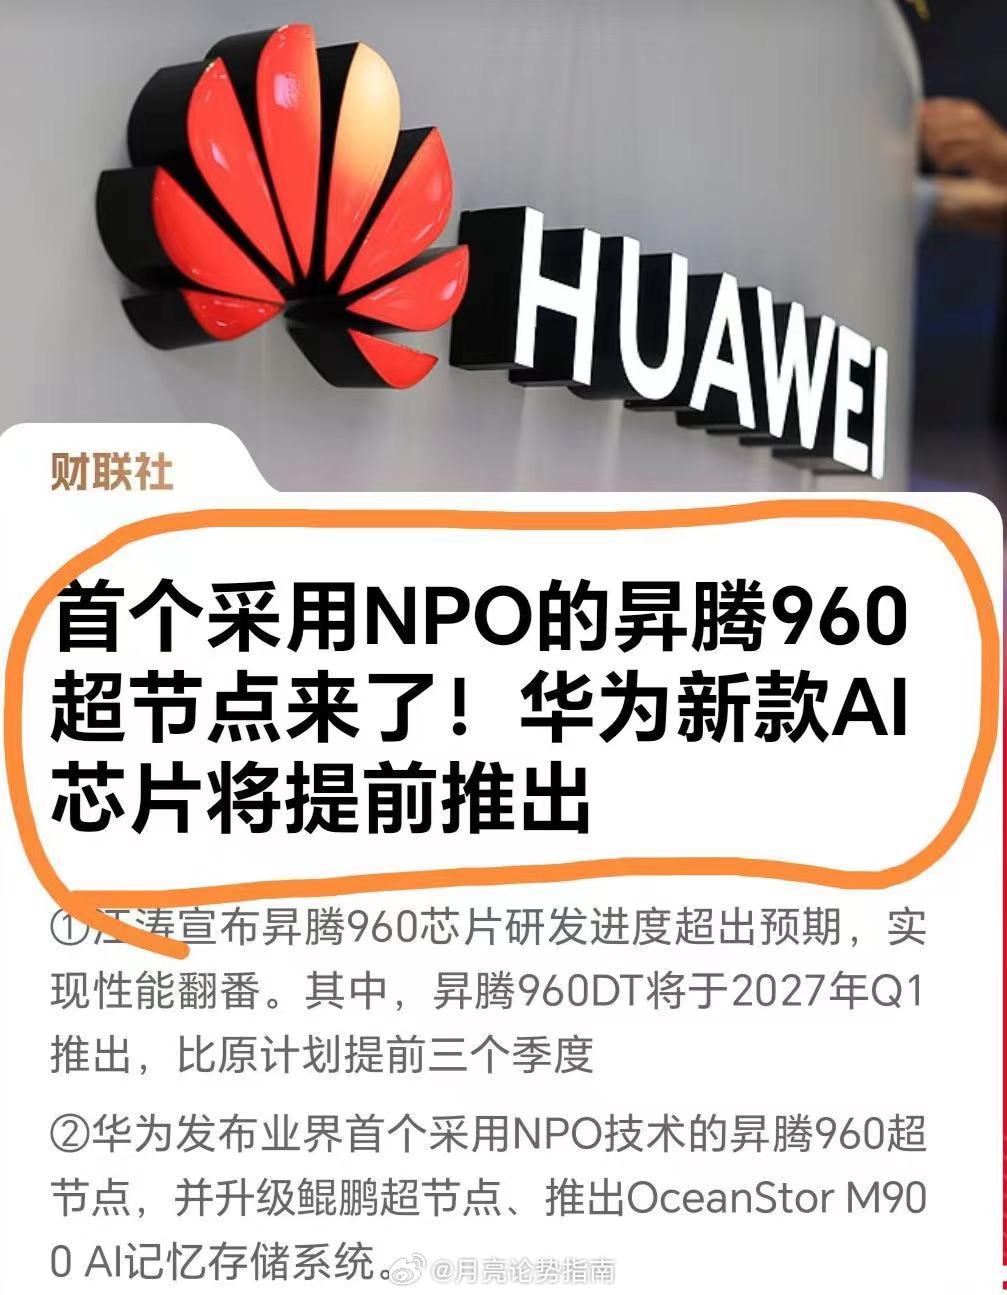
华为全联接大会重磅官宣!昇腾960提前落地,算力赛道逻辑彻底改写你以为国内AI算力追赶还在稳步推进?这场华为全联接大会直接放出重磅大招,昇腾下一代芯片进度大幅超前,整个AI算力底层框架迎来重大升级。本次大会上,华为官宣昇腾960芯片研发进度超出预期,性能实现翻番。昇腾960DT定在2027年一季度推出,相比原定计划提前三个季度;昇腾960PR将于2027年三季度上线,提前一个季度,后续还将保持一年一代迭代节奏,昇腾970、980也已排期至2028、2029年。同时发布业界首款搭载NPO技术的昇腾960超节点,升级鲲鹏超节点,推出OceanStor M900 AI记忆存储,依托灵衢统一互联,搭建可支撑百万卡规模的Agentic超节点集群。底层逻辑上,现在大模型参数快速冲向十万亿级别,未来还会持续扩容,智能体可以长时间连续执行任务,海量Token推理对算力、内存、互联带宽提出极高要求。传统服务器架构,集群内部通信会占用大量训练时间,算力利用率上不去。而昇腾超节点,把数千张卡通过高速光互联整合,逻辑上变成一台巨型计算机。借助自研NPO光互联Hi-ONE,用五千多套设备替代数万颗光模块,功耗大幅下降,系统稳定性翻倍,算力利用率相比传统集群提升巨大。另外OceanStor M900专门解决Agent长序列推理的KV缓存难题,延长存储介质寿命,补齐大模型推理的存储短板。生态层面同样值得重视。鲲鹏开发者突破416万,合作企业超7200家,openEuler装机量突破2000万套;CANN社区持续壮大,昇腾原生训练模型数量稳步增长,国内完整算力软硬件生态已经成型,不再是单一芯片单打独斗。放到A股盘面来看,这则消息直接强化算力主线中长期逻辑。全球AI竞争的核心就是算力底座,海外大厂一边渲染AI风险呼吁放缓模型迭代,一边持续加码硬件。而国内算力路线持续提速,芯片、光互联、存储、服务器全链条同步突破,政策+产业双线加持。短期市场会受美联储加息等外部因素扰动,带来板块震荡,但这次技术落地,进一步夯实算力赛道的成长逻辑。掏心窝来说,AI竞争拼的不只是大模型,更是一整套算力硬件、互联技术、存储系统和软件生态。昇腾芯片提前落地,代表国内算力自主节奏进一步提速,打破外部硬件壁垒。后续行情,资金会持续聚焦算力硬件、光互联、AI存储等细分方向。外部的扰动只会制造短期波动,AI基础设施这条主线,长期成长空间已经打开。风险提示:本文仅为市场信息解读,不构成任何投资参考。