《华为960超节点,你让英伟达情何以堪!》
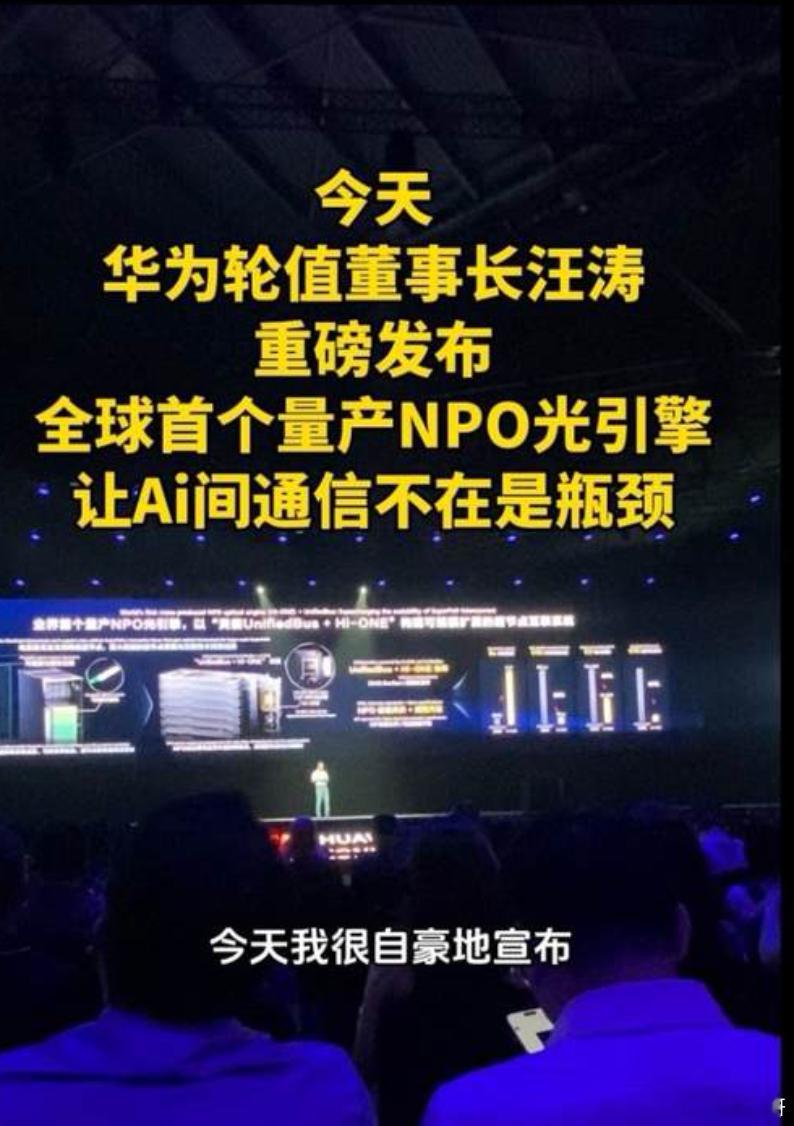
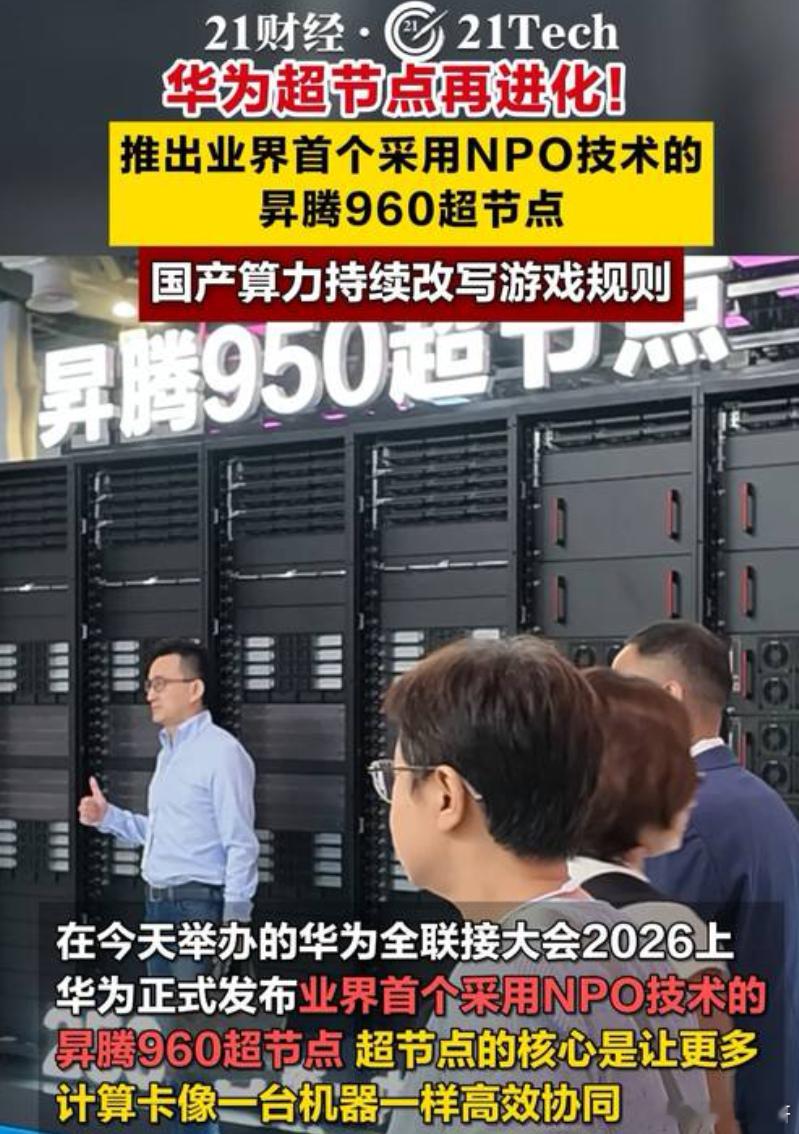
950超节点刚刚稳定量产,华为就在全联接大会2026上甩出了昇腾960超节点——这次的重点不只是单卡性能提升,而是全球首个采用NPO光引擎的超节点架构。
黑子们,先把概念搞清楚再喷。
华为这次用的是自研的Hi-ONE NPO光引擎,单引擎传输容量7.2T,是业界首个量产的NPO产品,也是目前行业最大传输能力的NPO产品,更是唯一实现内置光源的NPO产品。这不是"第二代光引擎模块",是业界首个真正落地的NPO方案。
5500个Hi-ONE,替代4.8万颗800G光模块,功耗降低超550千瓦,系统无故障运行时间提升一倍,系统可用度达到99.8% 。这叫什么?这叫"用数学补物理、非摩尔补摩尔,用群计算补单芯片"——华为的老路子了。
英伟达还在"铜光并举",华为已经All-in光引擎。
英伟达CEO黄仁勋在GTC 2026上明确表态:"铜仍然重要,光学会用于不同维度的扩展,两者都是必须能力"。英伟达的新一代MGX NVL机架——NVIDIA Kyber,单机架NVLink域容量翻倍,可容纳144个GPU,同时采用CPO(共封装光学)与铜互连实现Scale-up扩展 。
为什么英伟达还在用铜?因为高速铜缆模组价格仅为同规格光模块的十分之一左右,同时无需光电转换流程,信号传输延迟几乎可以忽略不计。英伟达多次公开表态,短距算力互联场景"能用铜缆优先用铜缆",其新一代Feynman系统、NVL72机柜架构均重点搭载高速铜缆互联方案,单台NVL72机柜需配备超5000根高速铜缆。
但问题来了——铜缆的物理极限已经到了。
当GPU集群规模迈过万卡级门槛,瓶颈已经不在芯片本身的算力,而在芯片之间数据搬运的效率。铜缆在机柜内短距离互联还能撑住,一旦跨机柜、跨机架,信号衰减和功耗问题就压不住了。所以英伟达的方案是"铜光混合"——机柜内用铜缆,机柜间用光互联 。
而华为呢?直接跳过了"铜光混合"阶段,All-in NPO光引擎。
昇腾960超节点,单个超节点4096卡规模,最大提供8 EFLOPS FP8算力,1PB HBM容量。多个超节点互联,最大集群规模可达51.2万卡,甚至支持100万卡昇腾超节点集群。华为的产品路线图写得明明白白:昇腾960DT将于2027年第一季度发布,比原计划提前三个季度;昇腾960PR将于2027年第三季度发布,比原计划提前一个季度;2028年和2029年还将陆续推出昇腾970、980芯片——这叫"使用一代、研发一代、储备一代"。
英伟达的光互联,还在依赖中国供应商。
黑子们最爱吹的"英伟达技术领先",在光模块领域有个尴尬的事实——英伟达每买10个1.6T光模块,8个来自中国公司中际旭创 。图
在800G光模块领域,中际旭创的全球市占率超40%至55%,更高端的1.6T光模块市占率超50%,是英伟达第一大光模块供应商。在英伟达1.6T光模块采购中,中际旭创份额高达80%,公司独家供应英伟达GB200平台70%的1.6T光模块。英伟达2026年光模块采购量已上调至2000万只,订单排产至2027年。
换句话说,每一台英伟达GPU集群里,都装着中国造的光模块。美国AI的"血管",是中国造的 。
更讽刺的是,英伟达的CPO共封装光学技术,2024年才首次公开技术路线展示概念原型,2025年还在实验室验证与客户送样阶段,直到2026年8月才正式宣布Spectrum-6系列CPO交换机进入全面量产阶段。而华为的NPO光引擎,已经作为业界首个量产NPO产品,直接装进了昇腾960超节点 。
英伟达的CPO还在交换机层面打转,华为的NPO已经做到了超节点系统级的光互联。这就是技术路线的代差。
黑子们,你们影响不了华为的技术路线。
英伟达还在CUDA生态的舒适区里躺着,华为已经从芯片到光互联、从单卡到超节点、从硬件到软件,把整个AI基础设施的技术栈重新定义了一遍。CANN全面开源开放,已进入常态化的开源社区运营,从"可用"到"易用",昇腾已跨越生态拐点。昇腾超节点是国内唯一训练出SOTA模型的超节点,已规模商用1000多套,携手3000多家行业合作伙伴,孵化7000多个行业解决方案。
美国的技术封锁客观上为国产算力创造了发展空间,DeepSeek等企业加速转向国产方案——这不是"被迫选择",这是"主动突围"。
昇腾960超节点,让英伟达情何以堪?情何以堪的不是性能差距,是技术路线的代差。
黑子们,你们可以继续在评论区里找补,但华为已经跑到了下一条赛道。你们还在A赛道数圈数,人家已经在B赛道冲线了。