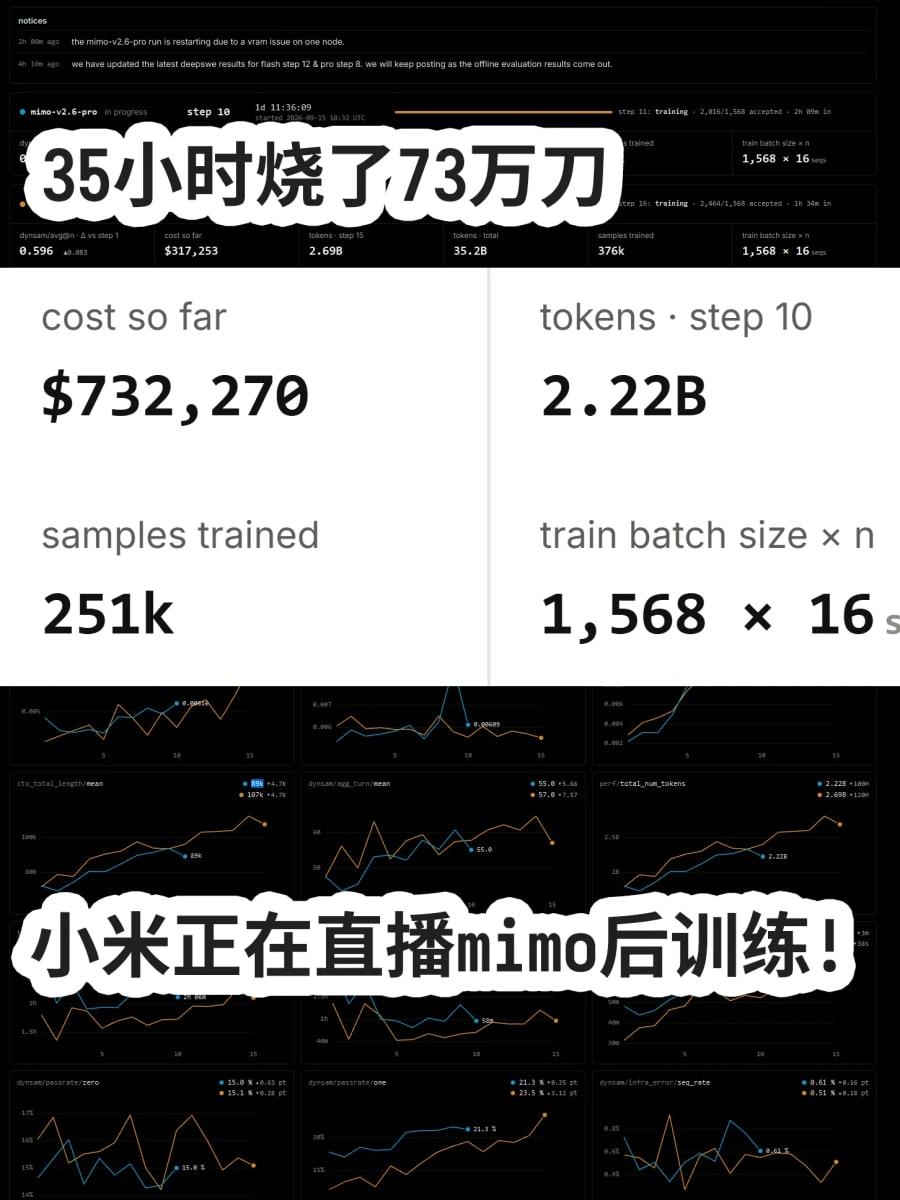
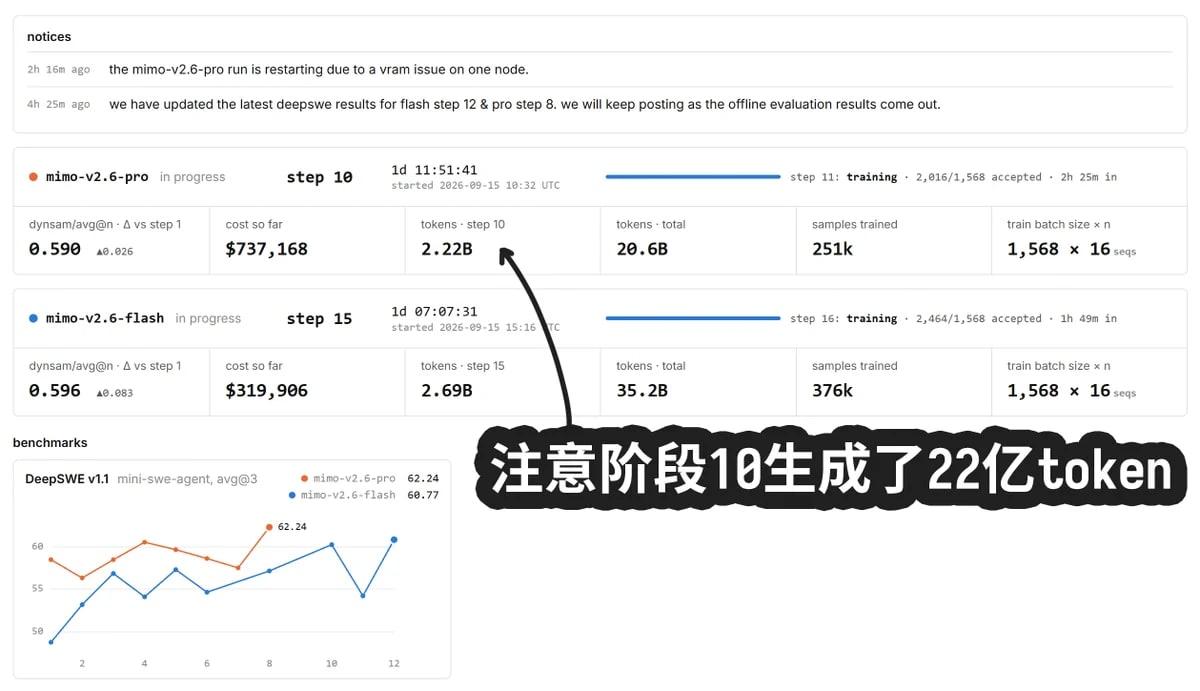
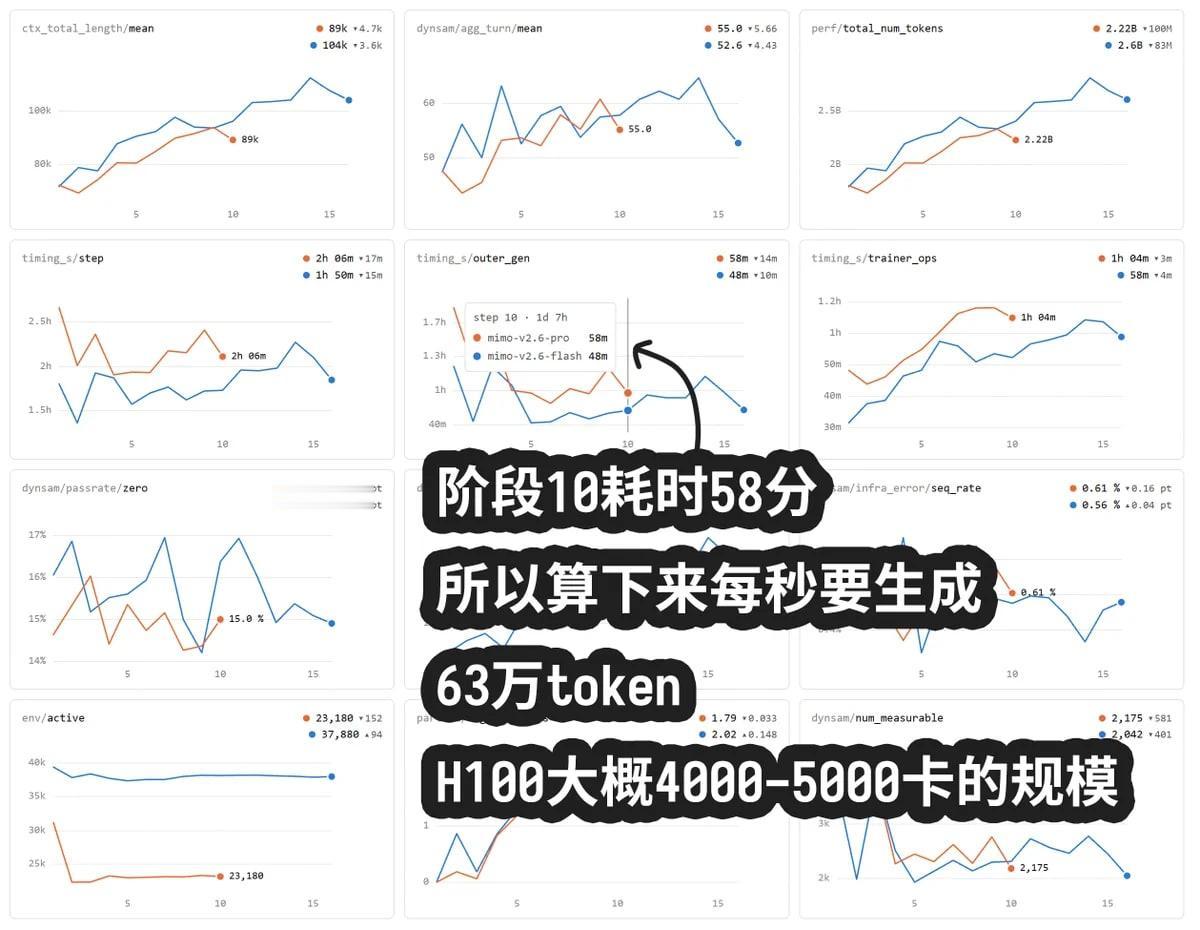
每秒烧掉约10美元,听起来像在烧金砖——但先别急着下结论。小米这次把 mimo-v2.6-pro 和 flash 两个模型的后训练全程直播,阶段10光是 rollout 就跑了58分钟、生成约22亿 token,平均上下文长度89K,作者按 H100 单卡100–150 tps 推算,集群至少得铺4000–5000张卡,双模型同时跑,总规模被估到6000–8000张 H100。沙箱还维持着 pro 两万三、flash 近三万八的并发量,一边跑代码一边跑终端命令。
钱烧在哪儿其实很清楚:长上下文 rollout + 几万级沙箱并发 + 两个模型并行训练,三件叠在一起,单卡吞吐被压得很死,推理和反向传播还得共用这批卡——先做58分钟 rollout,再切64分钟反向传播。这么一来,每秒10美元不是夸张,更像是这种 Agentic RL 训练结构的必然结果。
但花大钱不等于分数快涨。当前 mimo-v2.6-pro 在 DeepSWE 上只有62分,DeepSeek-v4.1-flash 已经74.2,作者自己也说还在训练早期。也就是说,从62追到74.2这段路,每一秒都在花钱,每一分提升却还没明显冒头。
更稳的说法是:这次直播最大的看点不是"贵不贵",而是"钱花得这么密集,分数曲线到底走成什么样"。在 Agentic RL 早期阶段,长上下文 rollout 和高并发沙箱的成本结构决定了烧钱速度,能力提升的节奏还得再观察几轮更新才能下结论。
你最想先看到哪个数字:单卡真实吞吐,还是训练结束时的 DeepSWE 最终分?