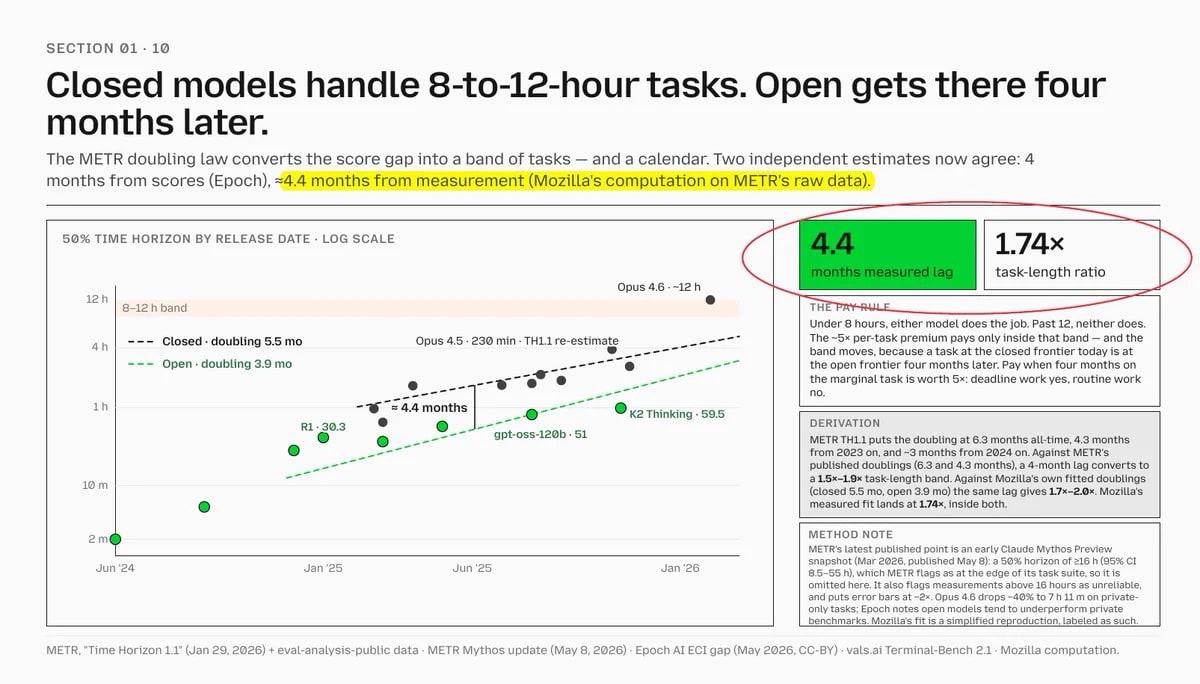
当你以为闭源大模型还能稳坐王座,调用榜单可能早就换主人了。Mozilla 一份 91 页的报告抛出一个反差:开源权重 AI 在能力上还落后前沿约 4 个月,但在 8 月 OpenRouter 按 token 量排出的前 10 大模型里,8 个都是开源权重,7 个来自中国厂商,DeepSeek 甚至拿下了周请求数第一。
这个错位才是真正值得盯着的地方。能力差 4 个月,听起来不小,但放在模型迭代以周计算的当下,已经不是代差,而是节奏差。开源一边在 Hugging Face 上被下载、被微调、被塞进各种本地部署,另一边调用量悄悄爬到了榜单前列,说明开发者用脚投票的速度,比性能曲线还快。
有人会把“开源 8 个、中国 7 个”直接解读成中国 AI 已经全面反超。结论下得太早。报告里这份排名衡量的是 token 调用量,不是收入,也不是推理质量。能力差 4 个月在 To C 体验里可能只是细微的语气差别,但在企业付费、法律、医疗这类对幻觉和合规敏感的场域,依然是真实的鸿沟。
更值得追问的是商业回报倒挂。模型被大规模调用,并不等于被大规模付费。报告没有披露闭源厂商的收入结构和利润是否被吃掉,但 OpenRouter 那个榜单已经说明,开发者先用脚投票,至于谁最后拿到钱,剧本还没写完。
所以更稳的判断是,开源权重已经在“被使用”这件事上进入主流,但在“被信任”和“被付费”上还没跟上。如果未来几个季度,闭源厂商拿不出可量化的差异化收入证明,光靠性能领先 4 个月,护城河会被调用数据一点点稀释。
最近一次项目里,你有没有因为开源模型够用就停掉了闭源 API 的账单?