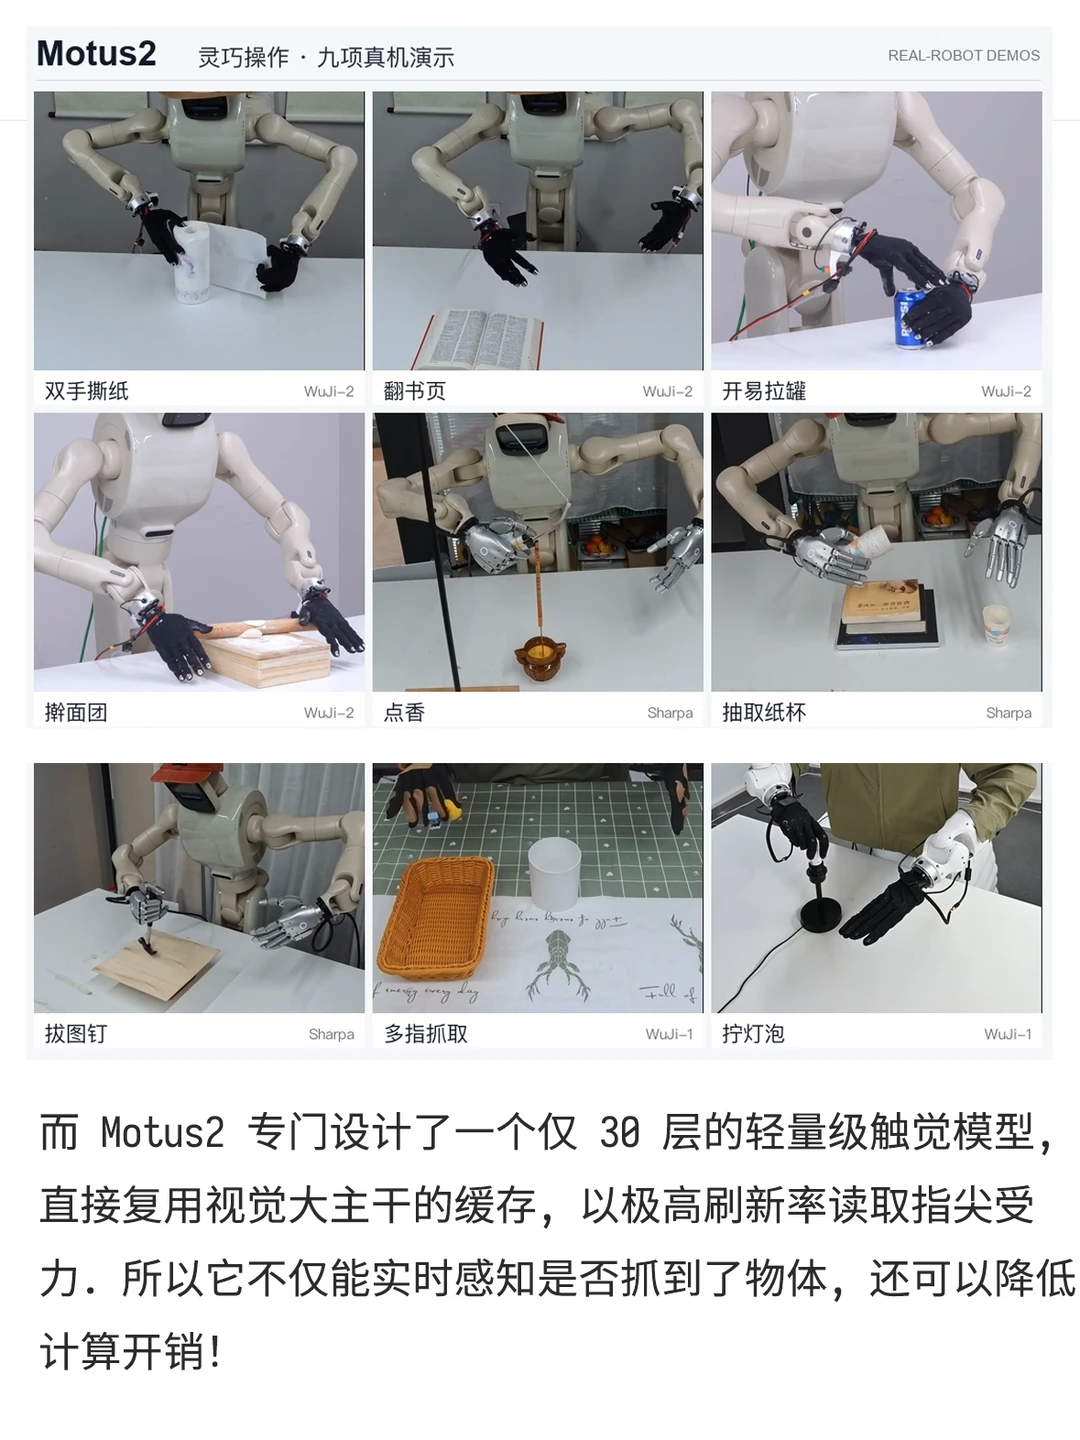
最近大家看各家机器人干细活(比如 拧瓶盖)的时候, 经常会看到类似"碰一下就抽了"这种翻车现场. 原因就在于, 机器人很多只是在闭眼死记硬背人类的动作.
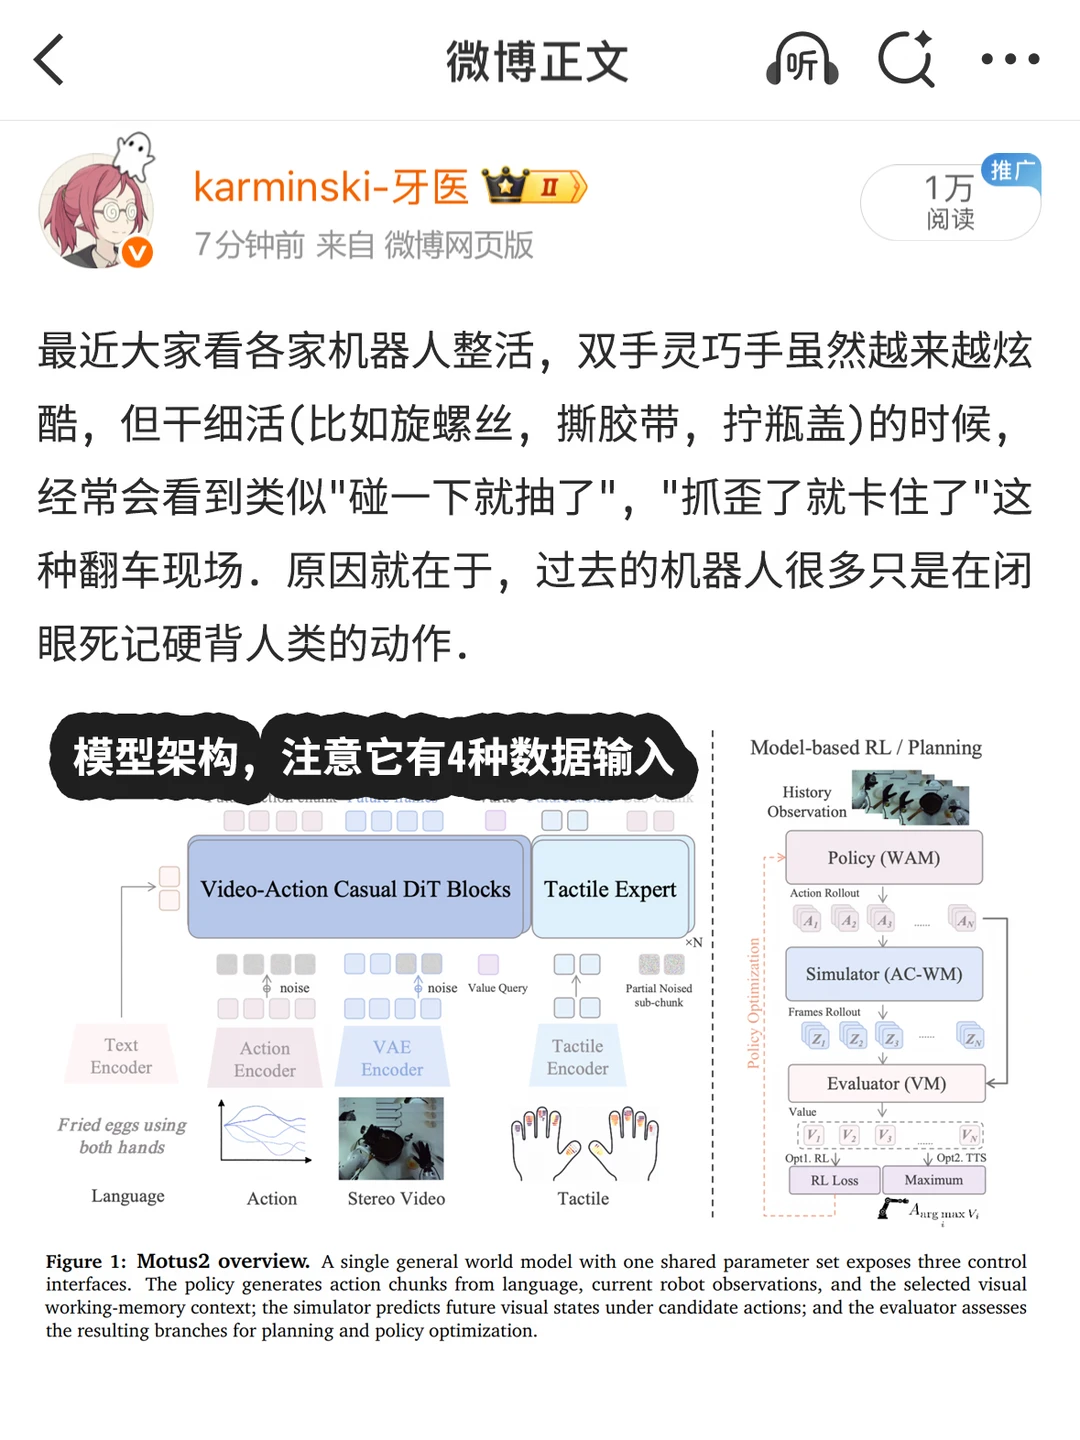
而生数科技刚刚放出的重磅模型 Motus2, 重新实现了一个世界模型:不仅让世界模型接入了触觉模态,更首次统一了「策略、模拟、评估」,并结合触觉与历史信息,把预测后果、评价结果、改进动作连接起来,实现自进化闭环! 成功解决了这个难题!
我整理了一下模型的输入输出:
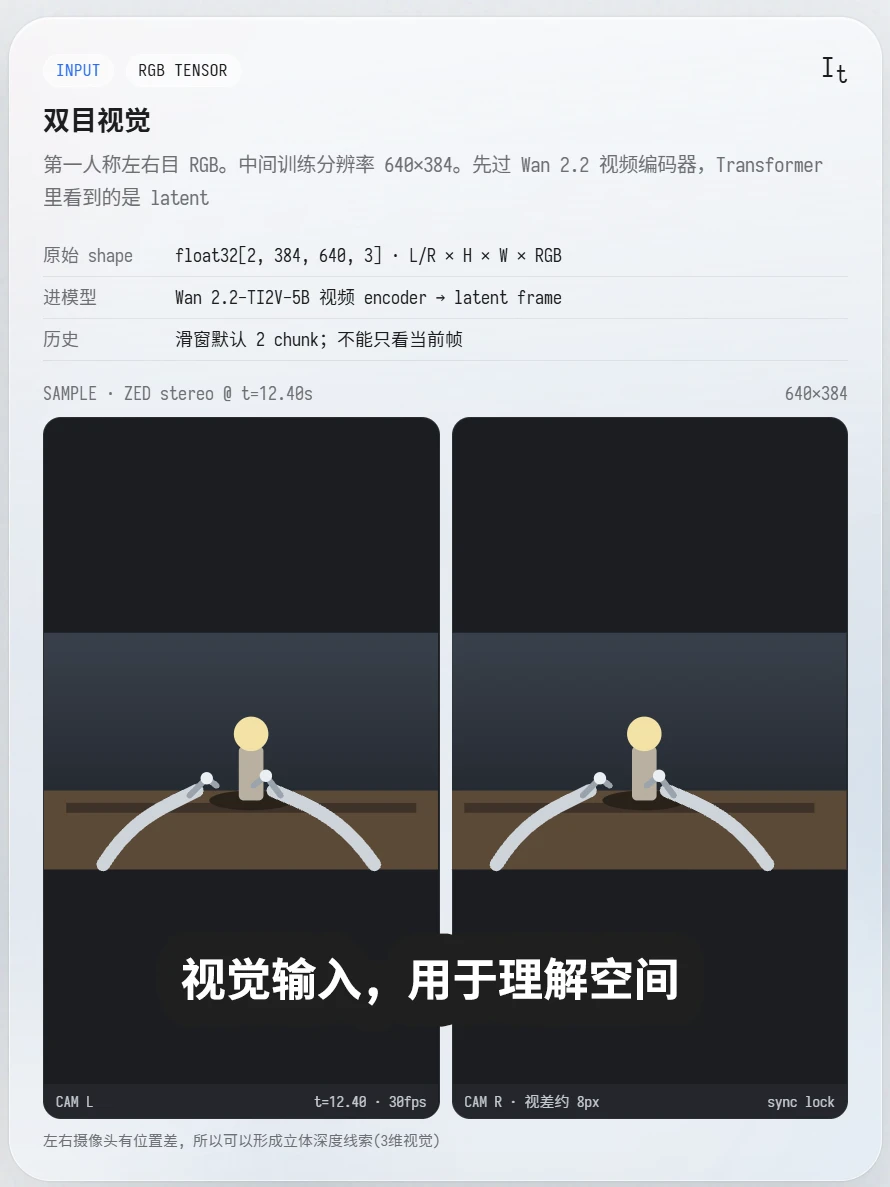
- 多视角/双目视觉流:双目摄像头第一视角相机画面(提供 3D 空间立体深度与周围环境)
- 指尖触觉信号:五指末端的触觉传感器数据(解决手掌遮挡时的盲区)
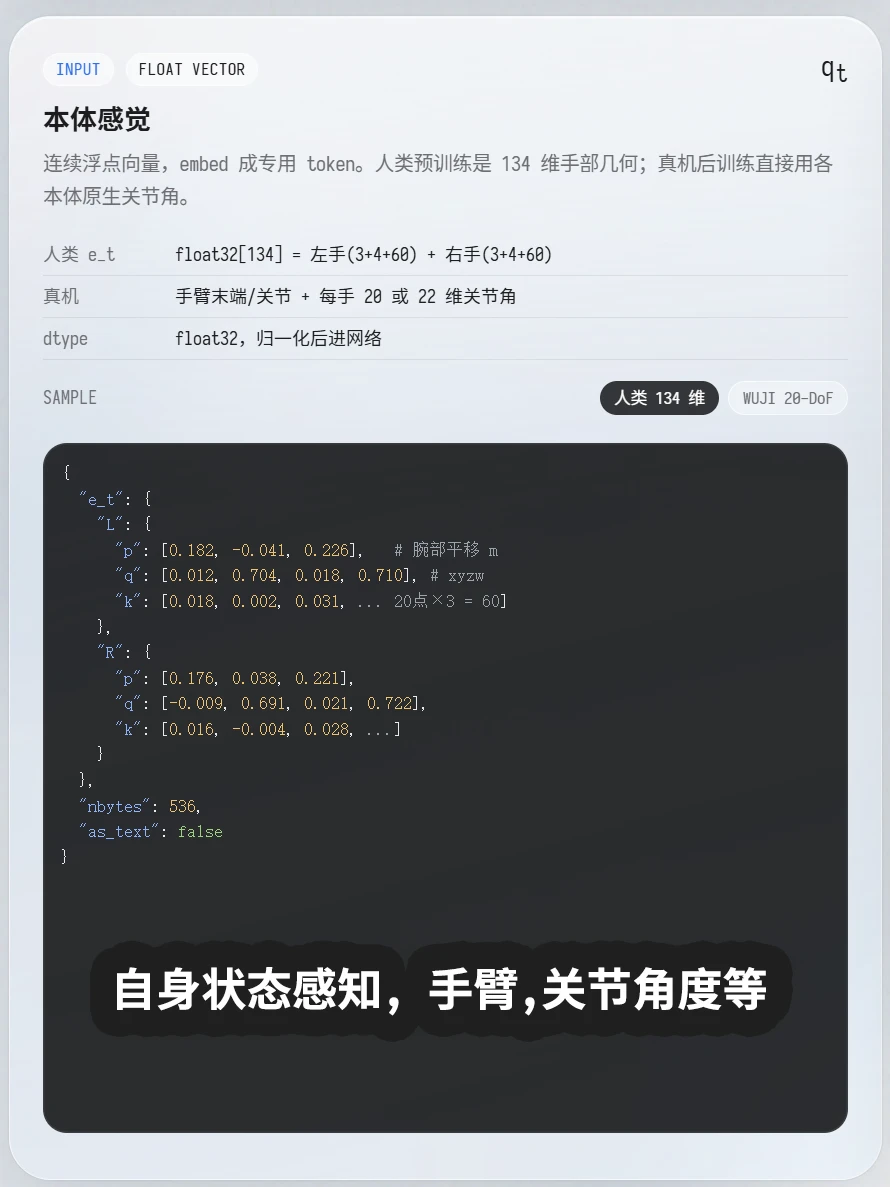
- 本体位姿状态:当前双臂和双手机械关节的实时角度, 速度
- 自然语言任务指令:比如把药瓶盖拧开并放到右侧托盘里
- 模式 A(策略动作输出):输出接下来一小段的关节控制轨迹块, 直接下发到底层电机驱动双手动作
- 模式 B(物理仿真输出):输入一段假设的动作, 它能在潜空间里生成未来几秒的预测视频(脑补:如果我这么抓, 瓶子会不会滑倒).
- 模式 C(价值打分输出):输出一个标量评分, 评估假设操作是会让任务成功, 还是把事情搞砸了
聪明的你看到输出其实就能猜到这个模型为什么这么猛了.Motus2 动手前, 会先让视频模型输出自己猜测的机械臂运动后的结果(脑子里有画面了!), 推演几次候选抓取方式, 通过打分模块挑出成功率最高的一套方案再去执行.
然后它还做了一个触觉专家. 人类在抓握物体的时候其实忽略了一点, 手掌覆盖的部分眼睛是看不见的! 为什么咱们人类并不会出现问题呢? 因为人类是有触觉的!
Motus2 专门设计了一个仅 30 层的轻量级触觉模型, 直接复用视觉大主干的缓存, 所以它不仅能实时感知是否抓到了物体, 还可以降低计算开销!
这个模型使用了 13 万小时的视频作为训练数据, 实现了三位一体的脑内推演, 甚至还有触觉感知, 迈出了具身智能从 L3「在世界中行动」跨向 L4「自主世界智能体」的关键半步.
最后强烈建议各位看它的论文原文 Motus2: A Self-Evolving General World Model for Dexterous Manipulation
#生数科技 #Motus2 #具身智能 #世界模型 #灵巧手 #多模态大模型 #强化学习