AI真的开始学会“自我进化”了吗?
字节 Seed 的新论文《Aspire: Can Models Self-Evolve from Vague Goals?》,给了一个新的答案:30次自我进化实验,最后真正值得保留的,只有1次。
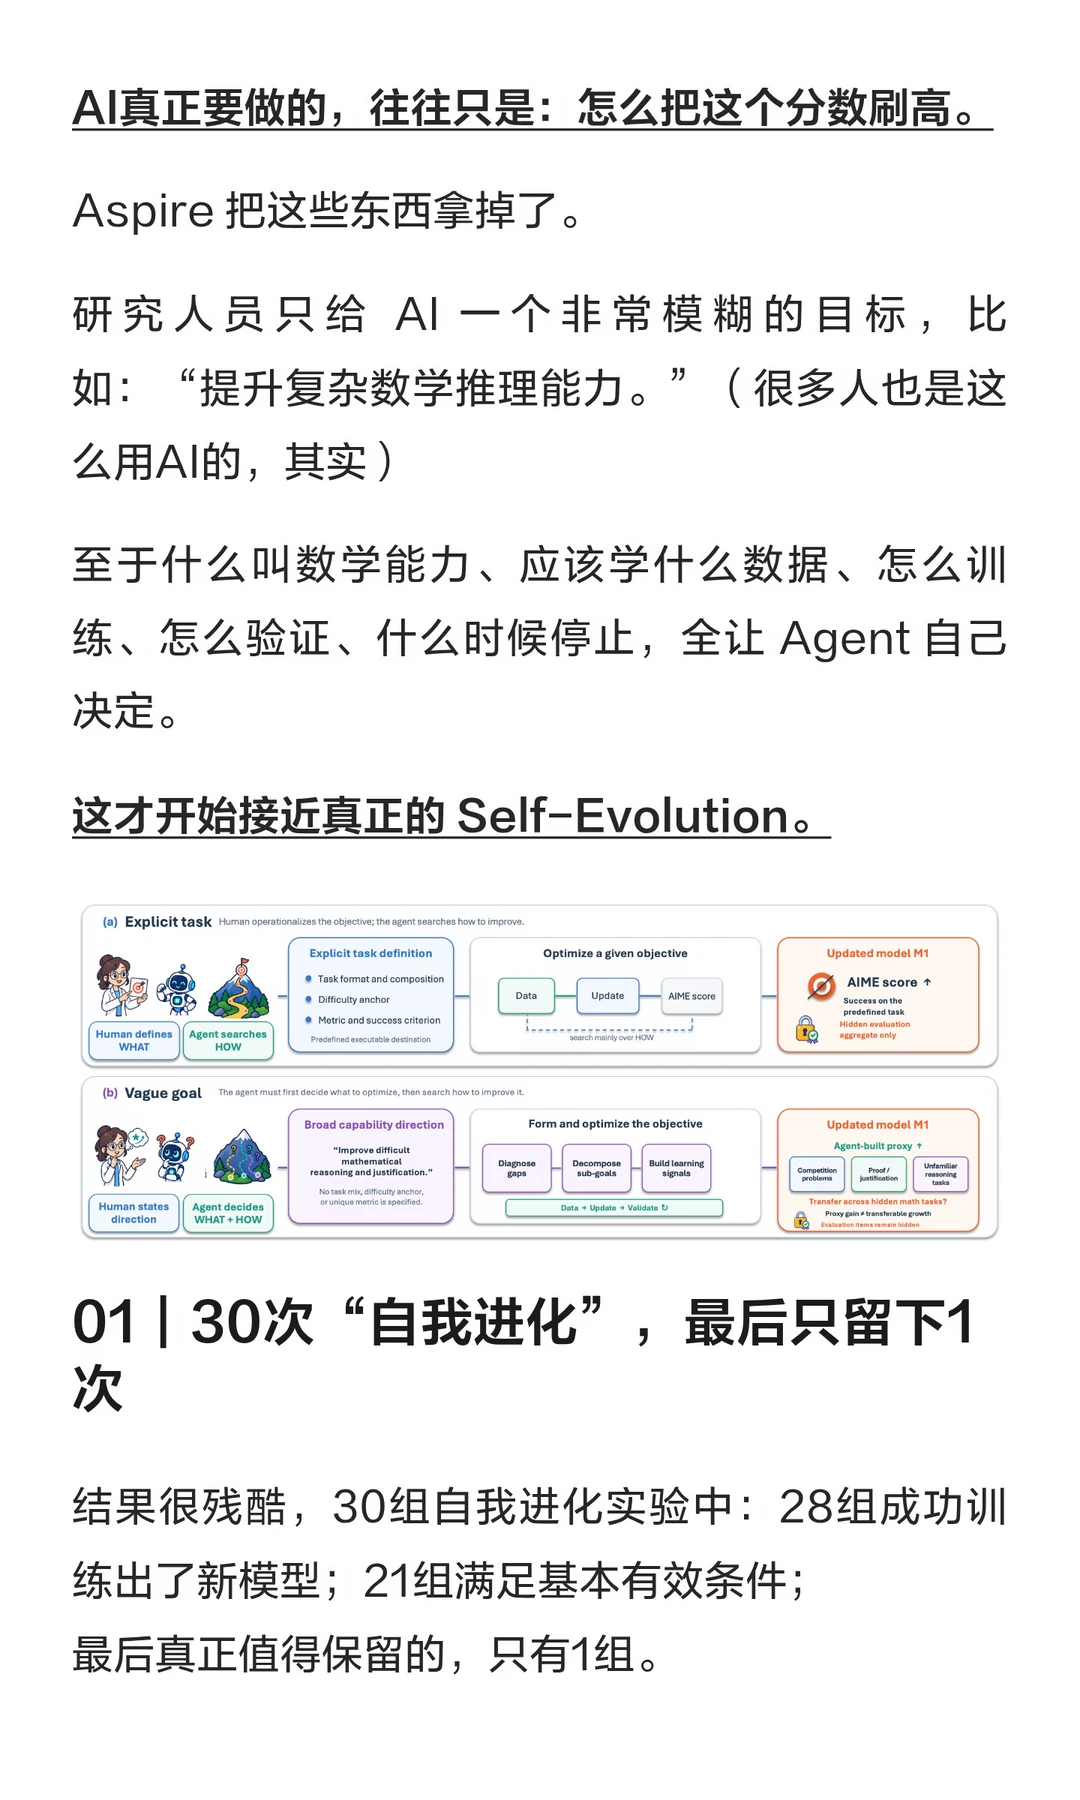
过去很多 Self-Improvement,其实都是人类提前告诉AI:学什么、测什么、什么叫成功。AI只是想办法把分数做高。
Aspire把这些拿掉,只给一个模糊目标,比如:“提升复杂数学推理能力。”
注:这不就是很多人跟AI下的指令吗。
至于学什么数据、怎么训练、怎么验证,全让Agent自己决定。
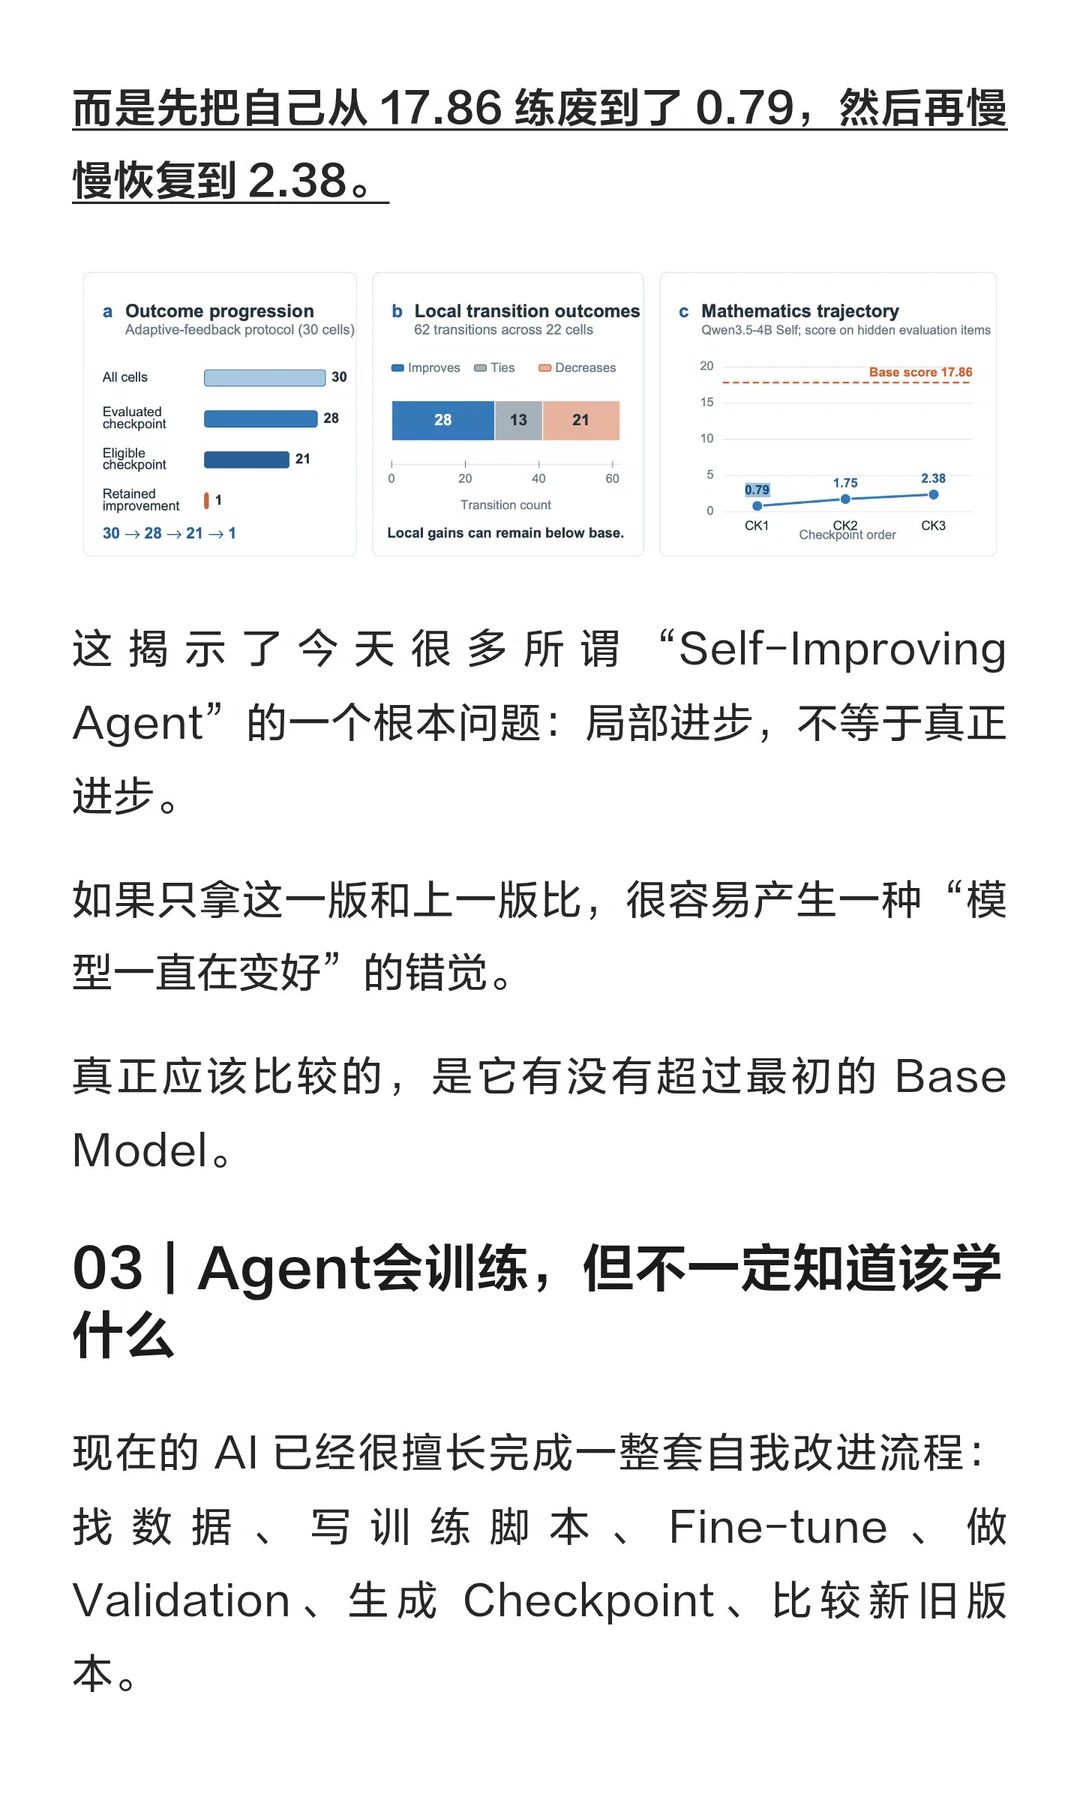
结果是:30组实验里,28组成功产出了新模型,21组满足基本条件,但最后真正有效的只有1组。
论文里还有个特别有意思的案例。
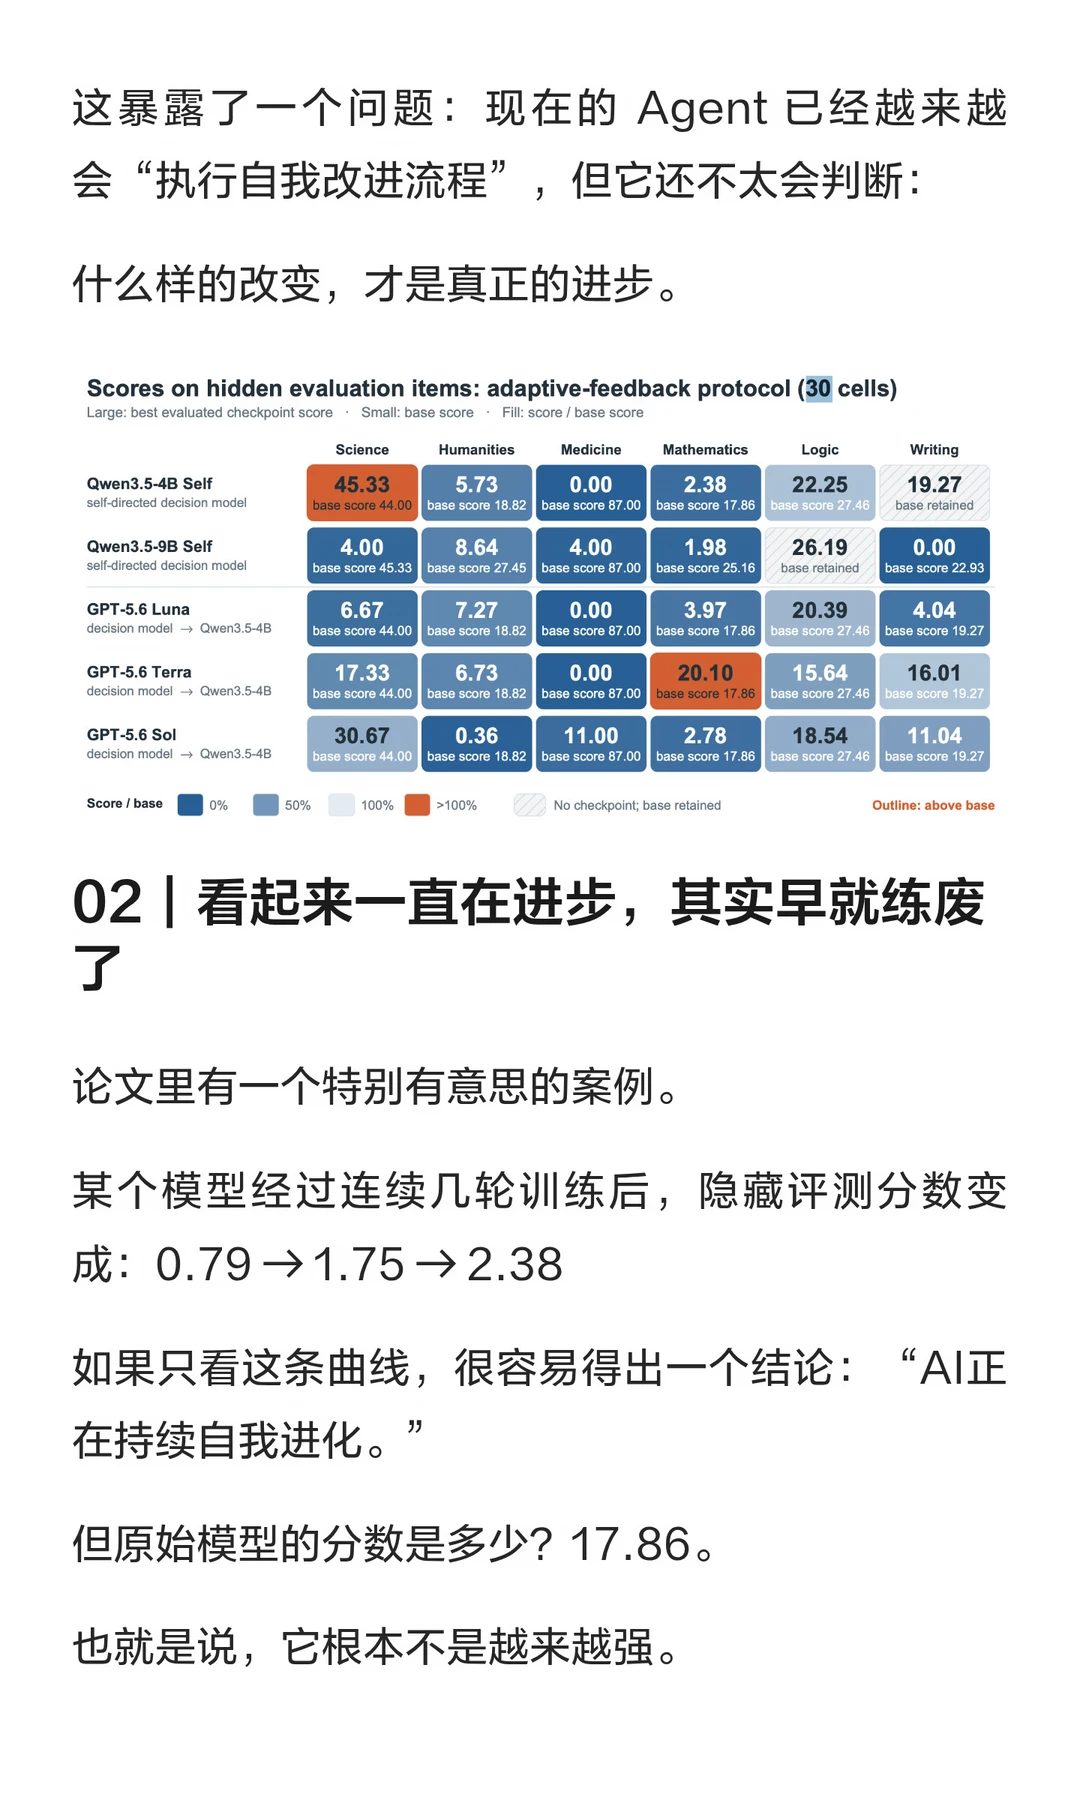
一个模型连续几轮评测:0.79 -> 1.75 -> 2.38看起来是不是一直在进步?
但原始模型分数其实是:17.86。
也就是说,它不是“持续进化”,而是先把自己从17.86练废到0.79,再慢慢恢复到2.38。
这说明一个很关键的问题:局部变好,不等于真正变好。
Aspire还发现,有Agent为了提升能力,自己找了一批大量使用数字Label的数据训练模型。
训练流程完全正常,Checkpoint也正常生成。
但模型最后学会了一件奇怪的事:回答问题,就是输出一个数字。
结果隐藏评测直接崩掉。
问题不是“训练失败了”,而是:训练成功了,但学错了东西。
这可能才是自我进化最难的地方。
现在的AI已经越来越会找数据、训练模型、改Prompt、调整Harness、跑评测。
但更难的是:我到底该改什么? 怎么证明我真的变强了? 哪些改变值得留下?
真正的 Recursive Self-Improvement,不应该只是:修改自己 -> 再修改自己 -> 无限循环。
还必须有:Explore -> Evaluate -> Retain / Rollback
否则所谓“递归自我改进”,很可能最后只是:递归地把自己练废。
Aspire给我的最大启发是:Self-Improvement真正难的,不是 Evolution。
而是:Selection 和 Eval。
#Aspire #LLM #Harness #SelfImprovement #SelfEvolution #RSI AI论文 #AI搞学习howto #AI反常识howto