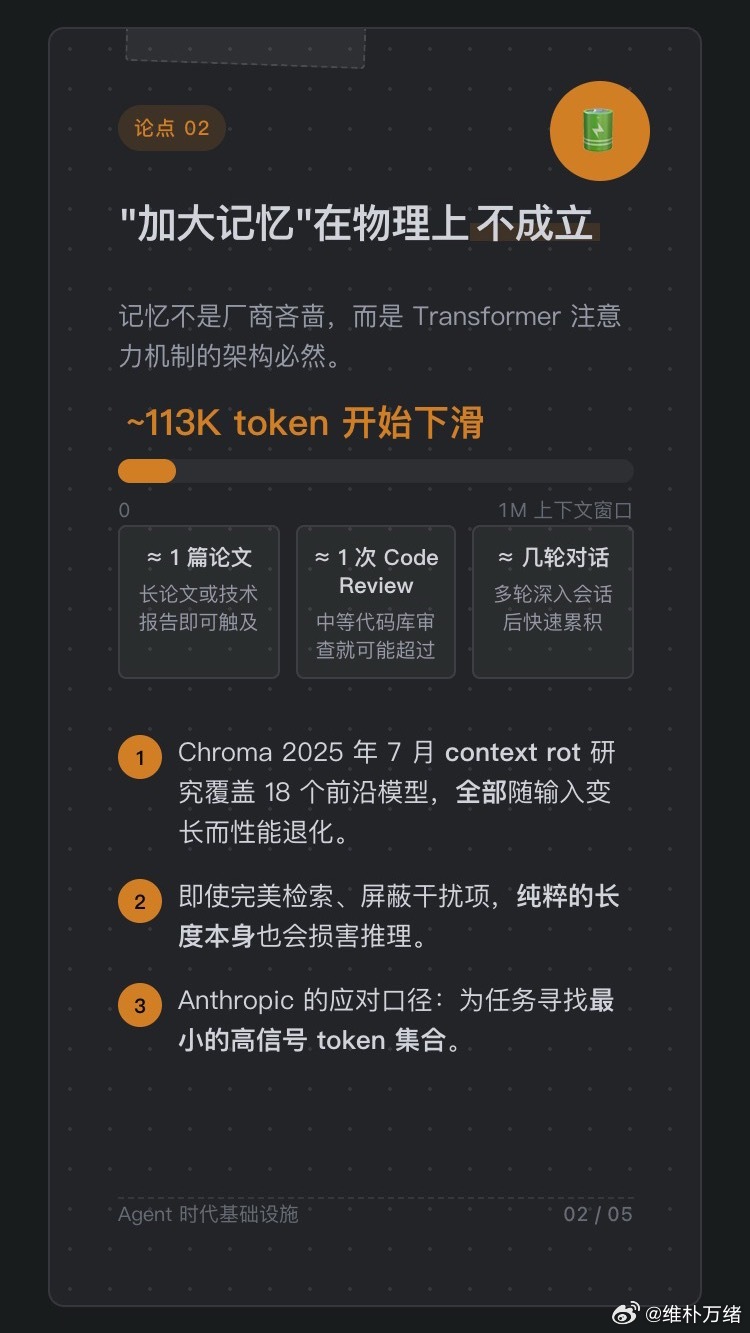
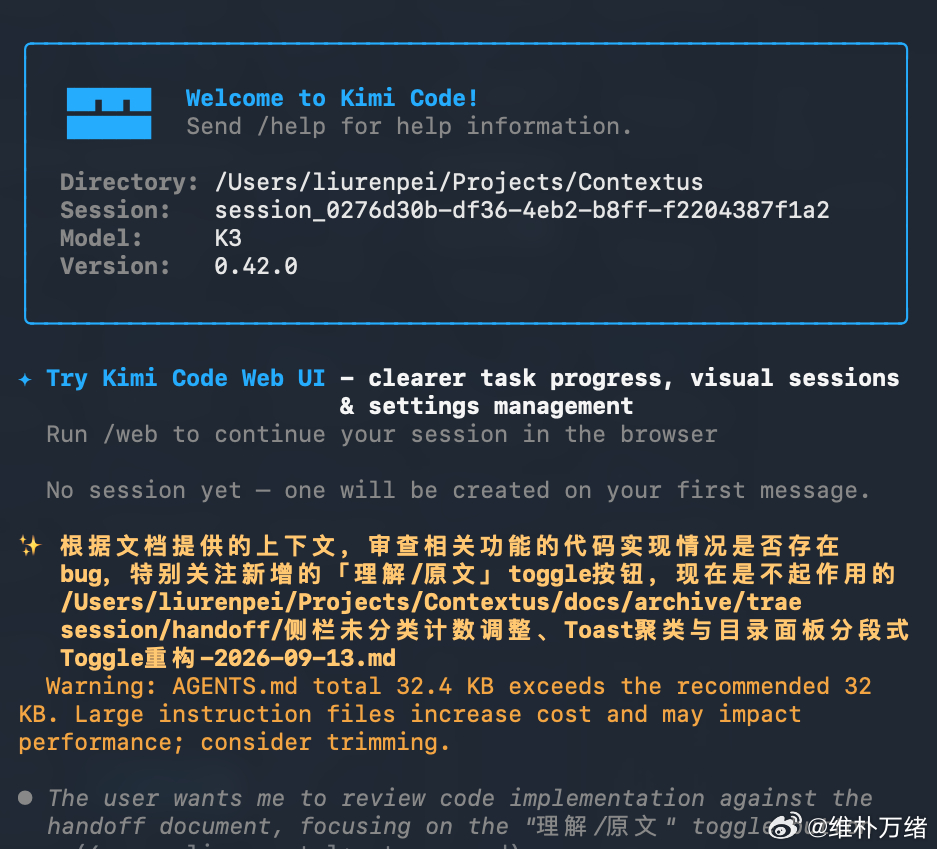
【agent 记忆预算告警】今天kimi code的开屏警告:AGENTS.md 文件总大小为 32.4 KB,超过了建议的 32 KB 上限。过大的指令文件会增加成本并可能影响性能。这启发我大胆假设:绝大部分ai agents 对用户偏好的记忆都极其有限、边际效益递减,且用户难以手动调校。因为目前绝大多数 AI 产品的"记忆",根本不是模型内部的状态,而是每轮会话重新注入的上下文文本。
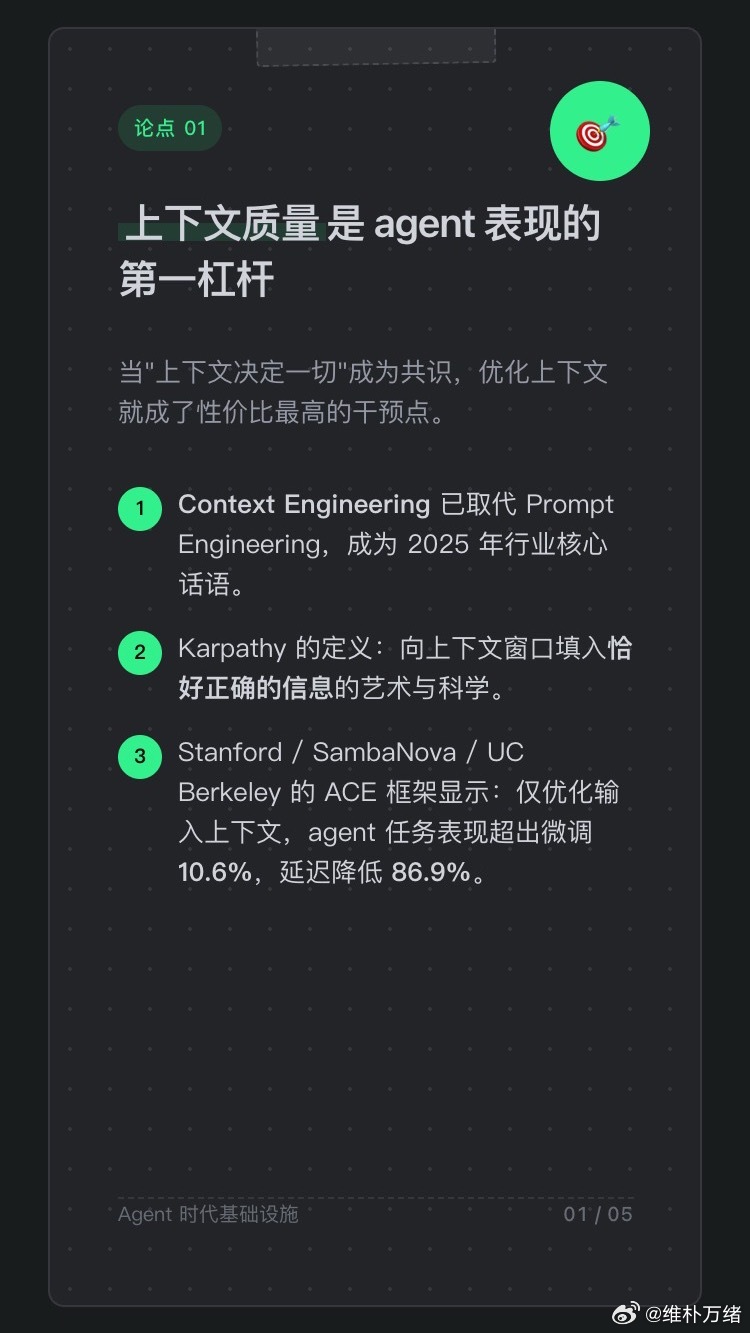
◆为什么"记忆"必然边际递减?1. 成本是线性且重复的。 注入式记忆(AGENTS.md、用户画像、偏好快照)在每一轮对话都要重新计 token 费。33 KB 的文件不是一次性成本,而是每次会话、每个 turn 都在付费。一条记忆的价值是固定的,成本却随调用次数无限累积——只有当它高概率被用到时才划算。2. 注意力会被稀释。 上下文越长,模型对其中任何一条指令的遵循度都在下降("lost in the middle" 现象)。第 50 条偏好不仅自己可能被忽略,还会拉低前 10 条高价值偏好的生效概率。所以边际收益不只是递减,超过某个点后会变负——新增记忆在损害已有记忆。3. 记忆之间会互相冲突。 积累得越多,条目间语义重叠和隐含矛盾的概率越高,模型需要在冲突指令间做取舍,行为反而变得不稳定。
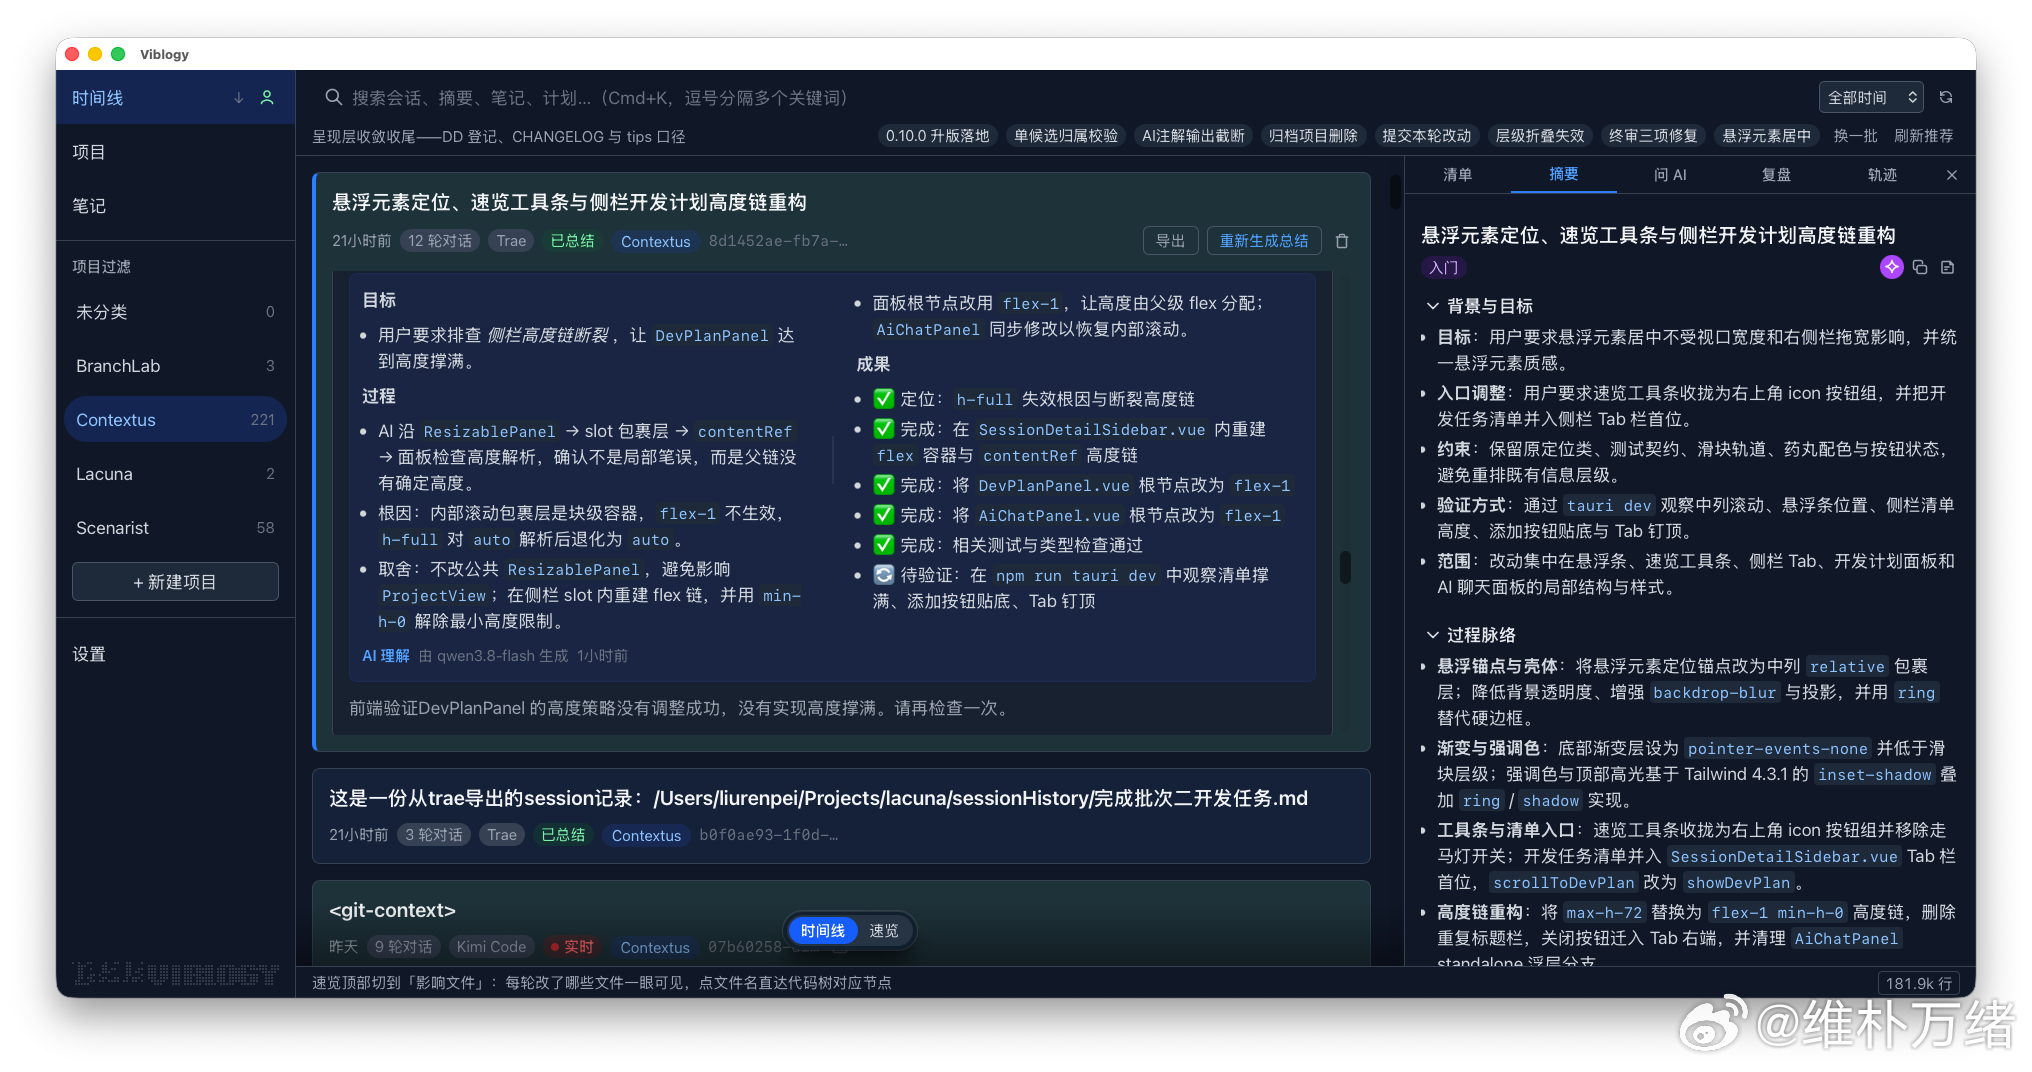
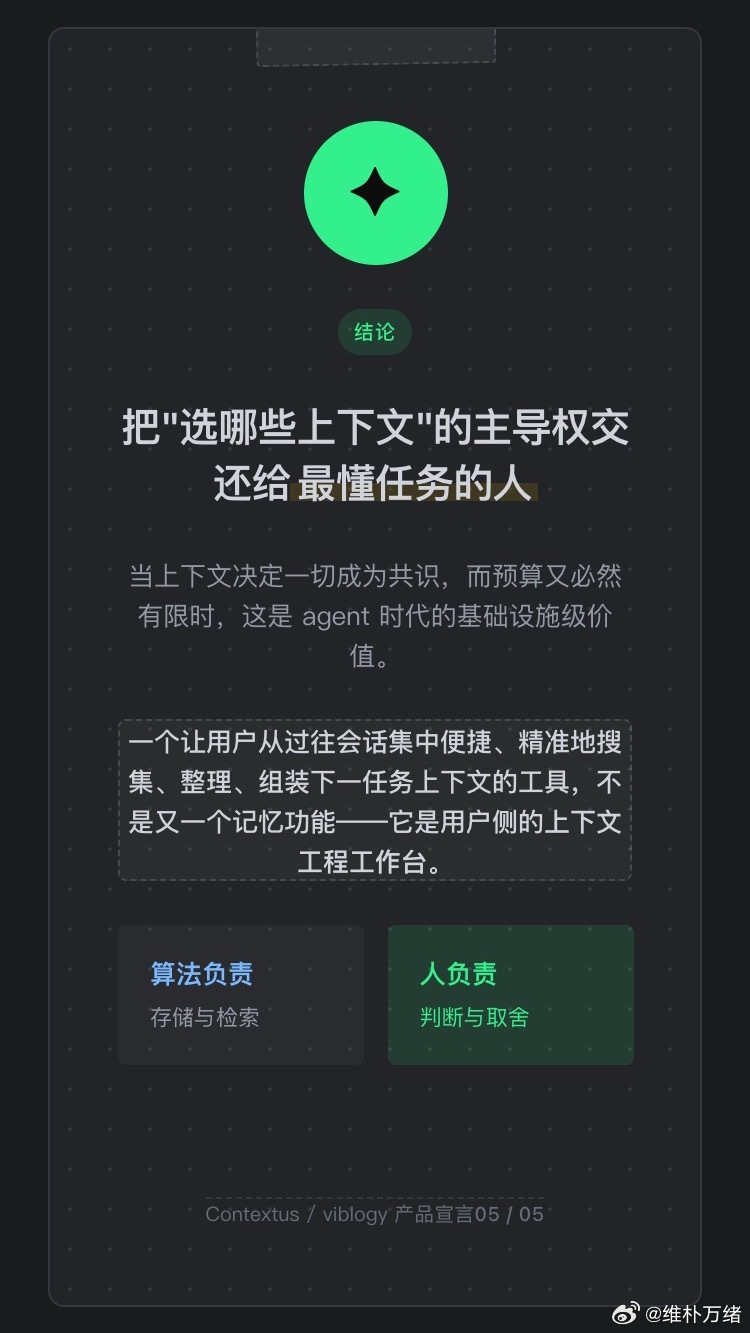
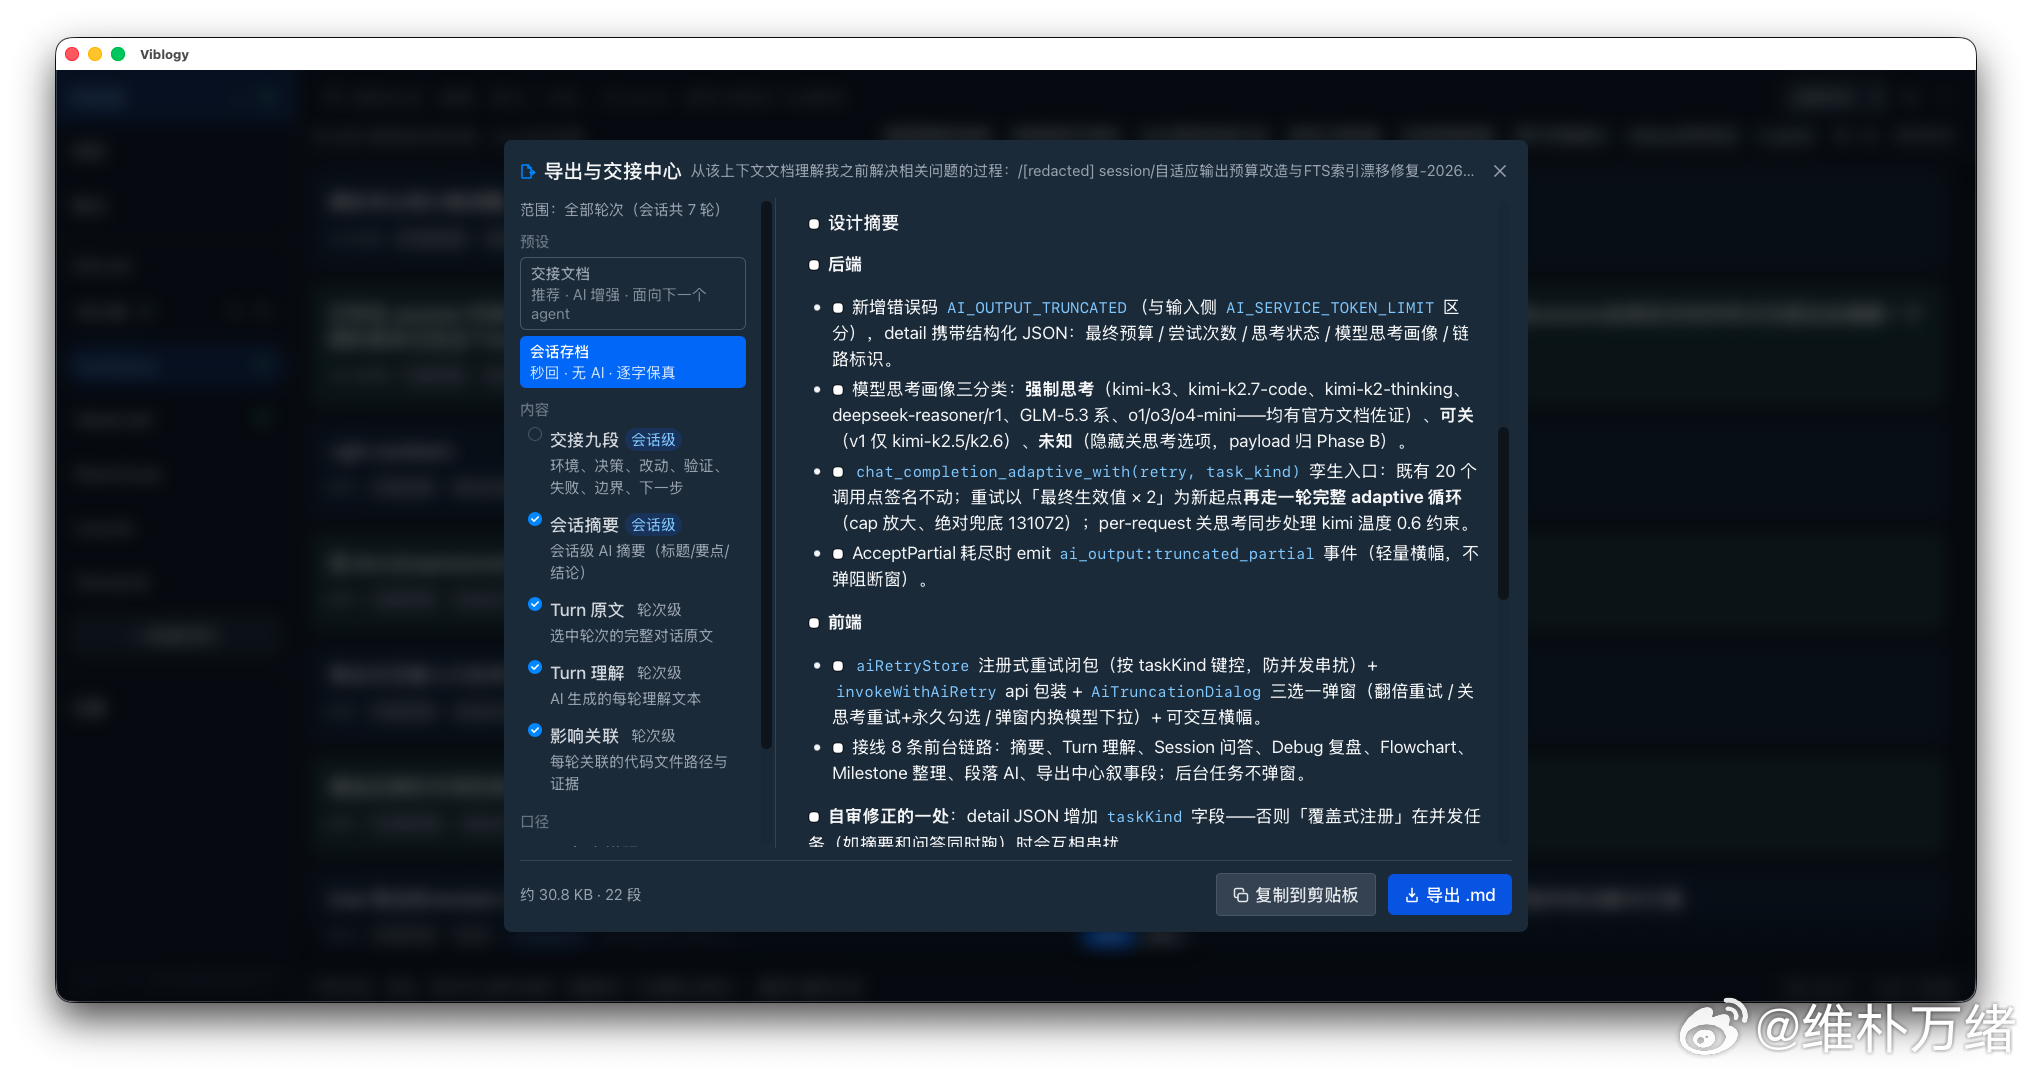
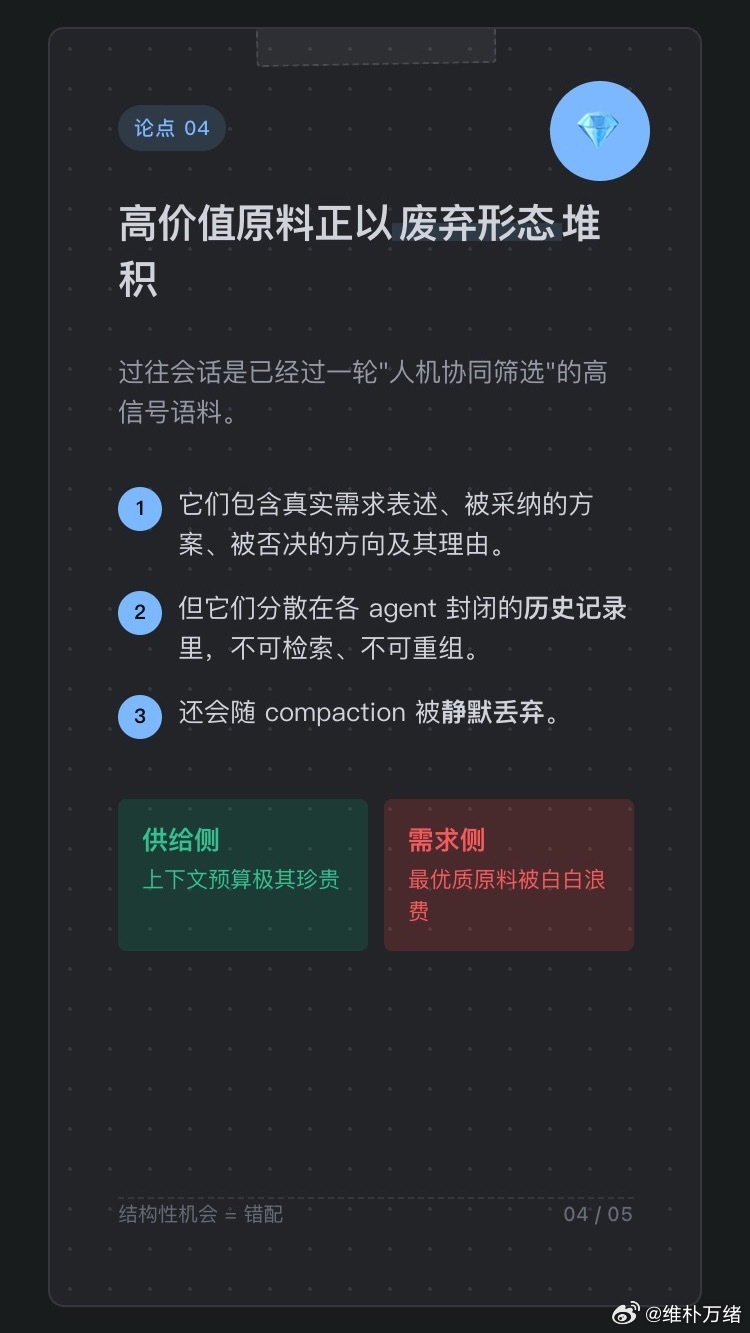
◆若能让用户便捷、精准地在过往的会话集中,搜集整理出下一个任务所需的上下文,将使vibe-coding 每次会话起步更快、更省token、更好控制。(其实也就是我开发的viblogy 最擅长干的事情)1. 省重复劳动:不用每开一个新任务就把项目背景、决策理由重新打一遍字。2.接手质量更高:AI 的表现很大程度上取决于喂给它的上下文,你给得准,它就做得对——这比换更强的模型便宜得多。3. 选择权在你手里:哪些历史相关、哪些该带走,你说了算,不依赖平台那个看不见、调不动的"自动记忆"。4. 花出去的钱不浪费:每段对话都是付过 token、磨过几十轮的成果,存下来就是可复用的知识库,而不是用完即弃的聊天记录。5. 换工具不受制:会话存在你自己机器上、导出成通用 Markdown 文件,将来换任何 AI 工具,积累都带得走。人工智能vibecoding程序员