最近看了一篇很有意思的 Agent Memory 论文:《Compact-Memory LLM Agents via Online Max-Member Clustering and Atom-Aware Packing》
它让我重新想了一个问题:为什么 Agent 明明“记得”,最后还是会答错?
原因可能不只是检索记忆。
更大的问题是:记忆找回来之后,你怎么摆给模型看。
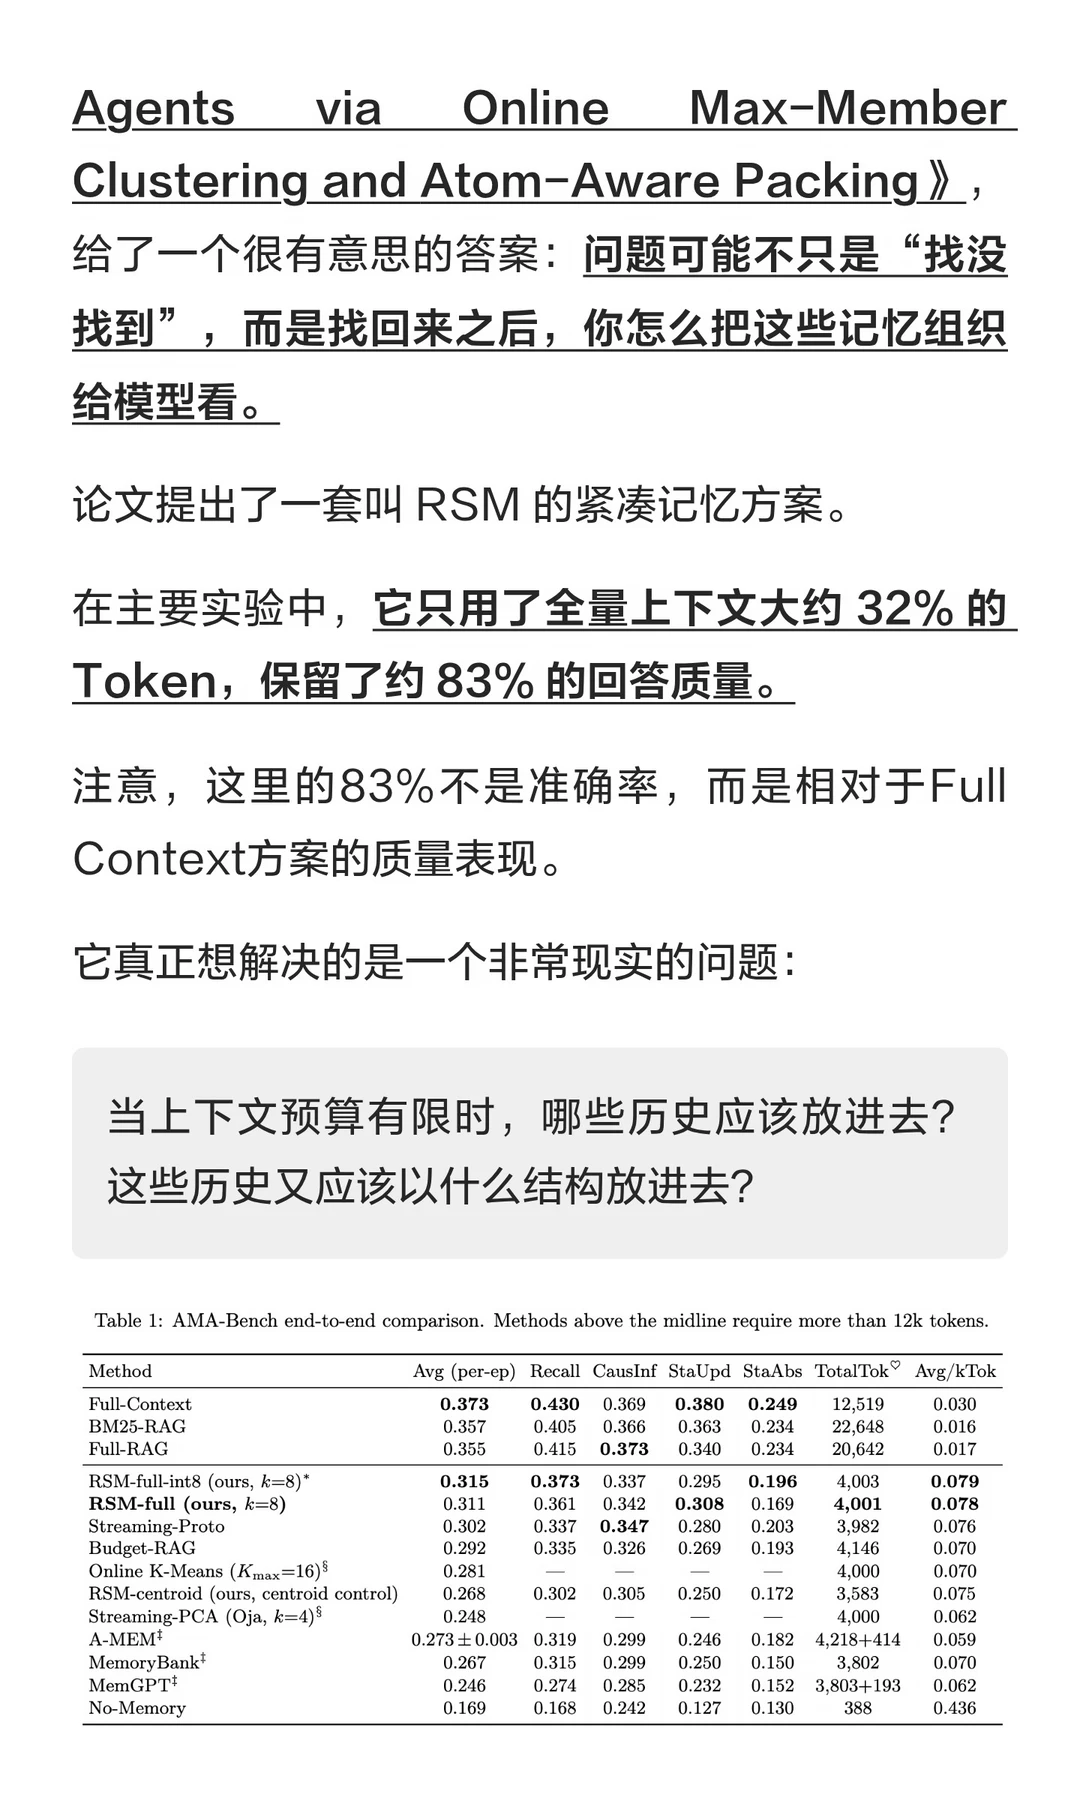
论文提出了一套叫 RSM 的方法,它只用了 Full Context 大约 32% 的 Token,却保留了相对全量上下文方案约 83% 的回答质量。
它主要做了两件事。
1️⃣ 记忆不要只按“平均相似度”归类。
传统聚类通常会拿一条新记忆和整个簇的中心向量比较。
但现实里,一组记忆可能包含:项目计划、接口问题、验收结果、修改记录、最终结论。
新来的“补验结果”,可能和整个簇的平均语义并不特别像,但它和其中某条“验收失败”记录非常接近。所以 RSM 不只比较簇中心,还会看它和簇内具体成员是否相似。
2️⃣,我觉得更重要的一点
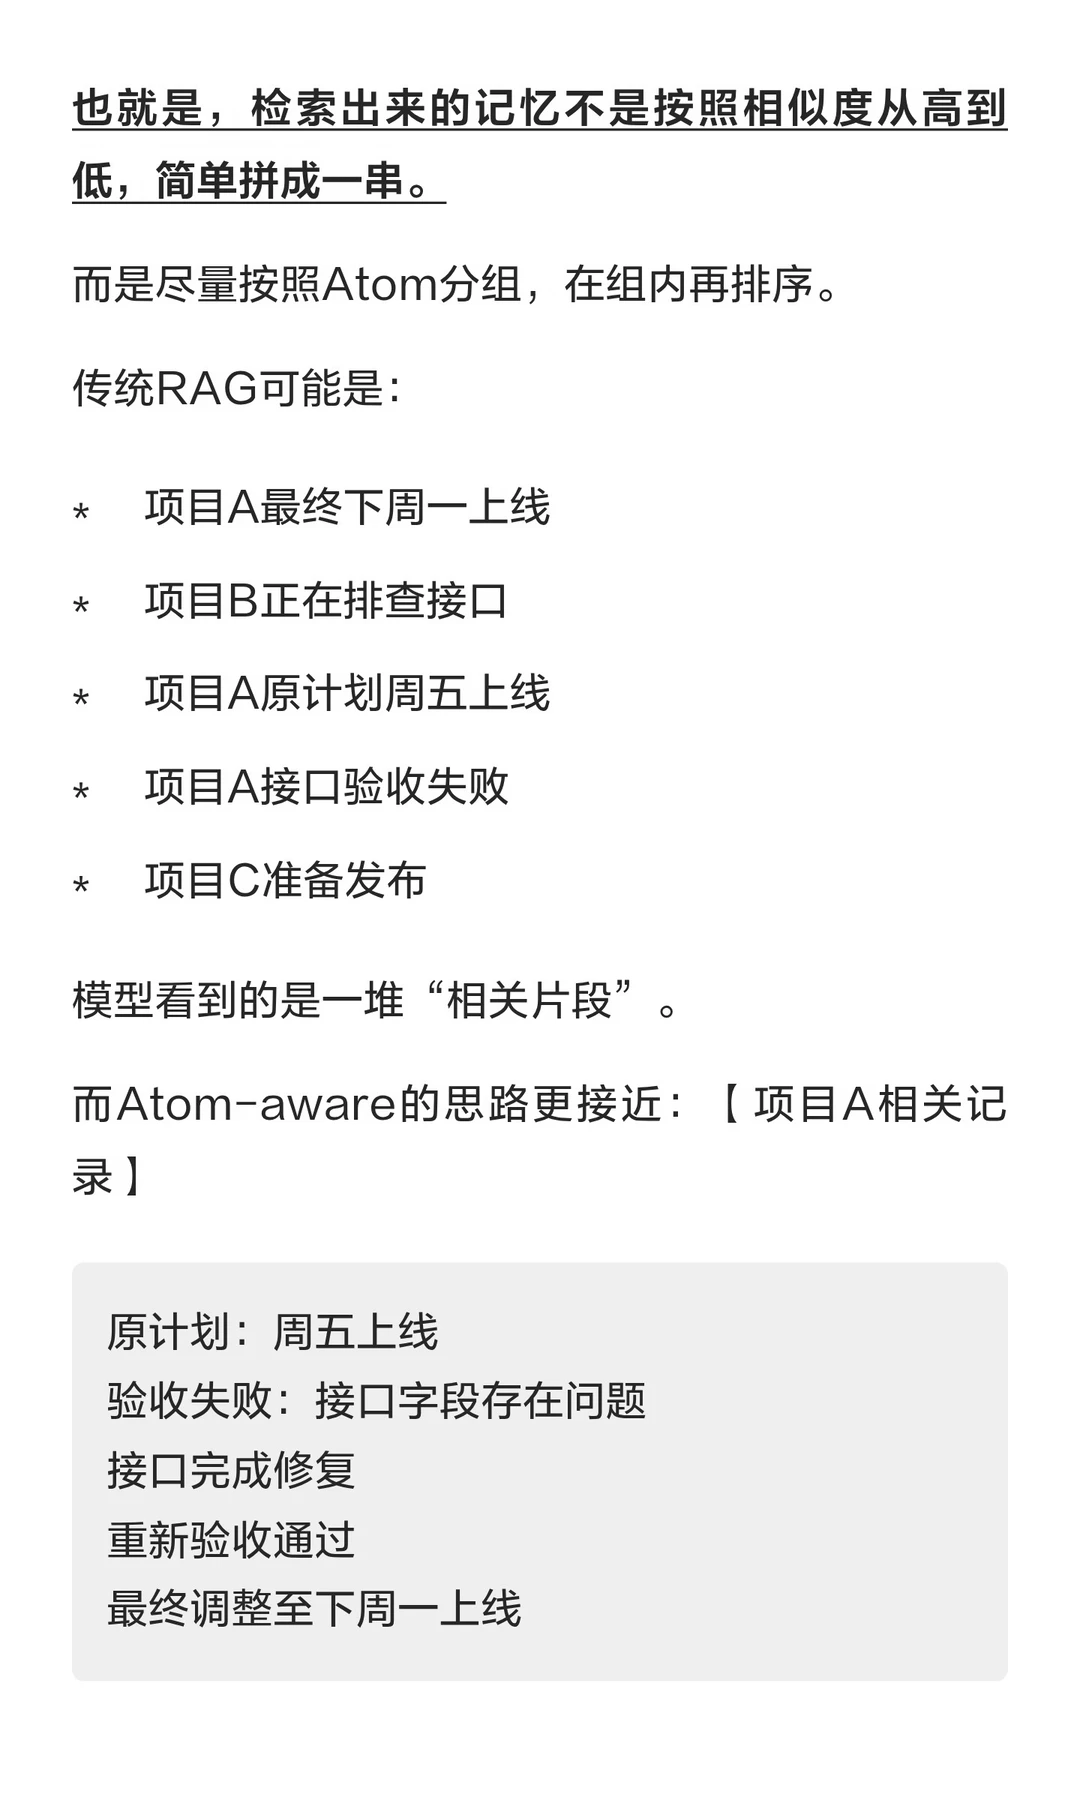
检索出来的记忆,不要全部摊平成 chunk1、chunk2、chunk3。
传统 RAG 经常是:检索 Top-K -> 按相关性排序 -> 全部拼到 Prompt -> 让模型自己理解
RSM 则会尽量按照 Atom 分组,再组织到上下文里。
也就是说,它不只是回答:“哪些记忆相关?”,还在回答:“哪些记忆本来就是一组?”
这对现在做 Agent 的人很有启发。
我们经常花很多时间升级:Embedding、Vector DB、Hybrid Search、GraphRAG……
结果最后还是:chunk1 chunk2 chunk3 chunk4,然后全部扔给大模型。
前面搞得很复杂,最后一步却只是字符串拼接。
所以我越来越觉得,未来 Agent Harness 里应该有一个独立组件:Context Builder,找到合适的 Memory 把上下文拼装起来。
因为对 Agent 来说:记住,不等于会用。
#Agent记忆 #AIAgent #AgentMemory #Harness #LLM #RAG #ContextEngineering #AI论文 #AI搞学习howto