基于公开信息选择国产Coding Plan
Arena.ai 分析了2026年5月1日–9月2日的30,086 组真实用户问题下的大模型对战回答,试图回答一个很有意思的问题:两个模型面对同一提问时想法的重合程度到底有多大?结合最近的A社报告,我们很容易就会想到,相似度是否代表了蒸馏程度?
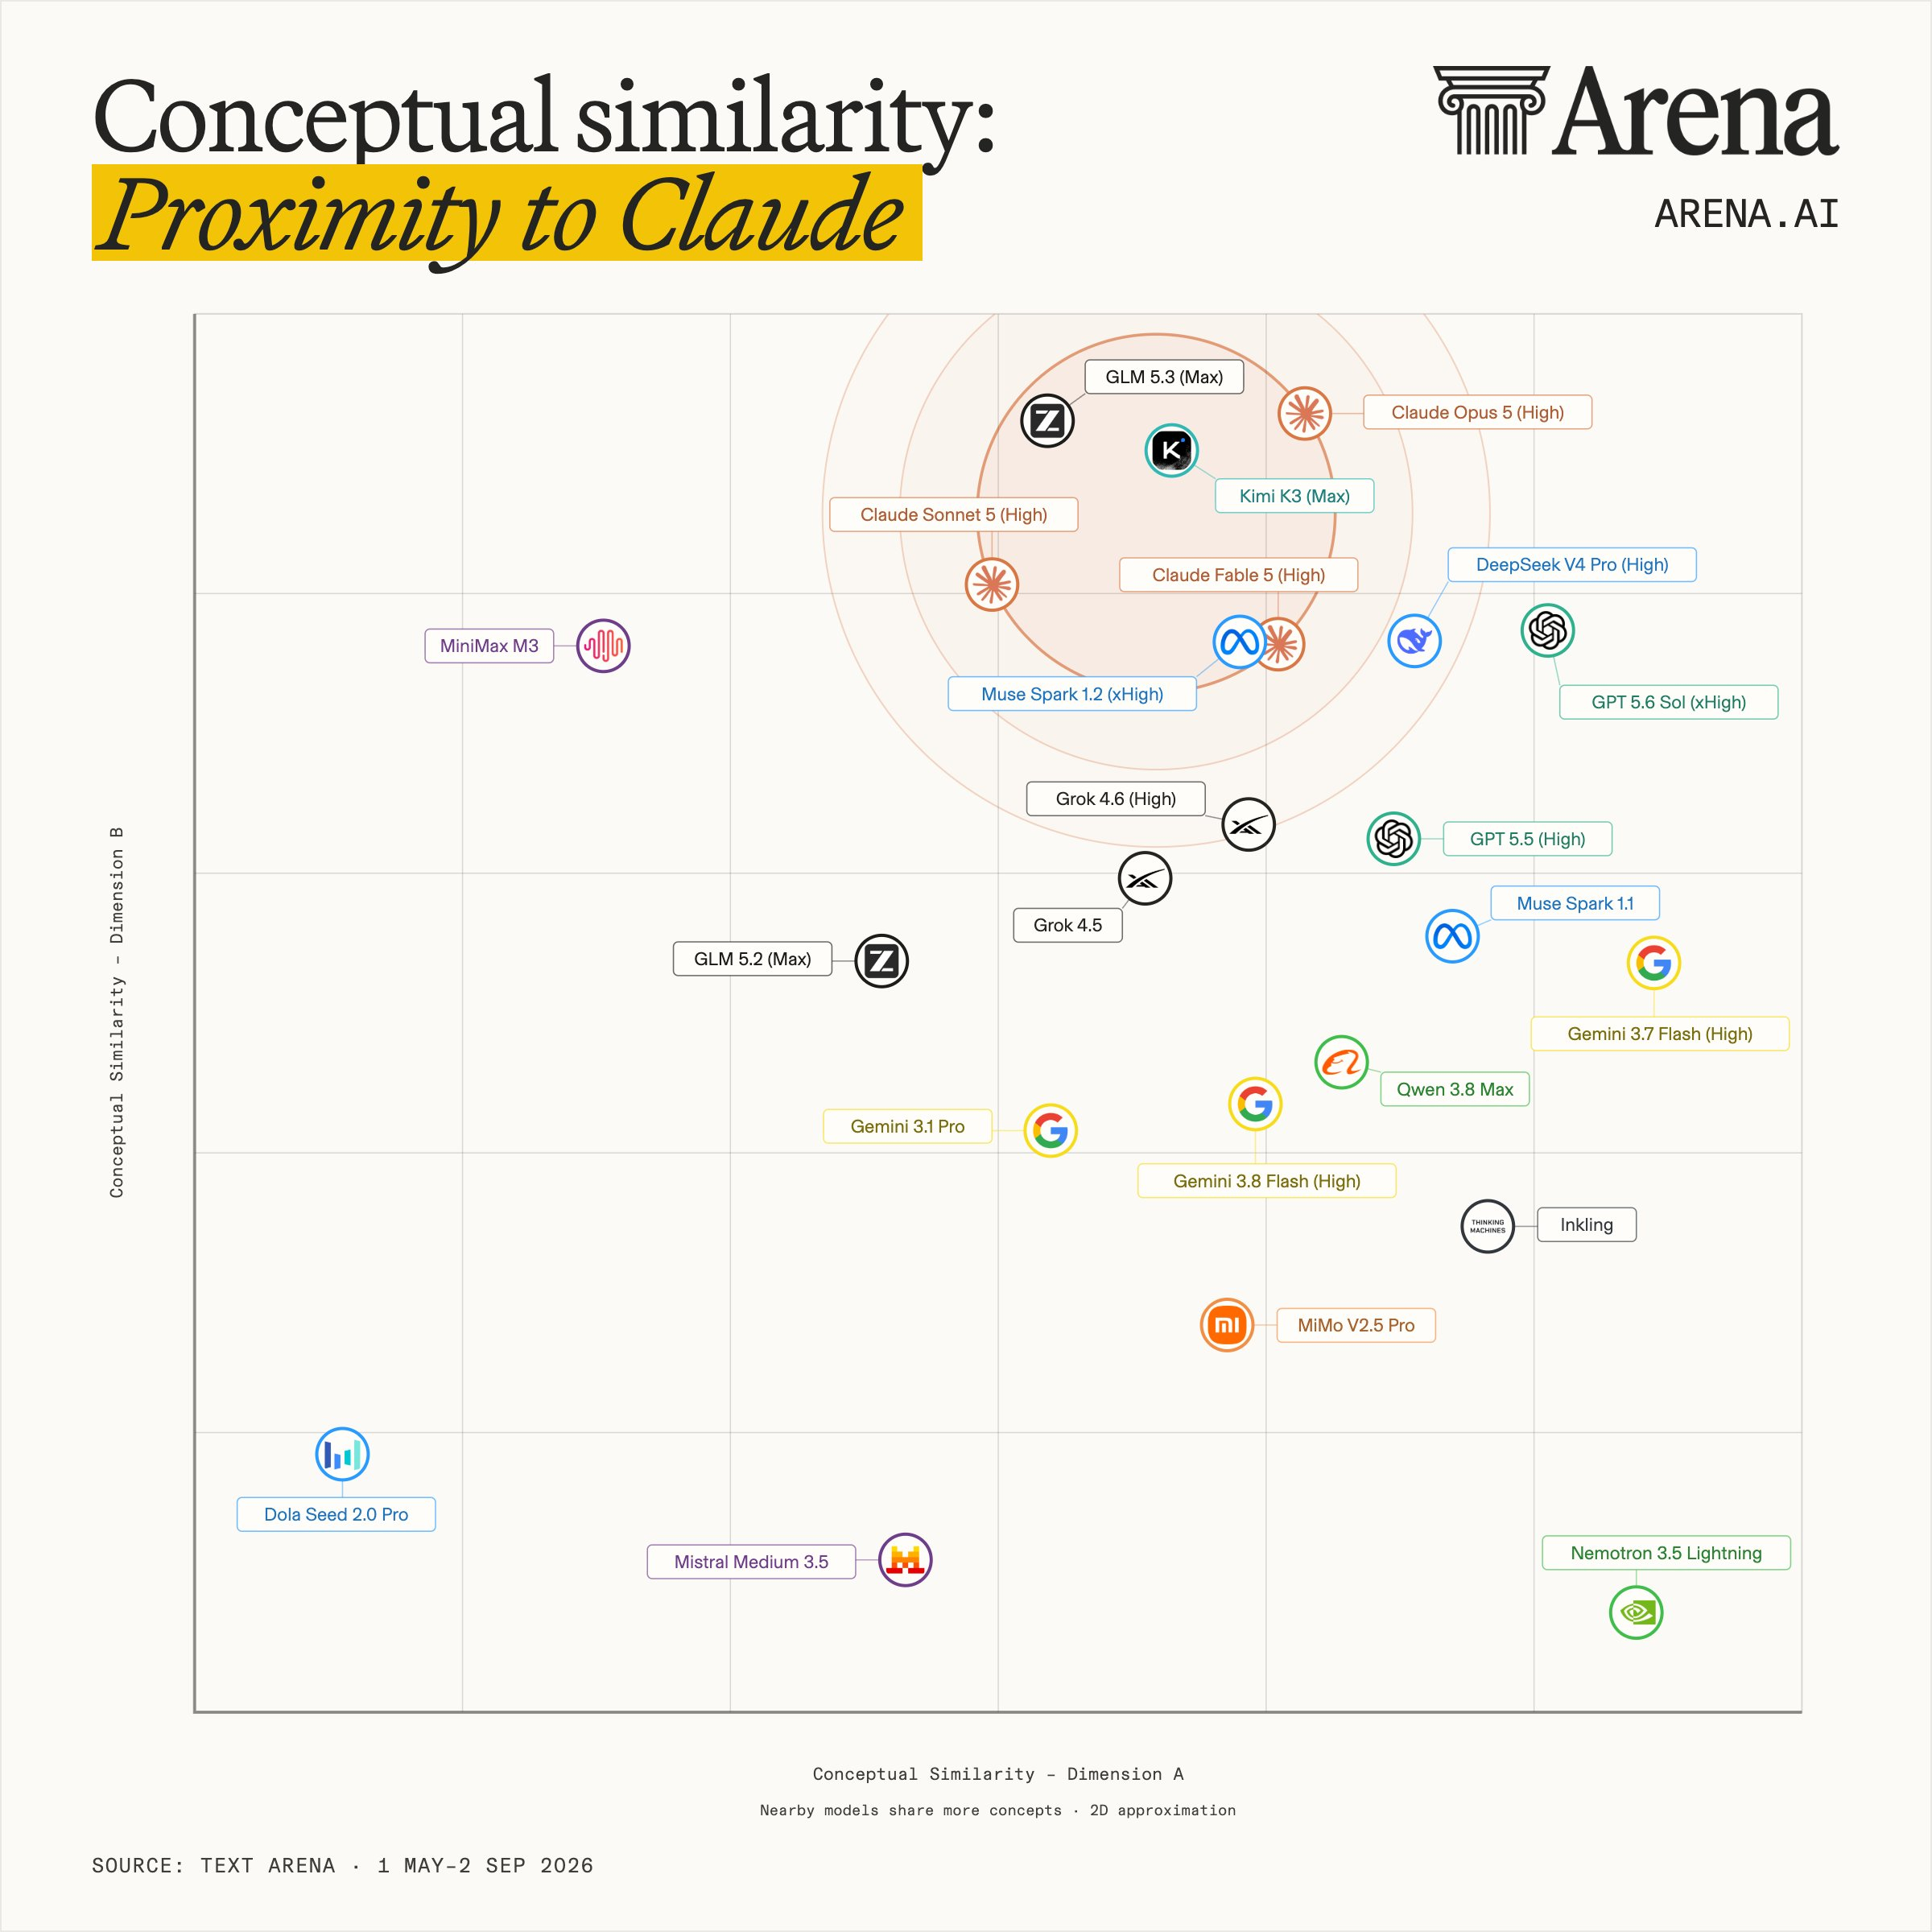
• 1.整体规律:大模型之间相似度比想象中低,平均只有 43.1% 的观点重合。•2.同门规律:同门代际最像,最容易“互相重复”。Grok 4.5 vs 4.6:59.7%GPT 5.5 vs 5.6:59.2%•3.两国规律:中美模型并没有显著不同。GLM、Kimi、Claude Opus、Sonnet反而聚集在同一个高重合区域。例如 Fable 5(2026-06-09发布) 与 GLM 5.3( 2026-08-14发布) 的观点重合度达到 55.9%。最像的一对:Kimi K3 vs Muse Spark 1.2=63.5%;最独特:字节Dola Seed 2.0 Pro,平均仅31.1%。看图就发现字节和老黄是一朵奇葩各表一枝。
相似度是否代表了蒸馏程度?如果是,那么作者其实是暗示:蒸馏Claude最成功的第一梯队是GLM、Kimi、Meta,第二梯队是Deepseek和Grok。如果说像就是蒸馏,那么很显然是Muse Spark 1.2(2026-08-05发布)蒸馏了Kimi K3 (2026-07-16发布),或者大家都蒸馏Claude反而导致彼此最像?
前面Arena.ai的报告证明GLM是最像Claude的模型,A社9月11日发布的报告(即使我们全盘相信A社单方面的说词)指控的7家AI公司里,论行为对用户的伤害程度,GLM可以说最少,几乎没有。将这两者一结合就能够拼出一个结论:
作为普通用户,如果你没有蒸馏洁癖,且你认为Claude的模型效果最好,那么现有的公开信息都指向:购买GLM的套餐是Claude的最佳平替,且不用担心自己的信息被不当使用。
Arena.ai的报告《The model most similar to Fable isn’t Opus. It’s not Sonnet either.》地址:网页链接