专家轨迹抄不得,抄了就掉分
给弱模型请了个专家老师,成绩不升反降。
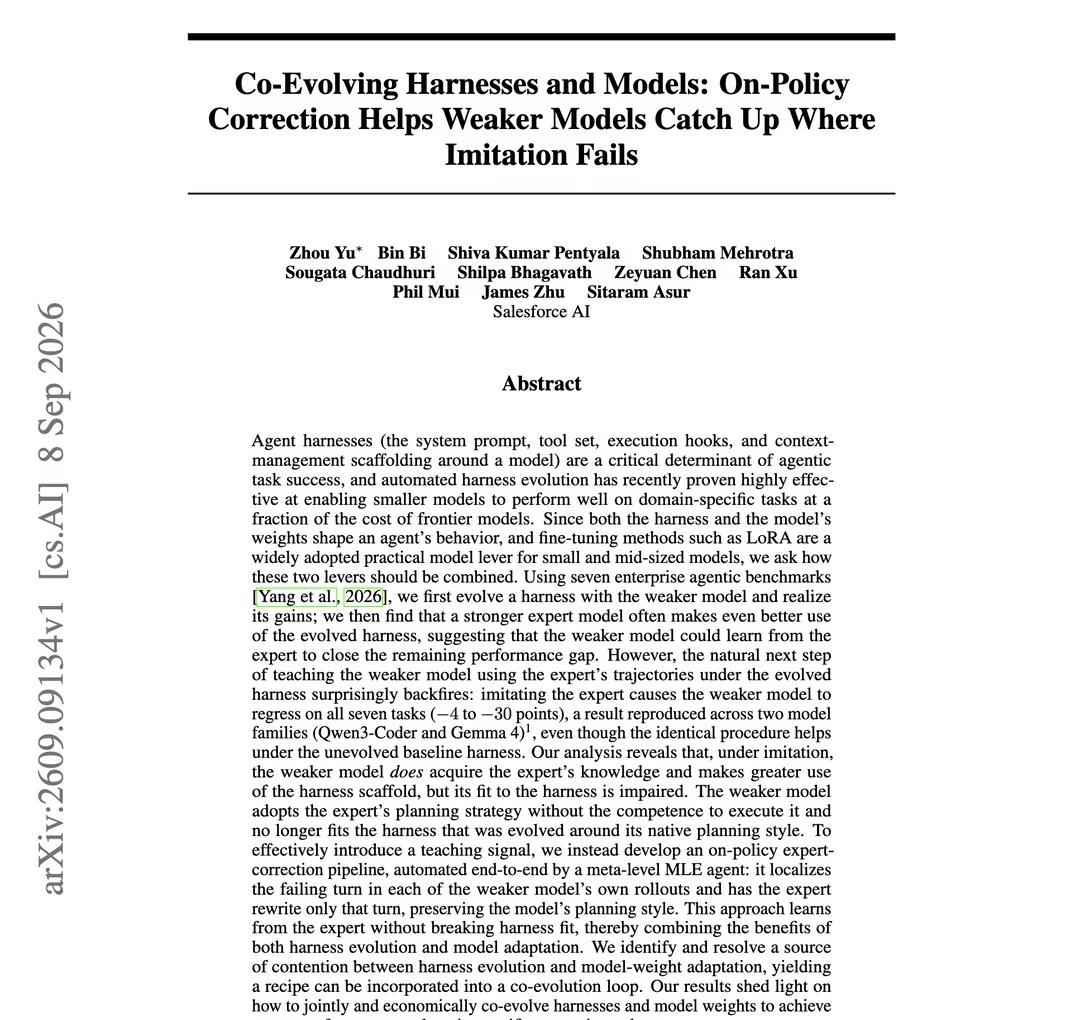
Salesforce 的新论文就撞上了这个反常识。他们先给一个较弱的模型自动进化出一套 harness(系统提示词、工具集、执行钩子、上下文管理那套外围脚手架),在 7 个企业级 agent 任务上拿到了提升。接着想再进一步——让更强的专家模型在同一个 harness 下跑出完整轨迹,拿来给弱模型做模仿微调。
结果 7 个任务全部下滑,Qwen3-Coder 和 Gemma 4 两个家族都复现,掉了 4 到 30 分——微调成了负优化。
蹊跷的地方在于,同一套微调放在没进化过的 baseline harness 下反而有效。坏的不是微调本身,是组合方式。
论文的分析指向「模型-harness 匹配度」。模仿确实让弱模型学到了专家的知识,scaffold 用得也更多了;可它把专家的规划策略整个端了过来,执行能力却跟不上。更要命的是,harness 本来是围着它自己原生的规划风格进化出来的,风格一变,匹配就断了。
修法很巧:别抄整条轨迹。
一个元层 agent 去弱模型自己的 rollout 里定位失败的那一轮,只让专家重写这一轮。模型自己的规划风格保住了,专家的知识也补上了。这篇管它叫 on-policy correction,整条流水线由 MLE agent 端到端自动化,harness 进化和权重更新两边的收益同时拿到。
给做 agent 的启示挺直接。harness 和模型不是两个独立的旋钮,先改 harness 再换模型思路,小心把配套磨掉了;要给模型「补课」,改它错的那一步,比整卷抄答案靠谱。
𝕏@omarsar0
AIAgent
大模型
强化学习
Harness
AI研究