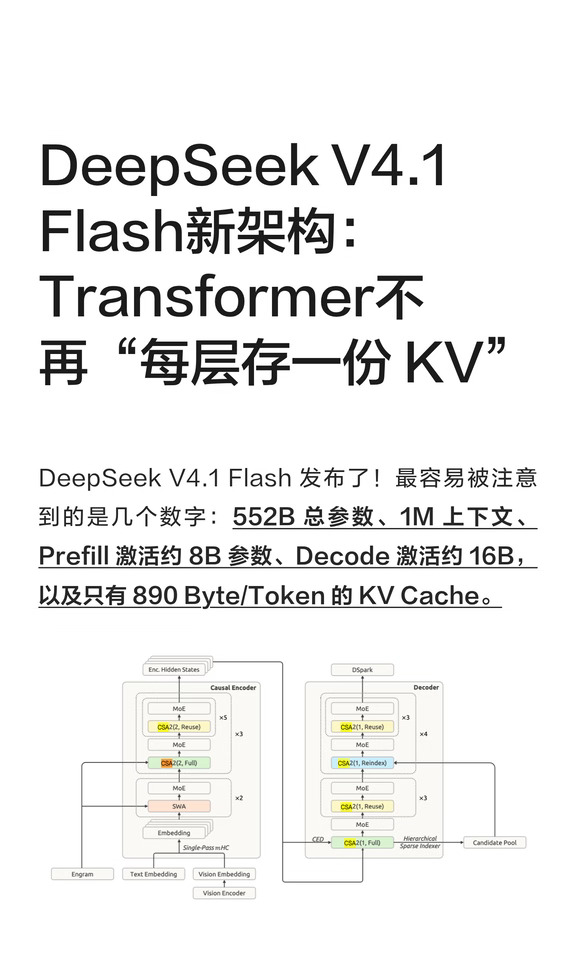
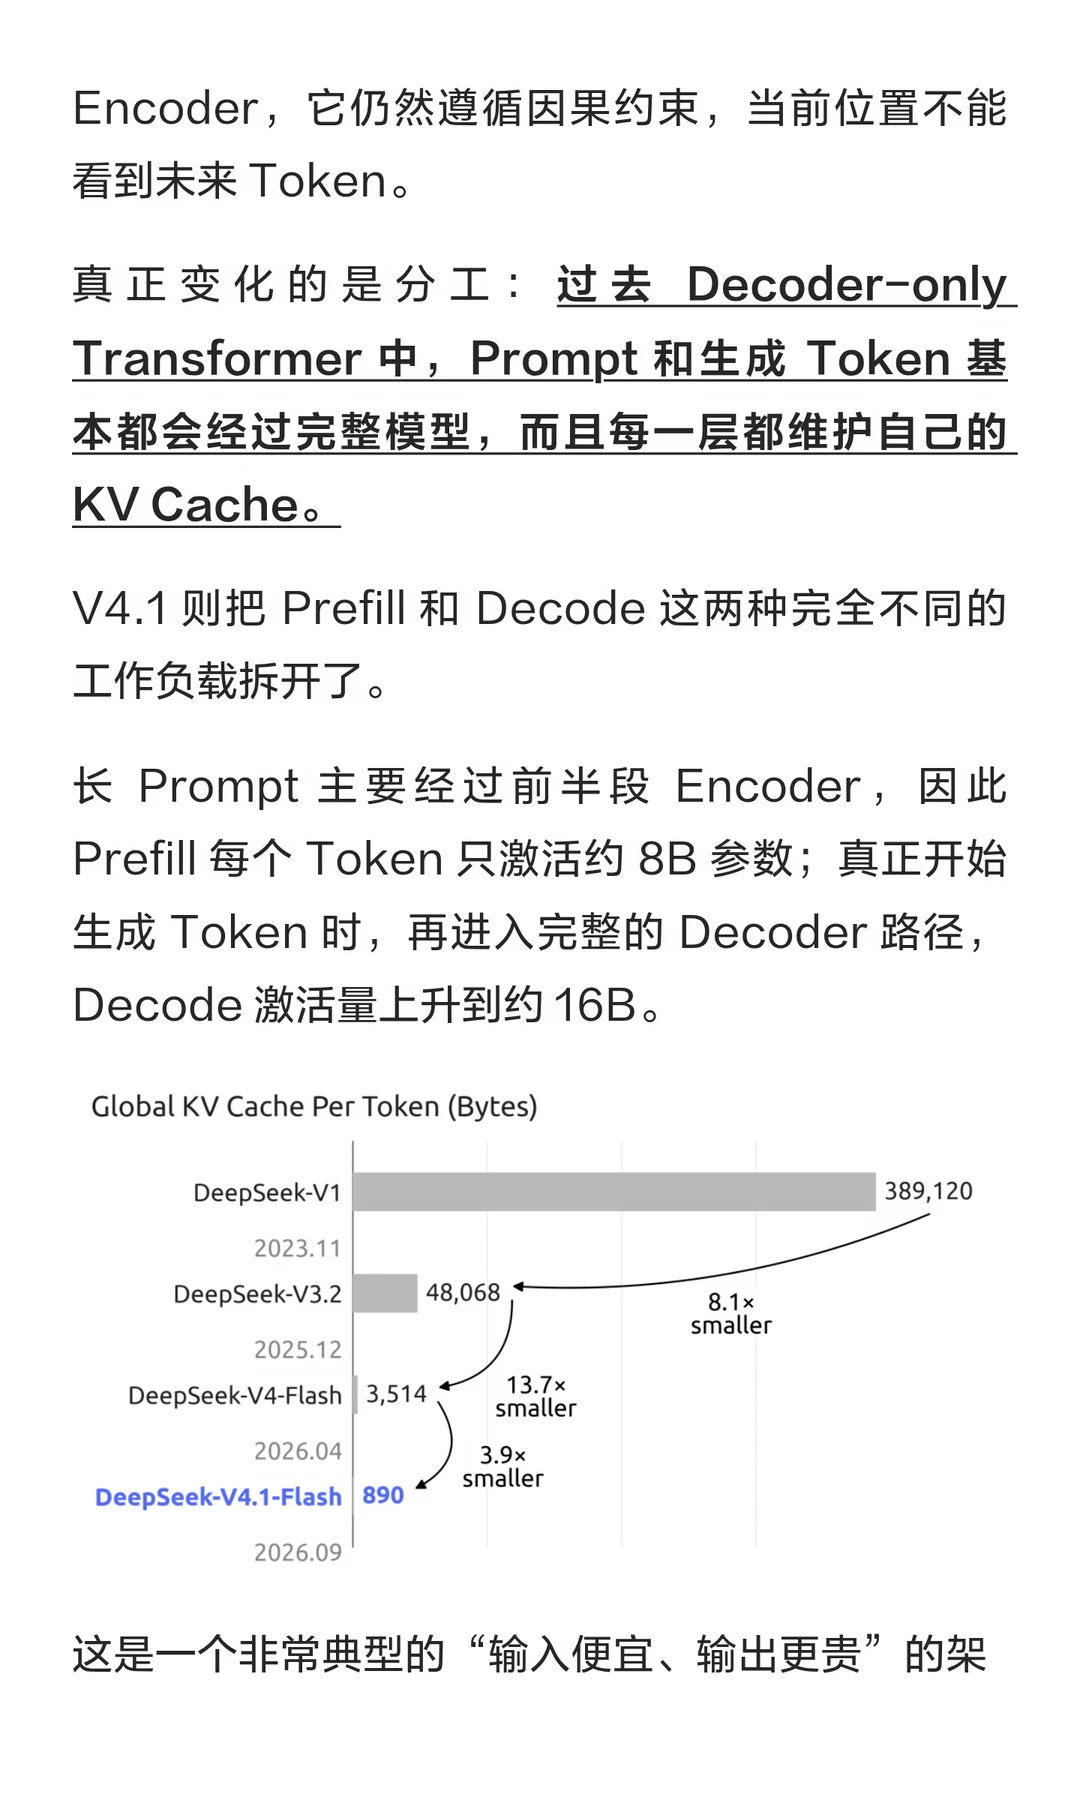
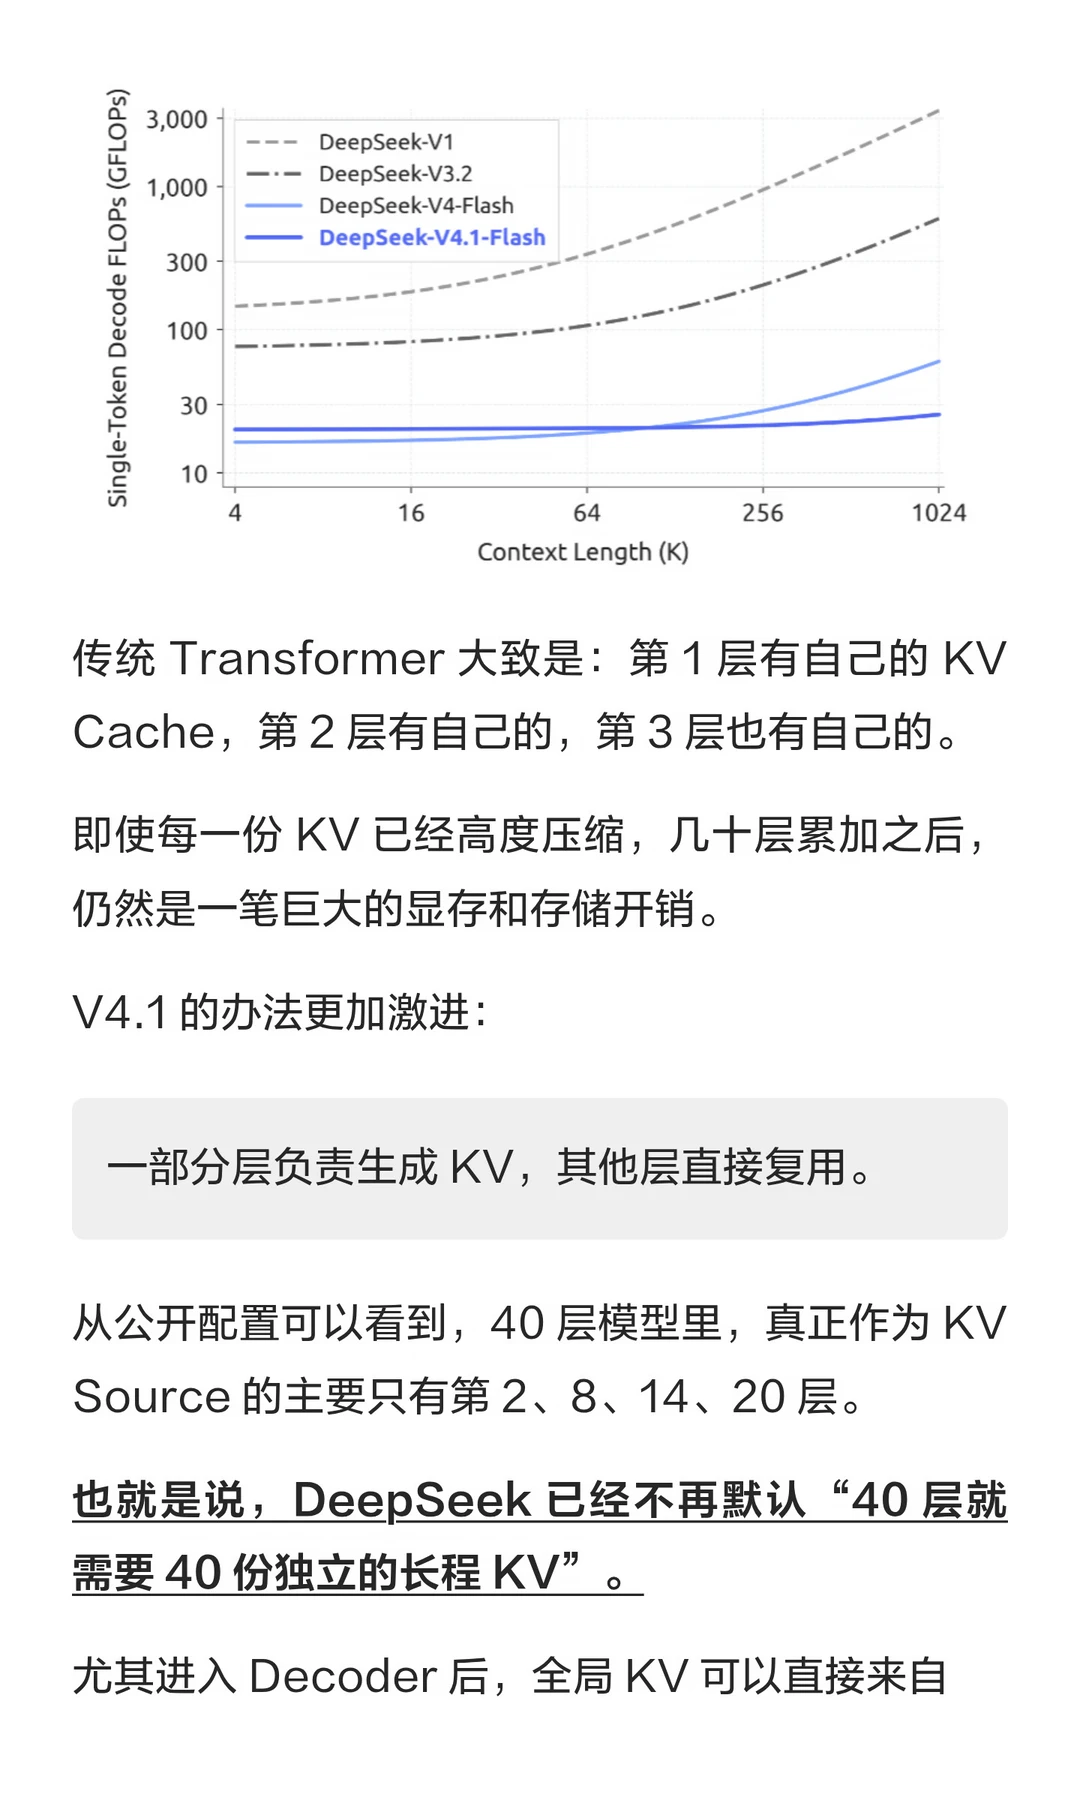
DeepSeek V4.1 Flash 发布了:552B 总参数、1M 上下文、Prefill 激活约 8B、Decode 激活约 16B,以及 890 Byte/Token 的 KV Cache
更让人惊喜的是 DeepSeek 重新设计 Transformer 的“记忆系统”。V4.1 又往前走了一步:为什么每一层都要单独保存一份 KV?
一、引入了 CED(Causal Encoder–Decoder)
40 层模型被拆成前 20 层 Causal Encoder 和后 20 层 Decoder。长 Prompt 的 Prefill 主要走 Encoder,因此每个 Token 只激活约 8B 参数;真正生成时,再进入更重的 Decode 路径。
二、CSA2 开始让 KV 跨层共享
传统 Transformer 基本是每层一份 KV Cache。V4.1 不再这么干,而是只有少数层生成 Global KV,其他层直接复用。
可以理解成:Cache Once, Read Many Times。
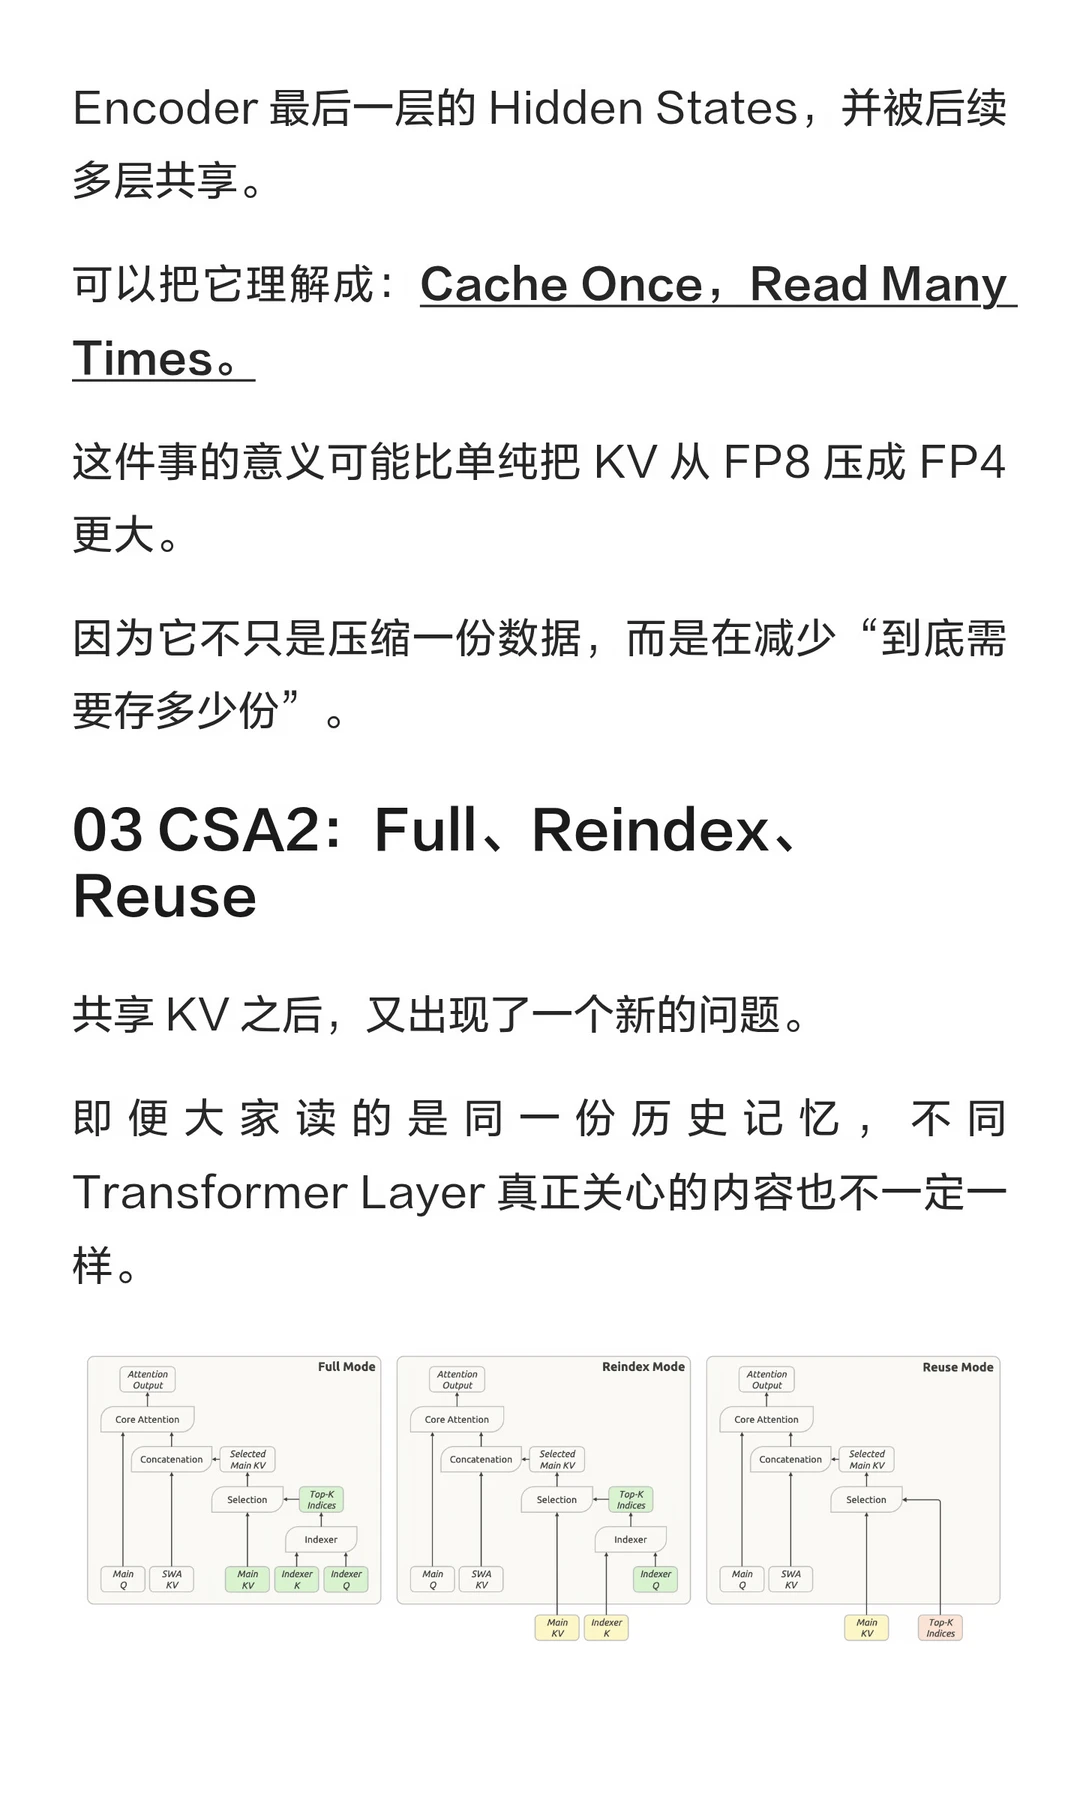
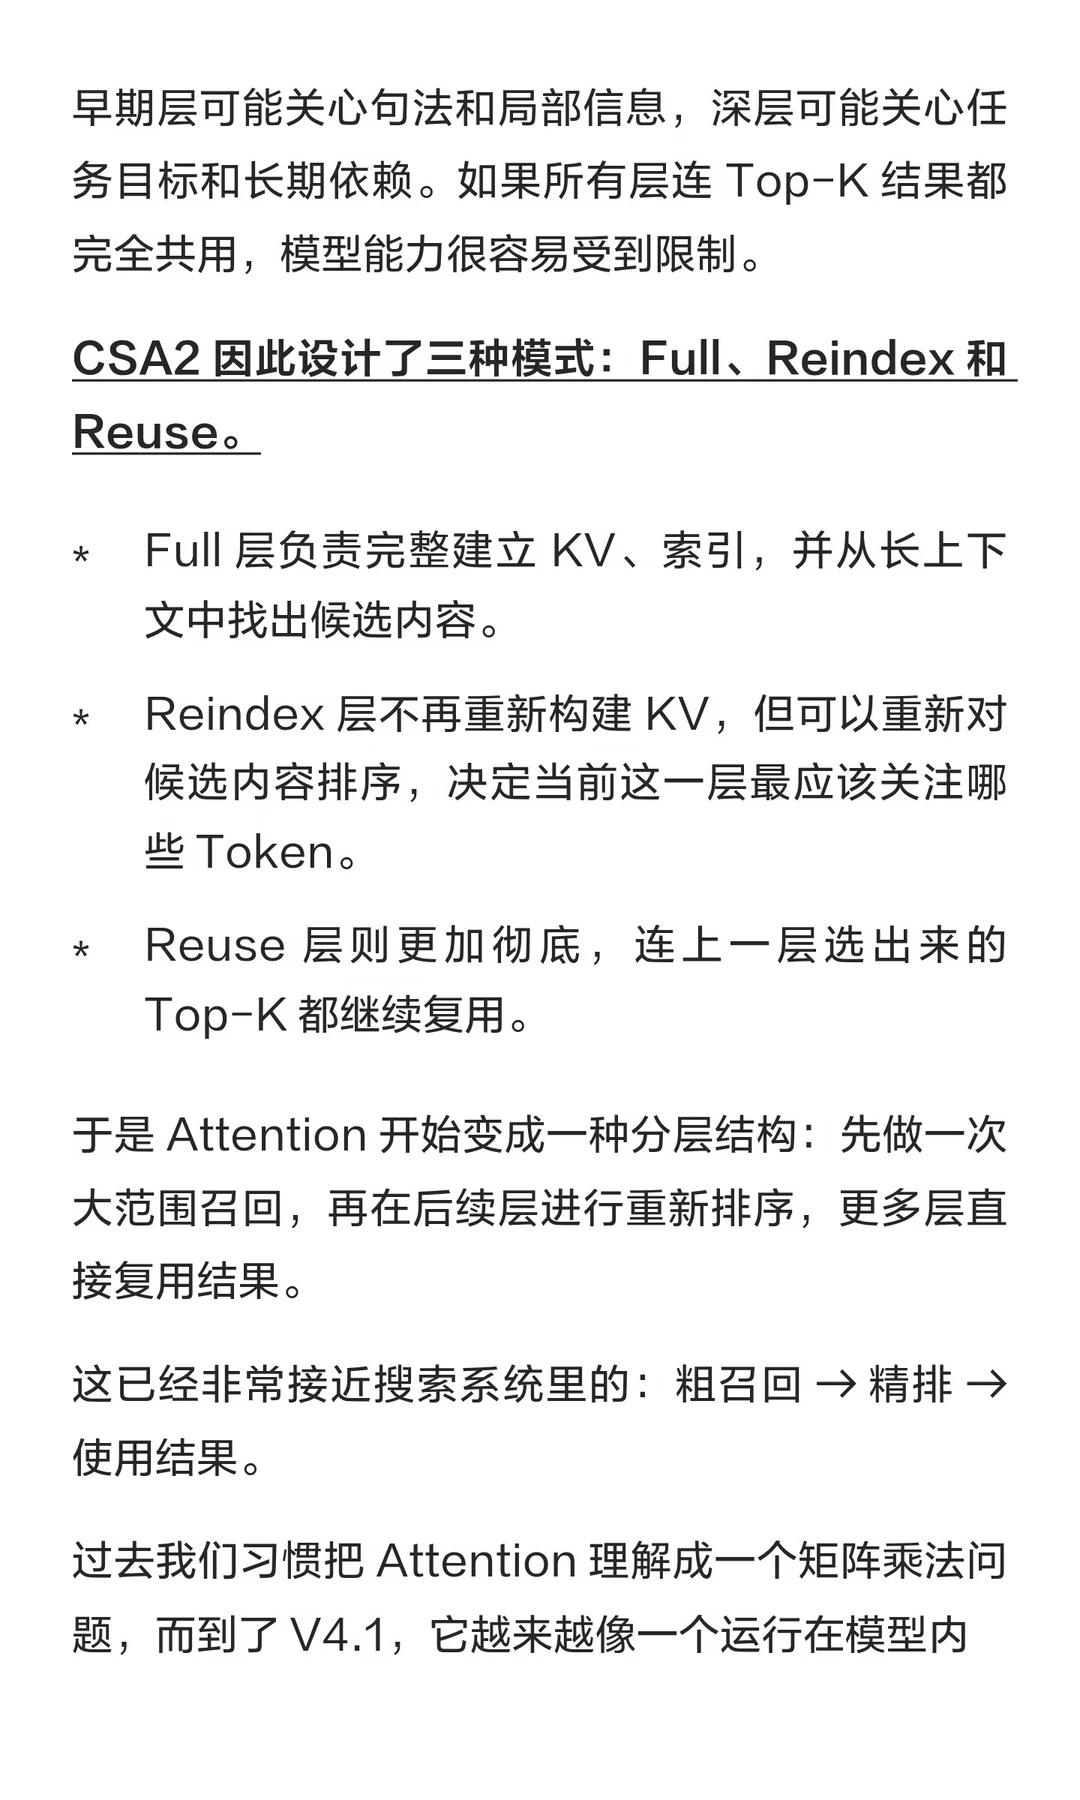
CSA2 又把不同层分成三类:Full、Reindex、Reuse。
Full 层负责完整检索上下文;Reindex 层不用重新生成 KV,只重新排序候选内容;Reuse 层甚至连 Top-K 结果都直接沿用。
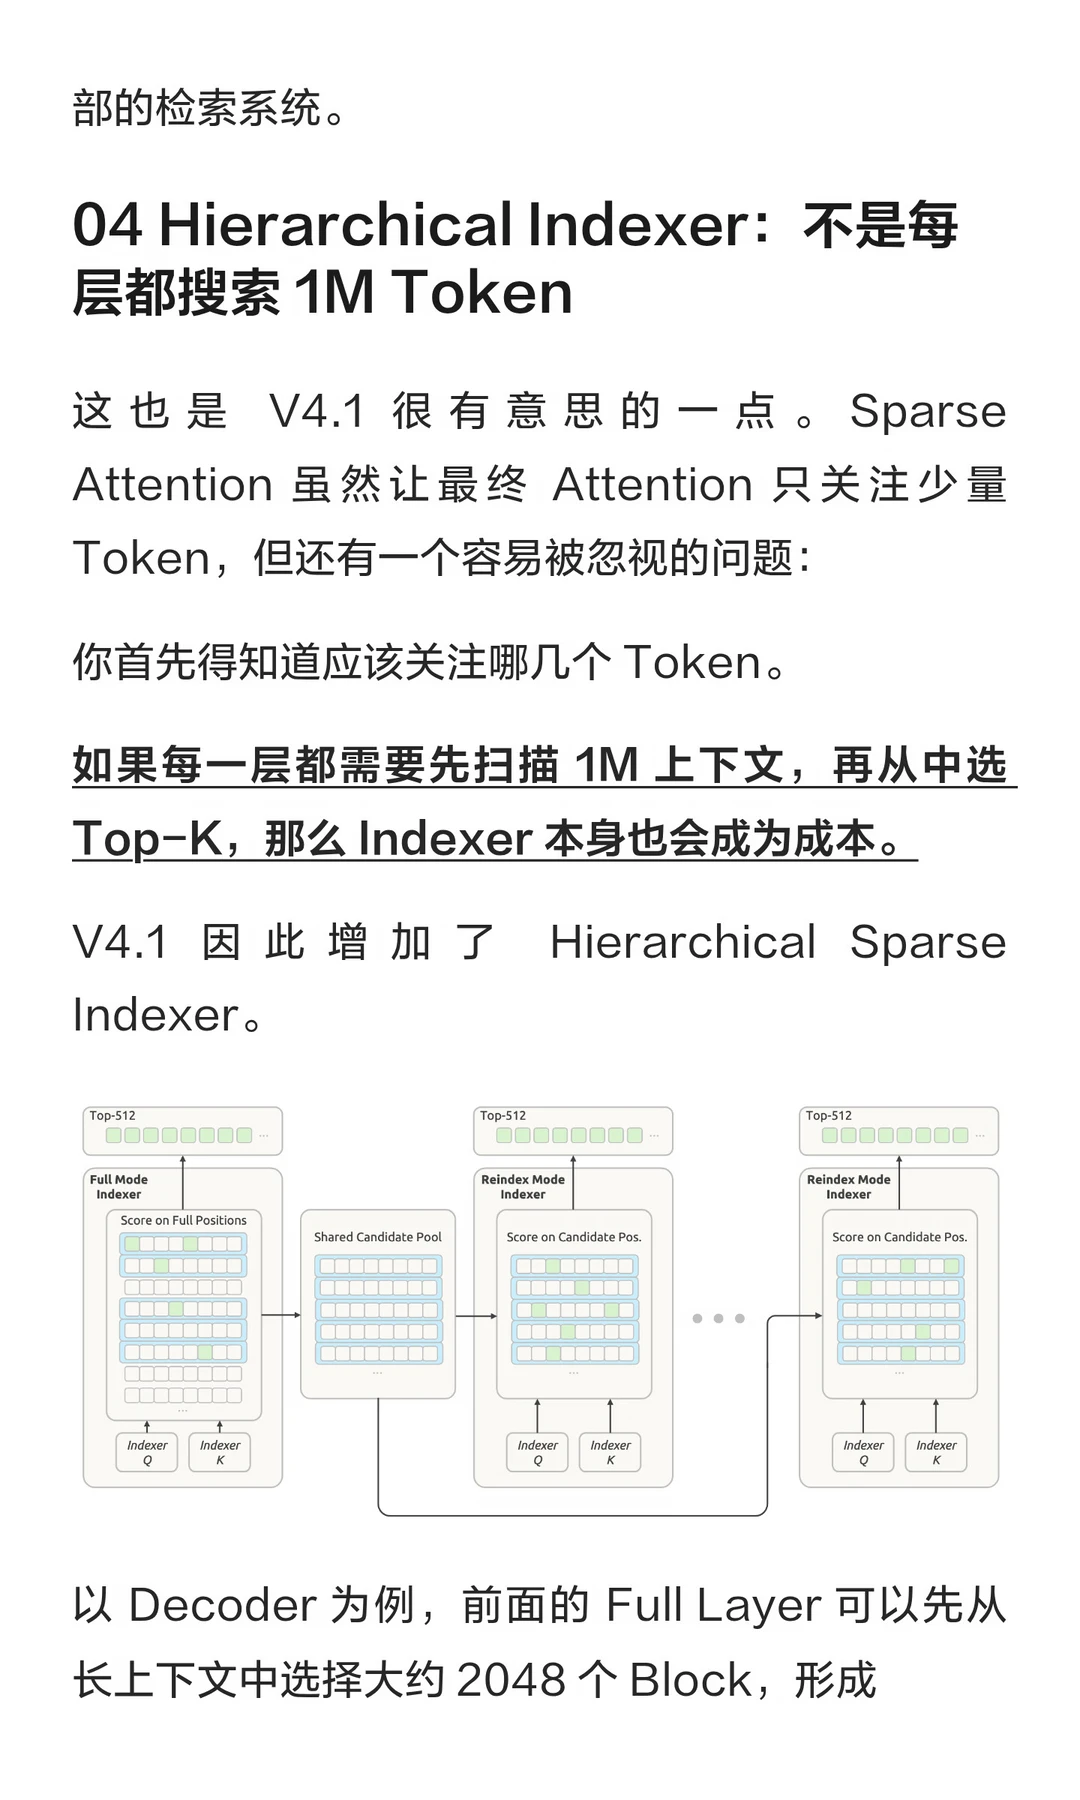
三、Hierarchical Sparse Indexer
后面的层不必反复扫描完整 1M Context,而是在前面筛出的 Candidate Pool 中继续选 Top-512。
这也是为什么 V4.1 能把 Global KV Cache 压到约 890 Byte/Token。
它背后其实是:CED 减少计算 → CSA2 跨层共享 KV → Sparse Index 减少访问 → FP4 再压缩存储。
四、196B 参数的 Engram Conditional Memory
它并不是传统 MoE 权重,而更像一套超大的 Associative Memory,根据 token n-gram 模式按需检索
从 MLA 到 Sparse Attention,再到 CSA2,DeepSeek 研究的问题已经越来越明确:当上下文已经足够长以后,模型究竟该怎么存、怎么找、怎么用这些记忆
#DeepSeek #DeepSeekV41 #大模型 #LLM #AI架构 #AI反常识howto #AGI