💥必读:DeepSeek V4.1 Flash论文里面暗藏的玄机!V4.1 Pro将是大杀器!2000张GPU+存储集群将是最大助推器!
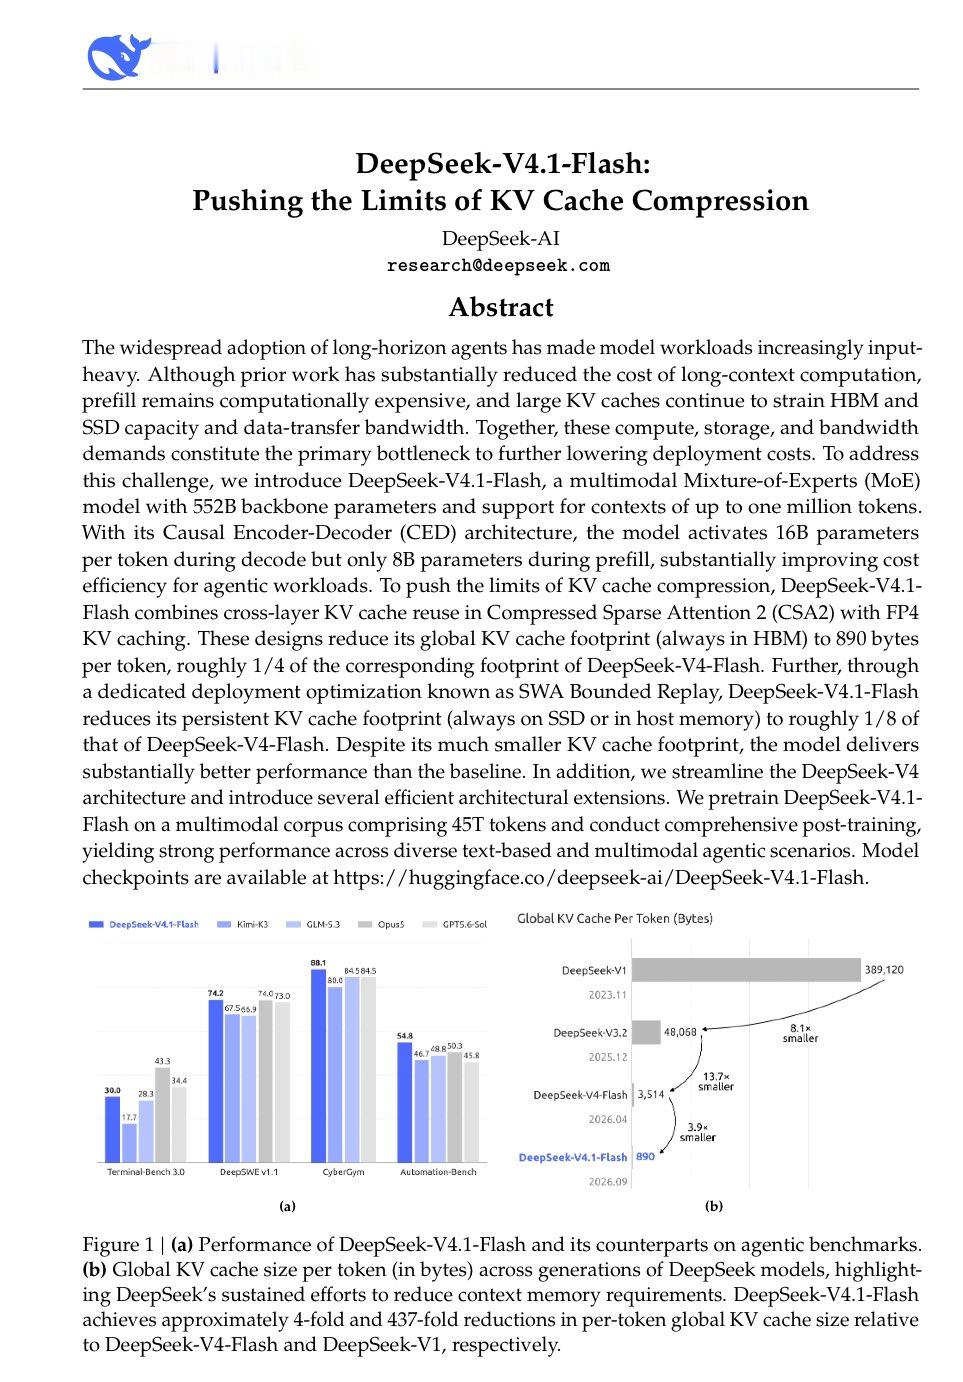
论文核心要点速览:1️⃣Flash 反杀 Pro,是产品线信号 不是“小模型勉强接近大模型”,而是新结构系列的最小尺寸已经全面超过上一代旗舰。Pro 被路由、被计划下线,说明他们认准了:密度比绝对规模更重要。
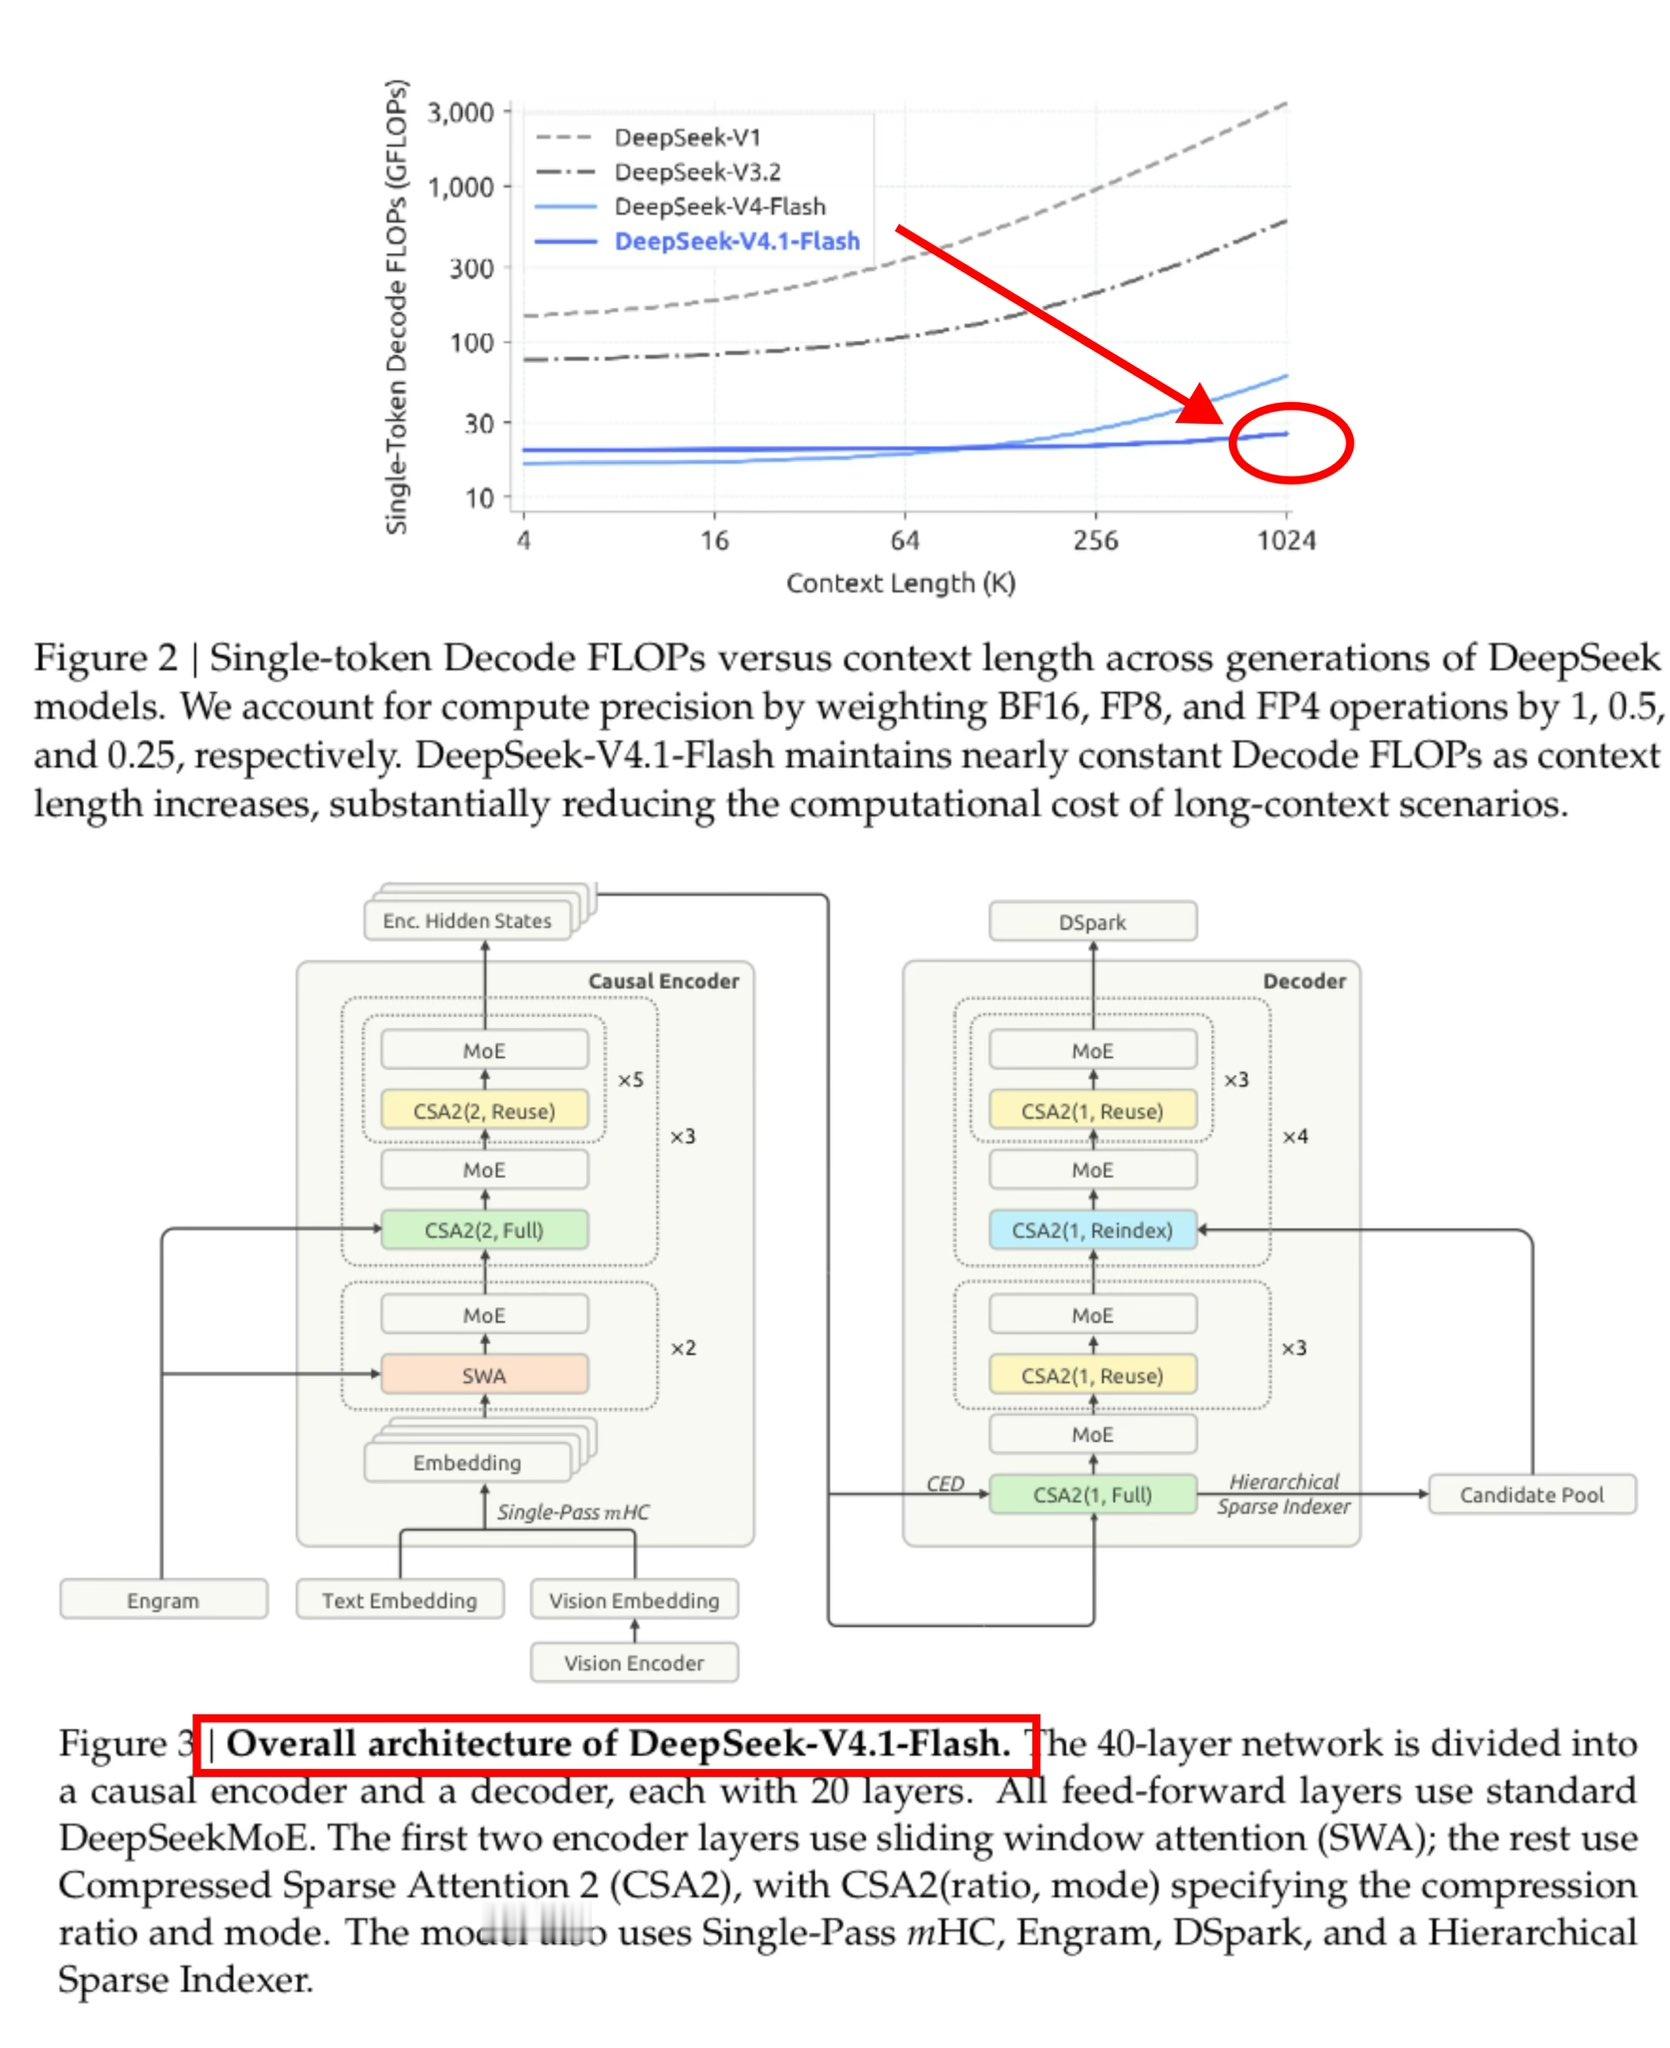
2️⃣CED 是给 Agent 账单改写的 Prefill 8B / Decode 16B 的不对称,精确对准“长输入、工具回填、多轮缓存命中”。谁还按对称 Transformer 给 Agent 报价,谁就会变贵。
3️⃣890 bytes/token 才是核弹数字 100 万 token 的全局 KV 大约 890MB 量级。以前 1M 上下文是存储灾难,现在更像“可以常驻、可以集群调度”的常规货。相对 V1 的 437 倍压缩,是他们几年稀疏注意力路线的结算单。
4️⃣SWA Bounded Replay 是系统题,不只是模型题 论文专门开了 Inference System 章节:持久 KV 管理 + 有界重放。官方推文里的“2000 GPU + 存储集群”不是营销口号,是在找能把这套缓存层级真正跑起来的人。
5️⃣Engram 把“查表”从计算里拆出来 196B 条件记忆用哈希查找静态模式,MoE 负责动态推理。这是第二条稀疏轴:少算、多记。表还能 offload 到主机内存,和“存储集群”叙事对得上。
6️⃣原生多模态不是贴片 Vision 从零训、和语言一起进 45T 语料,旧的 Flash Vision-Exp 外挂路线被收掉。名字统一成 deepseek-flash,产品在收口。
7️⃣开源帖的潜台词是“一起把推理栈补完” 权重和论文已经上 HF,SGLang 当天就有 cookbook,但官方仍说要和社区密切合作支持推理、探索更多部署选项。潜台词:架构新(CED / CSA2 / Replay / Engram / DSpark),工程窗口刚刚打开。
8️⃣这是系列最小杯,V4.1 Pro将是大杀器 报告写明新结构“可扩展到更大参数模型”。Flash 是探针。真正的大杀器可能是同一套 CED + 极限 KV 压缩,放大到下一档 Pro。