海光突然亮牌!AI算力开始按“产量”计价
今天在联通合作伙伴大会转了一圈,海光发布的双芯方案让我重新想了想“算力规模”这件事。
过去行业喜欢讲多少张卡、多少P,数字确实热闹。可站在运营商角度,卡买回来只是支出,能稳定生成多少词元、能服务多少客户,才决定这笔投资能不能赚钱。
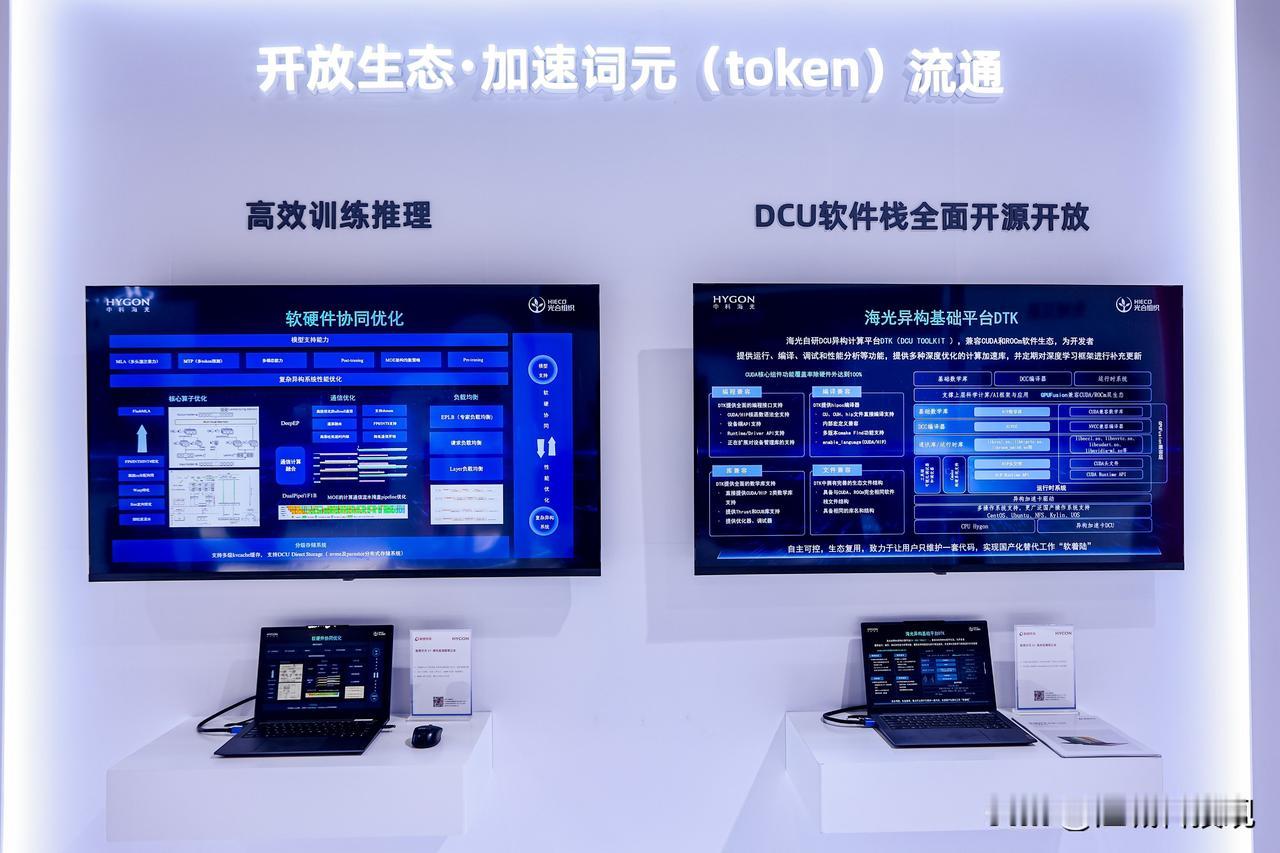
海光这次直接把词元生产、调度、计量、成本核算和扩容连在了一起。CPU负责安排Agent任务、管理内存和调度资源,DCU集中处理模型推理。预填充更吃算力,解码更看显存带宽,PD分离后可以各用各的资源池,不必互相拖着跑。
王楠在采访中总结了三个要求:高吞吐、长上下文、低成本规模部署。说得挺到位。运营商接的是全国业务,几次测试跑得快没多大用,高峰期扛不扛得住、单位词元成本稳不稳定,才是真账。
尤其到了客服、政务、金融等场景,请求数量与上下文长度随时会变。KV Cache可以保存已经计算过的内容,并在显存、内存和不同节点之间调配。少算一次,就少占一部分算力,也能多接一批请求。
更细的一层,输入词元、输出词元、长上下文溢价、缓存命中折扣都可以分别核算。运营商以后卖AI服务,不能再用一套模糊价格覆盖所有调用。
算力行业终于不只晒家底,也开始晒产量、算成本了。海光这一步,踩得很准。
国产CPU DCU 人工智能