具身智能后训练算法工程到底问什么?
在具身智能视觉-语言-动作(VLA)模型中,如何选择和设计动作空间的表征方式(如连续值、离散化Token或扩散生成)?不同表征对模型收敛速度和控制精度的实际影响是什么?
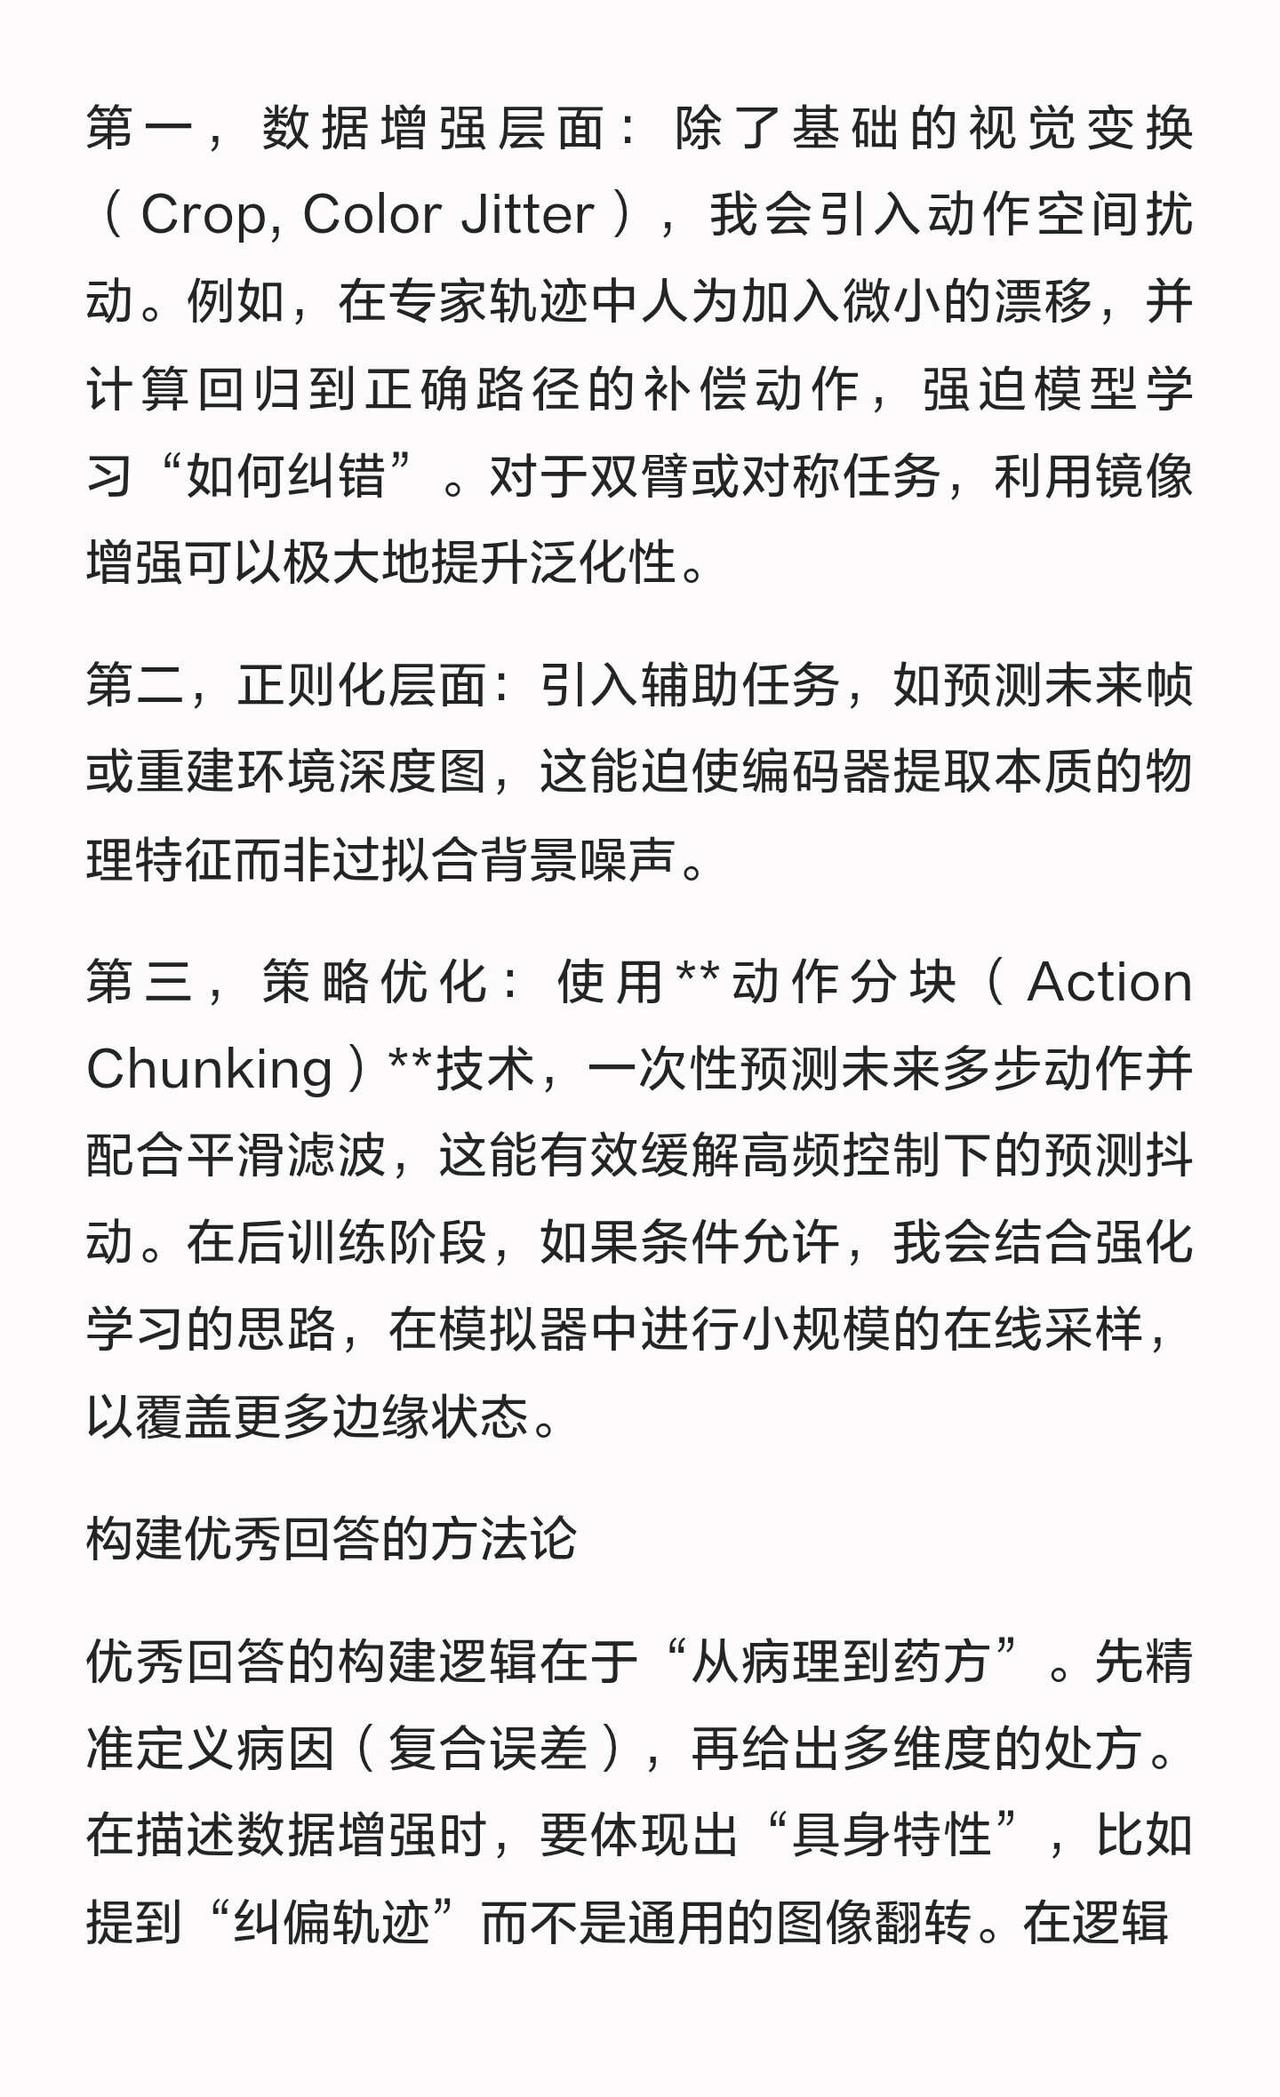
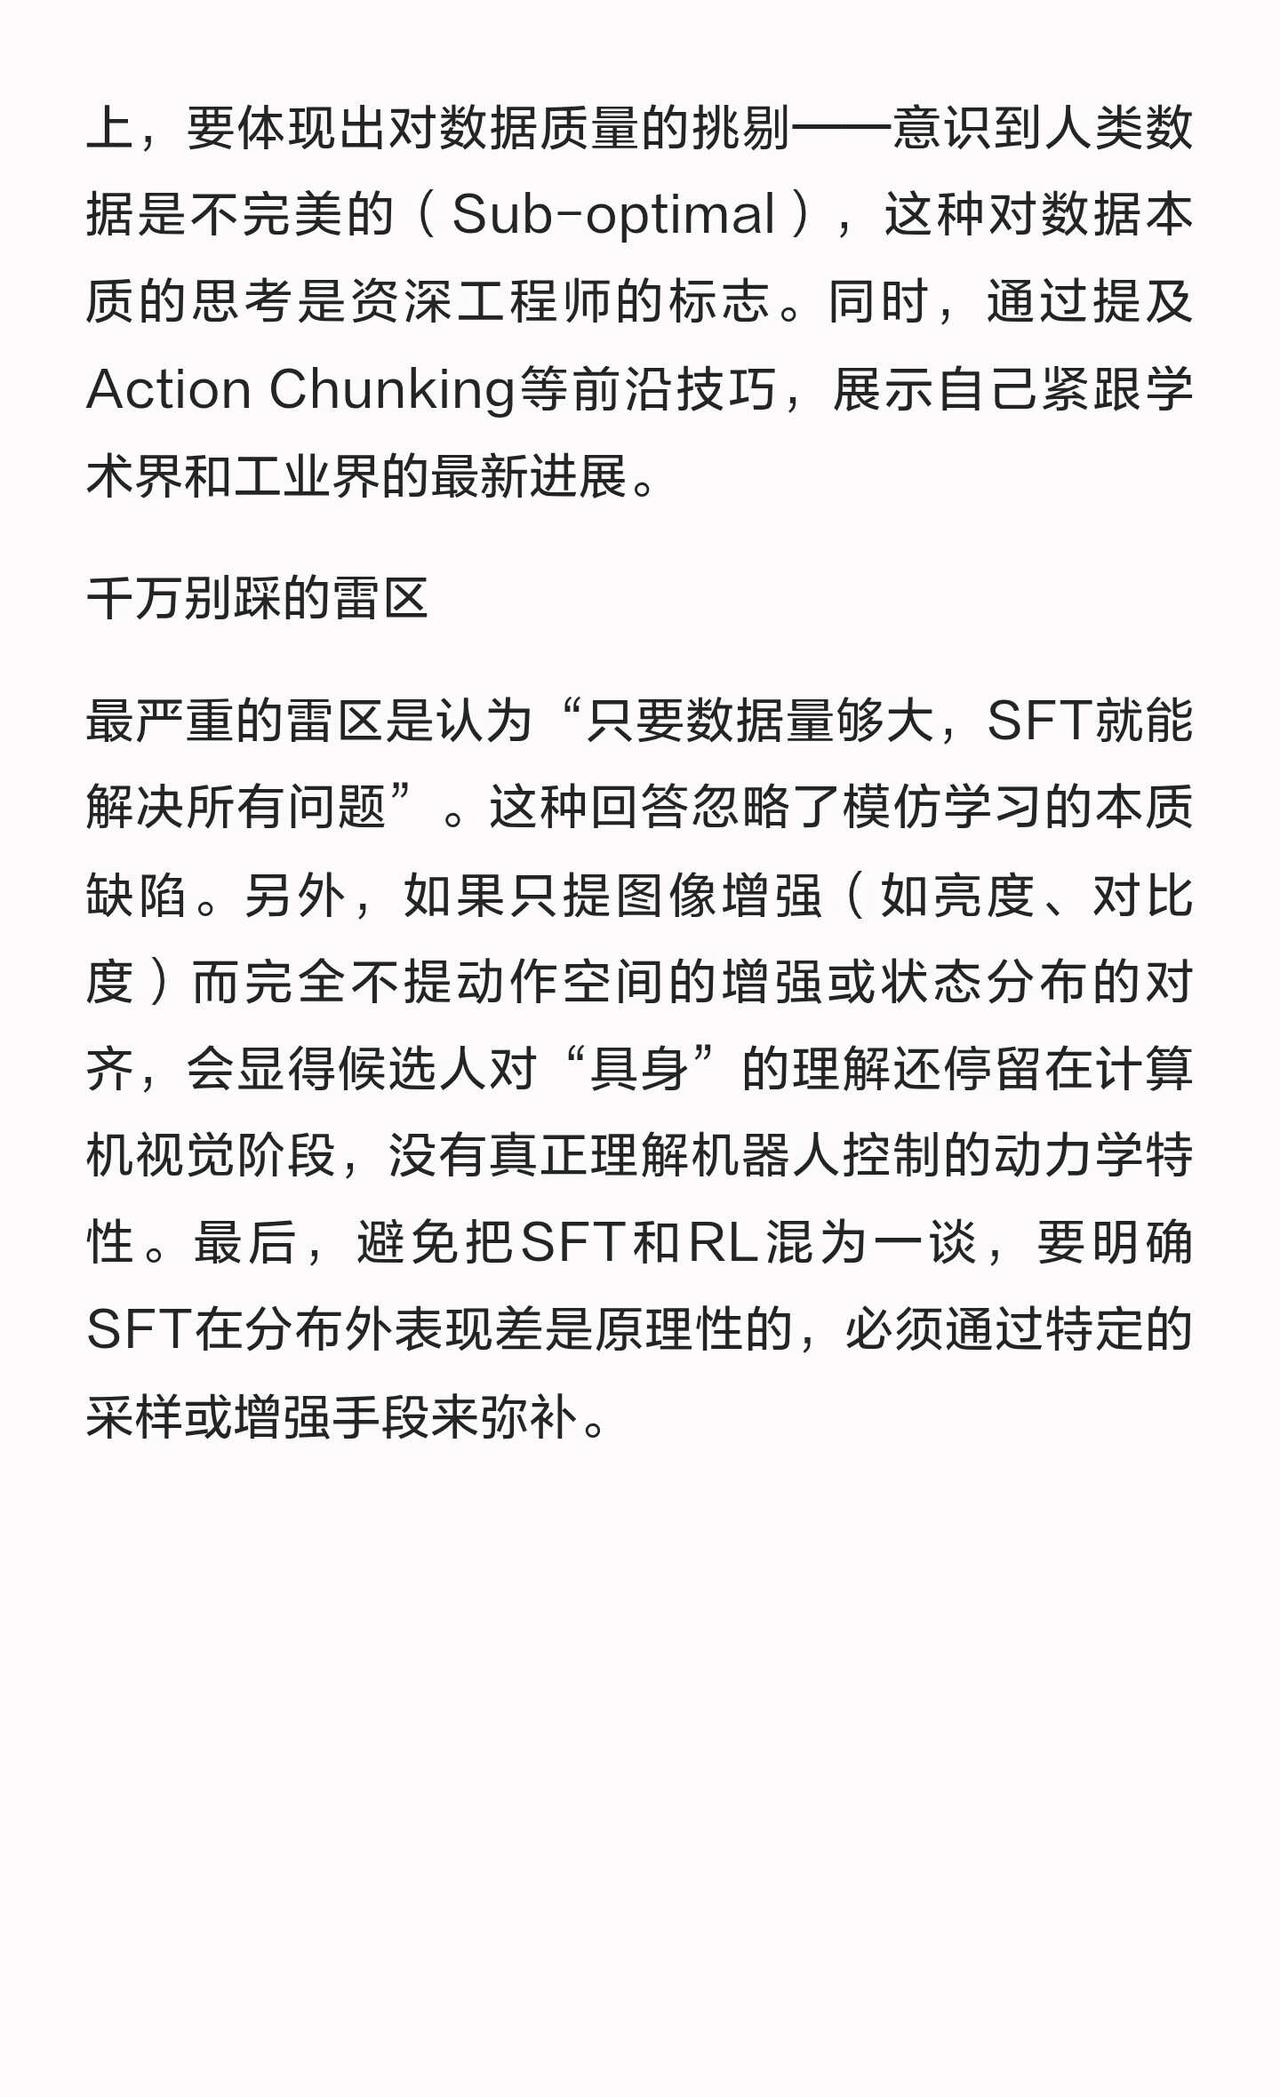
针对机器人操作任务的监督微调(SFT),如果直接使用人类遥操作数据进行端到端克隆,通常会遇到哪些原理性瓶颈?你会采取哪些数据增强或正则化手段来缓解协变量偏移?
在将大语言模型的对齐技术(如RLHF或DPO)迁移到具身智能场景时,基于文本的偏好和基于物理动作的偏好存在哪些本质区别?如何设计奖励模型以捕捉轨迹的安全性和效率?
采用LoRA或QLoRA对大规模具身基础模型进行微调时,如果发现模型在未见过的物体上泛化能力较差,从参数冻结和秩(Rank)选择的角度,你会如何定位并调整微调策略?
具身多模态模型通常需要同时处理图像、文本和机器人本体感觉数据。在特征融合阶段,如何解决不同模态数据采样频率不一致的问题,并保证端到端训练的时序因果性?
扩散策略(Diffusion Policy)在复杂且多峰分布的机器人操作任务中表现优异,相比传统的确定性策略,它的主要优势体现在哪?在推理延迟受限时应如何优化其采样过程?
在进行强化学习微调时,如果机器人的动作空间维度较高且存在严重的物理约束,如何设计Actor网络和Critic网络的输入结构以提高样本效率并避免策略崩塌?
相比于直接对比学习,基于直接偏好优化的算法在具身轨迹对齐中无需单独训练奖励模型。在实际应用中,如何构建高质量的偏好对,以确保模型不会学习到无效的捷径?
面试经验howto 求职面试 面试技巧 面试干货 面试经验分享 上岸 求职面试技巧 秋招有路子