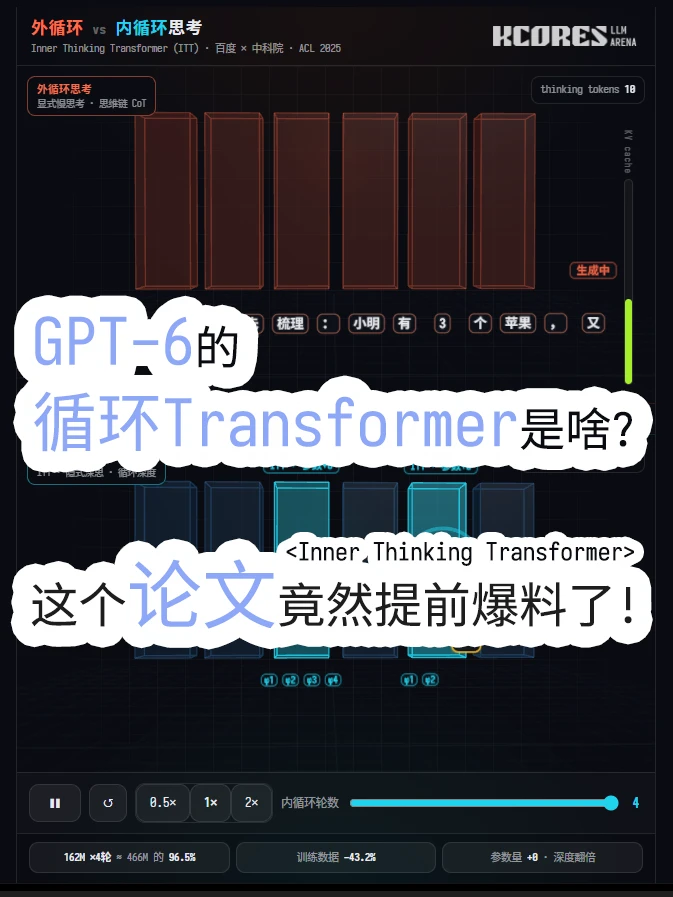
最近 The Information 爆了个大猛料:OpenAI 的 GPT-6 Astra, 用上了一个叫循环深度的新方法, 也叫做循环Transformer
但是他们并没有发论文! 完全不知道是个什么东西. 我搜了一圈, 竟然在中科院和百度发的一篇论文中找打了线索. 给大家整理一下我刚写的论文笔记, 能迅速了解什么是循环 Transformer
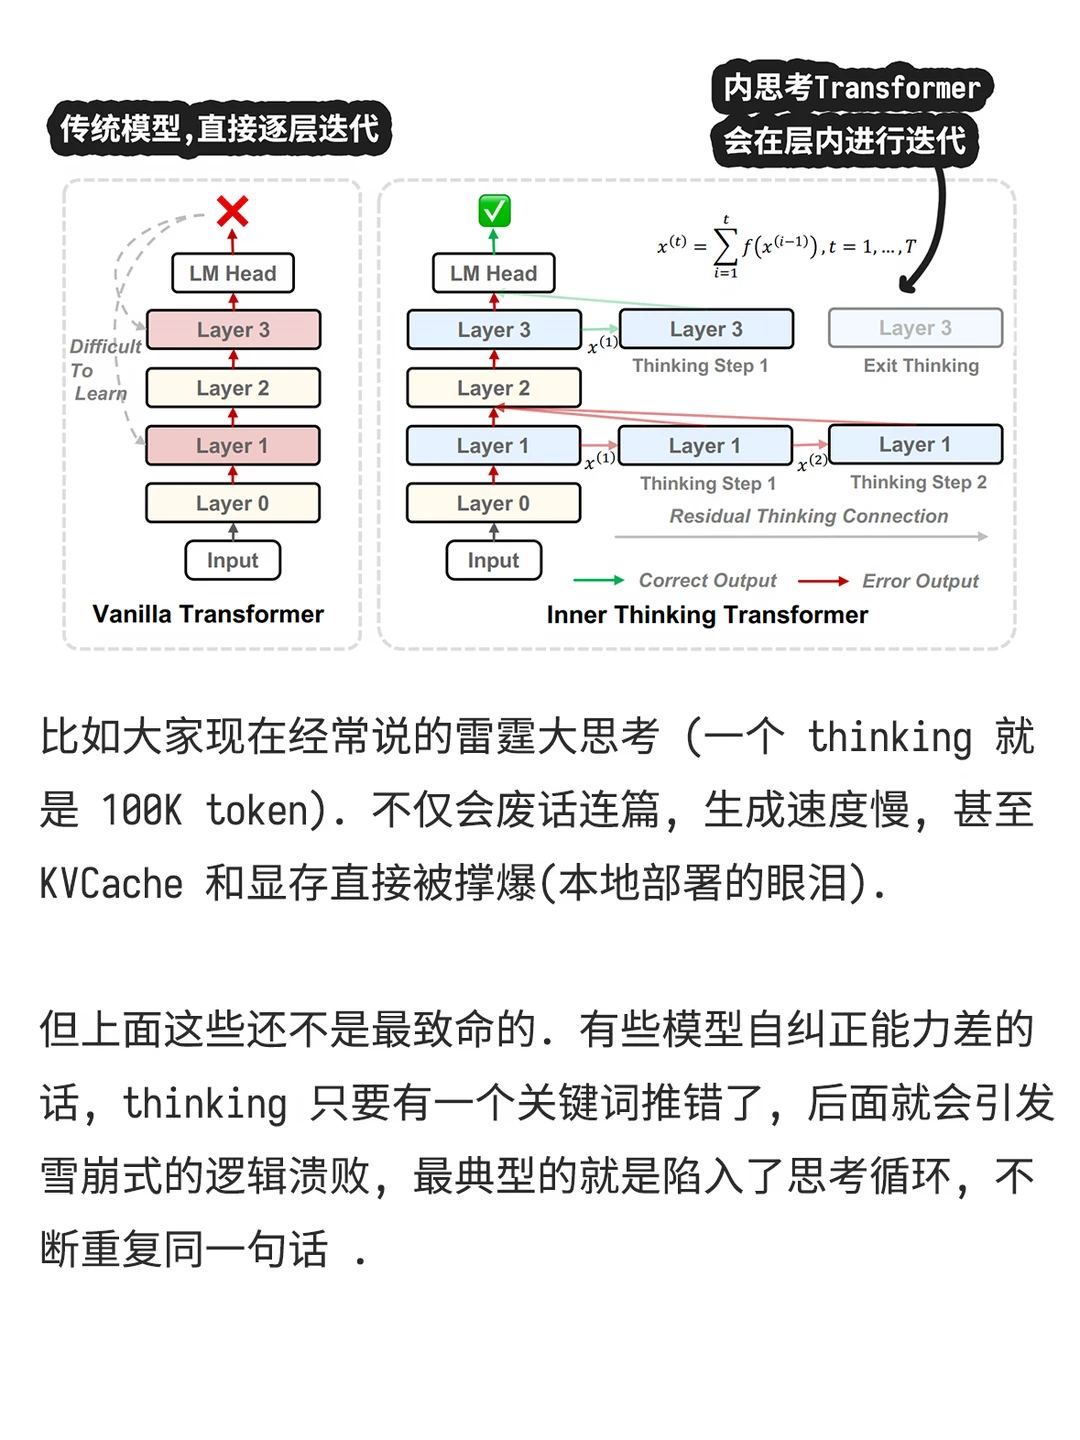
首先需要先了解什么是思考循环, 我们平时接触到的大模型, 在 thinking 标签里面吐出来的内容, 就是【外循环思考】, 但有的时候容易出bug, 比如大家现在经常说的雷霆大思考.
有些模型自纠正能力差的话, thinking 只要有一个关键词推错了, 后面就会引发雪崩式的逻辑溃败
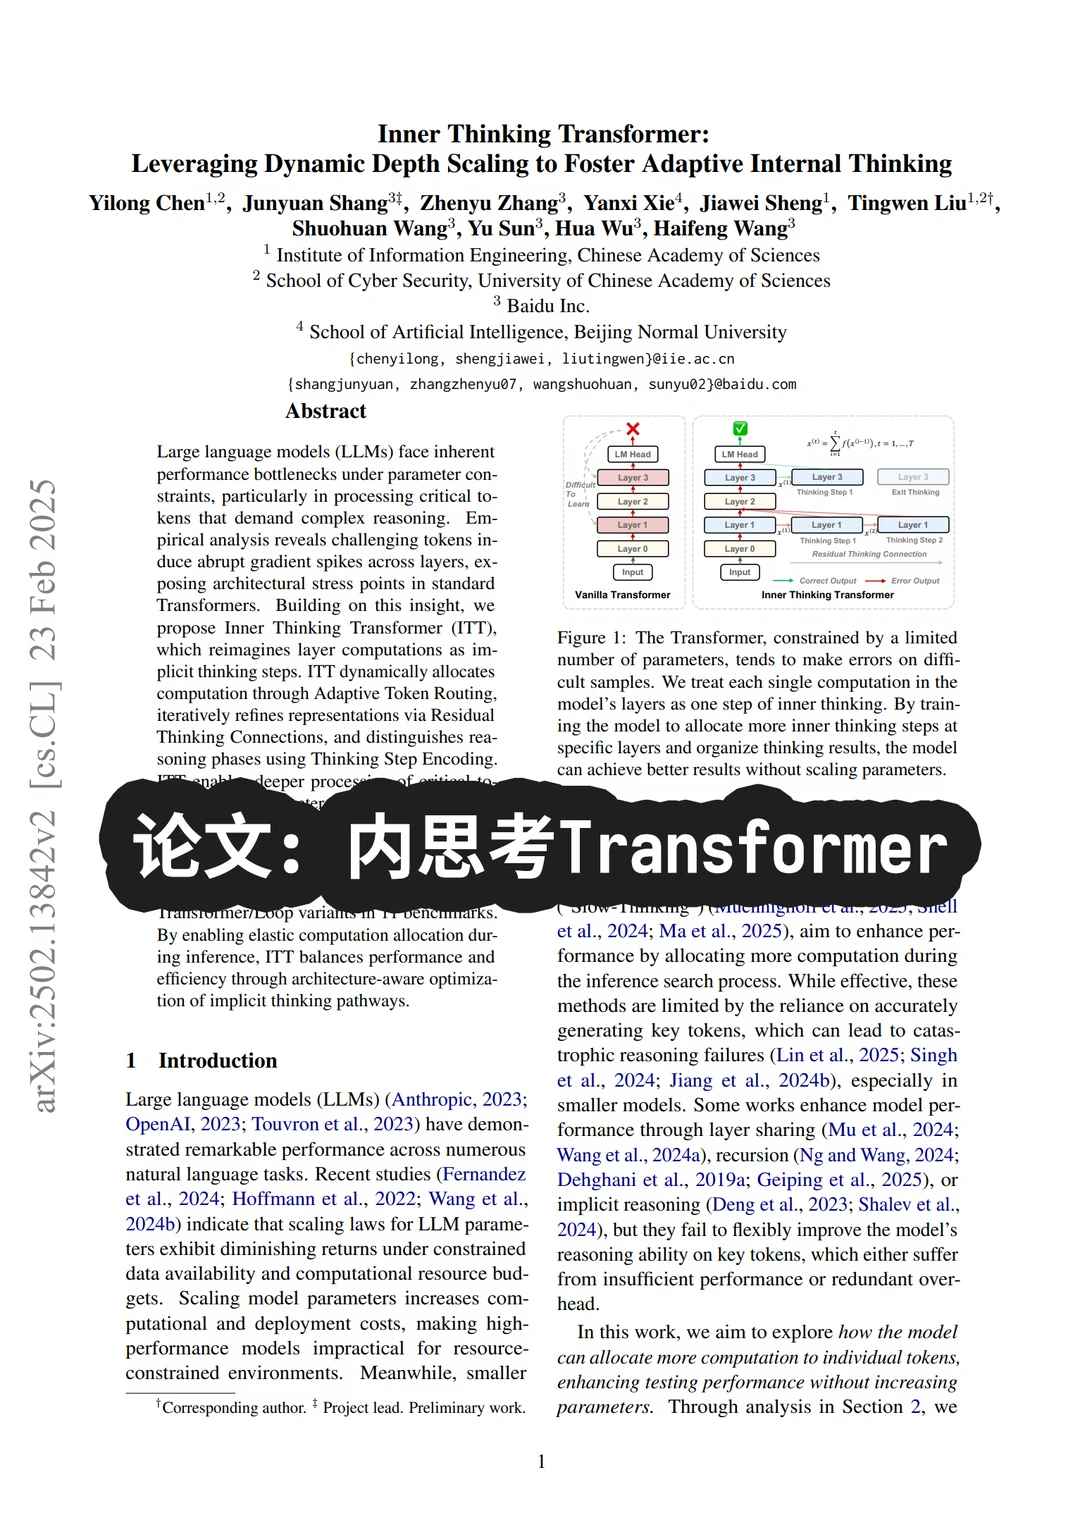
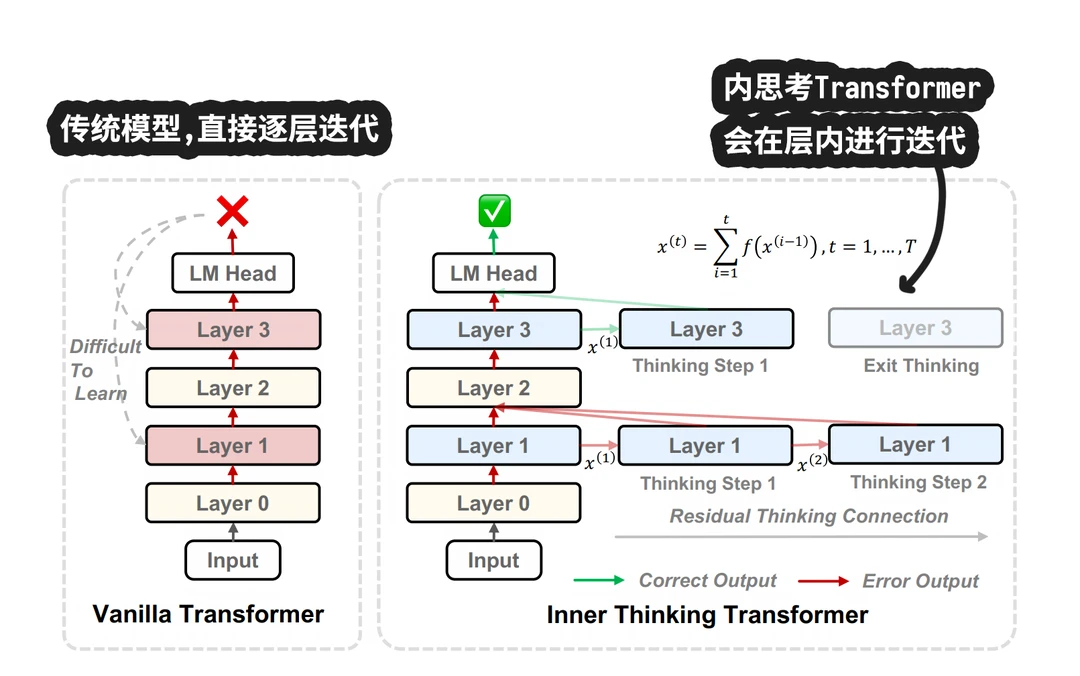
而百度和中科院的这个论文 《Inner Thinking Transformer》(这个论文入选了ACL 2025 Main Conference), 介绍的方式是【内循环思考】, 正好就是这次 GPT-6 提到的概念
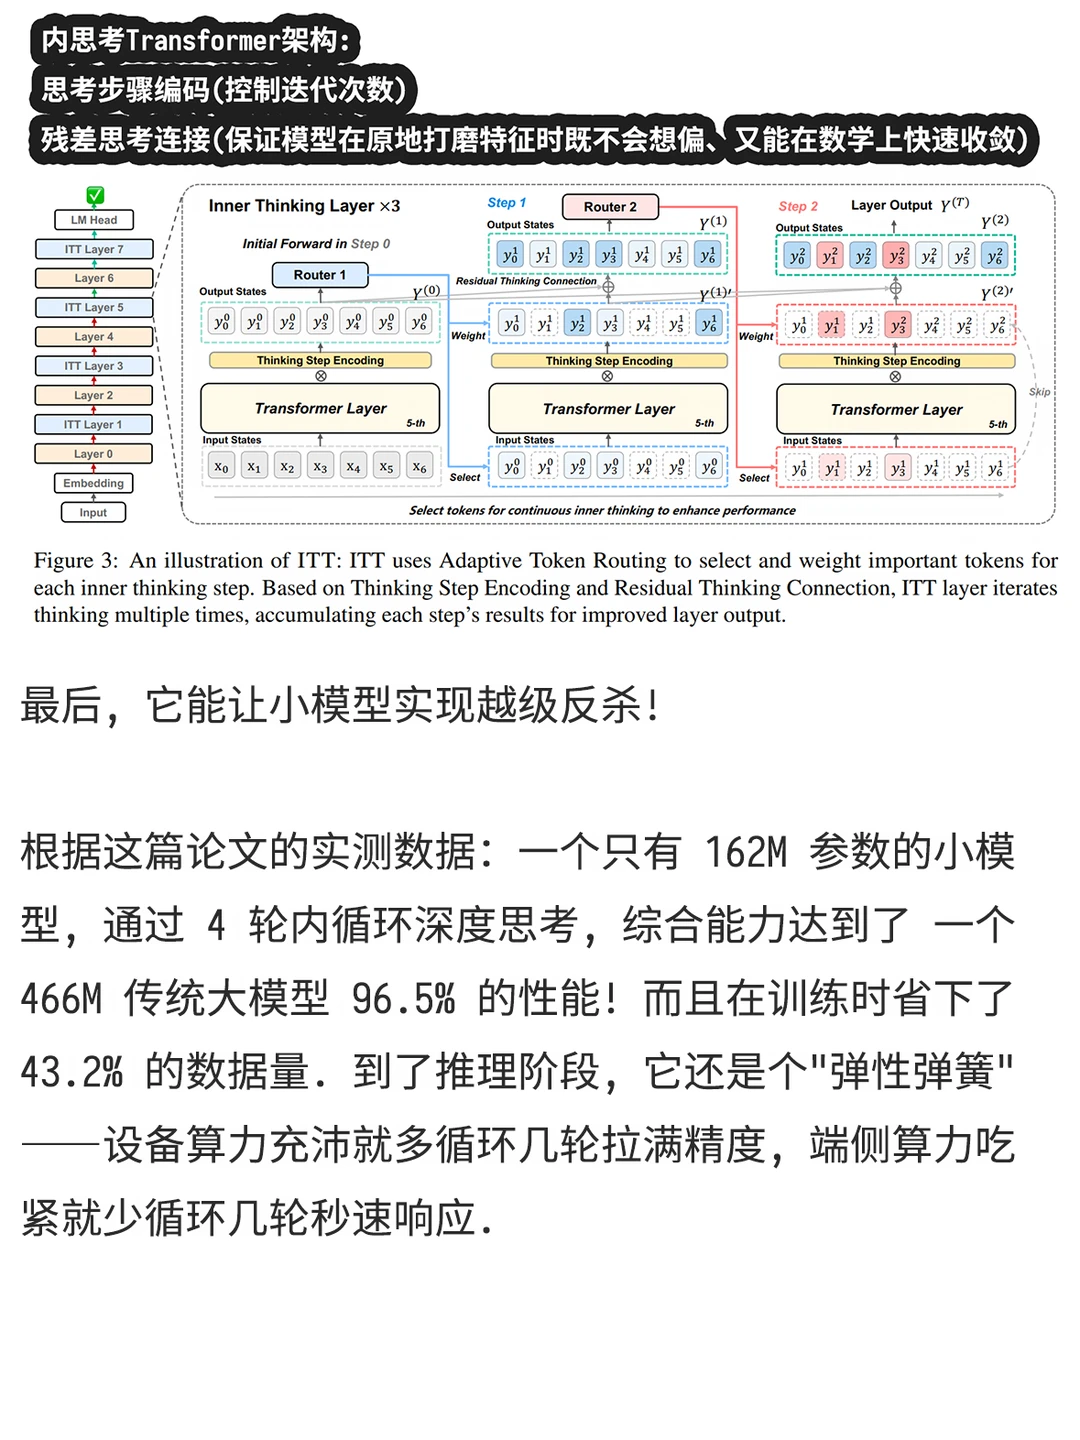
简单来讲, 大模型推理的时候, 重要性高的token, 可以在模型深层次的的隐藏状态层进行动态循环思考. 来不断提炼结果
用白话说, 有的人想事情的时候一定是要自言自语说出来的(类似外循环思考), 而有的人只要脑子里面过几次, 就能把事情想明白了(内循环思考大概的原理)
那么内循环牛在哪里呢? 为啥会被视作打破大模型 Scaling Law 瓶颈的救命稻草? 论文中有几个观点:
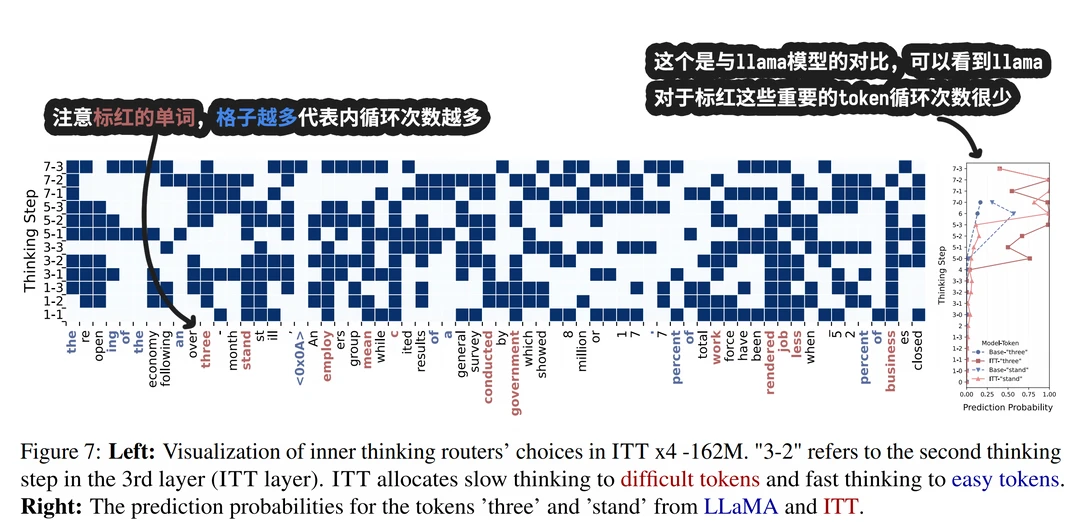
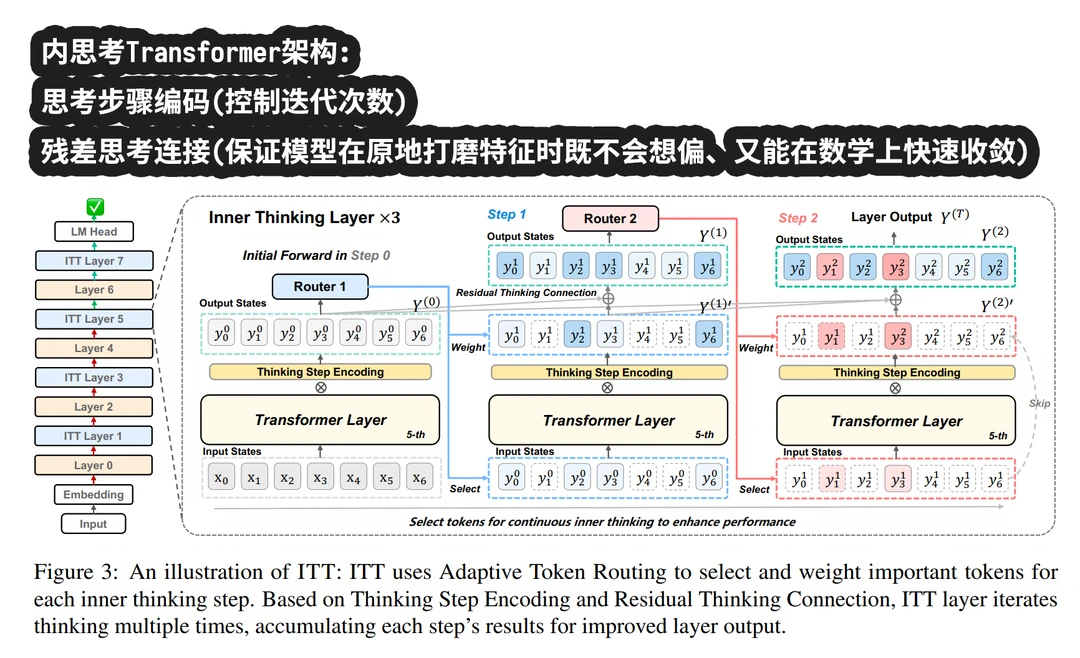
一个是刚刚说的可以引入自适应 Token 路由
先给每个token打分, 区分重要性, 低的就适当跳过, 遇到真正烧脑的语义转折词、核心动词, 模型就会把它们挑出来, 在循环层里原地深思好几轮. 把算力用在刀刃上
另外, 它能让小模型实现越级反杀!
论文的实测数据:162M 的小模型, 4 轮内循环思考, 能力达到了466M模型96.5%的性能!
所以综合来看循环Transformer, 绝对是解决雷霆大思考的利器了, 能有效提升思考速度. 不用加显存也不增加参数, 还能让模型像人脑一样在关键难点上驻足深思
预感新的一波类似去年 DeepSeek MoE 的技术变革要来到了, 拭目以待!
#百度 #文心 #文心大模型 #循环深度 #循环Transformer #ITT #OpenAI #GPT6 #大模型