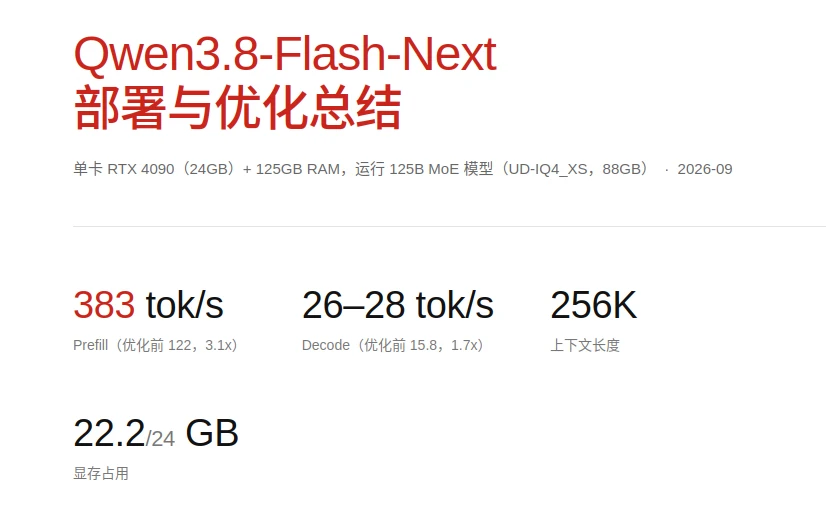
模型:qwen-flash-next q4
部署:单卡4090➕128g内存
最低价格分析:用3090的话主机显卡一起大概2万,模型运行一天的成本大概14度电,运行一天话费大概7元,实际来说模型根本不可能一直跑。
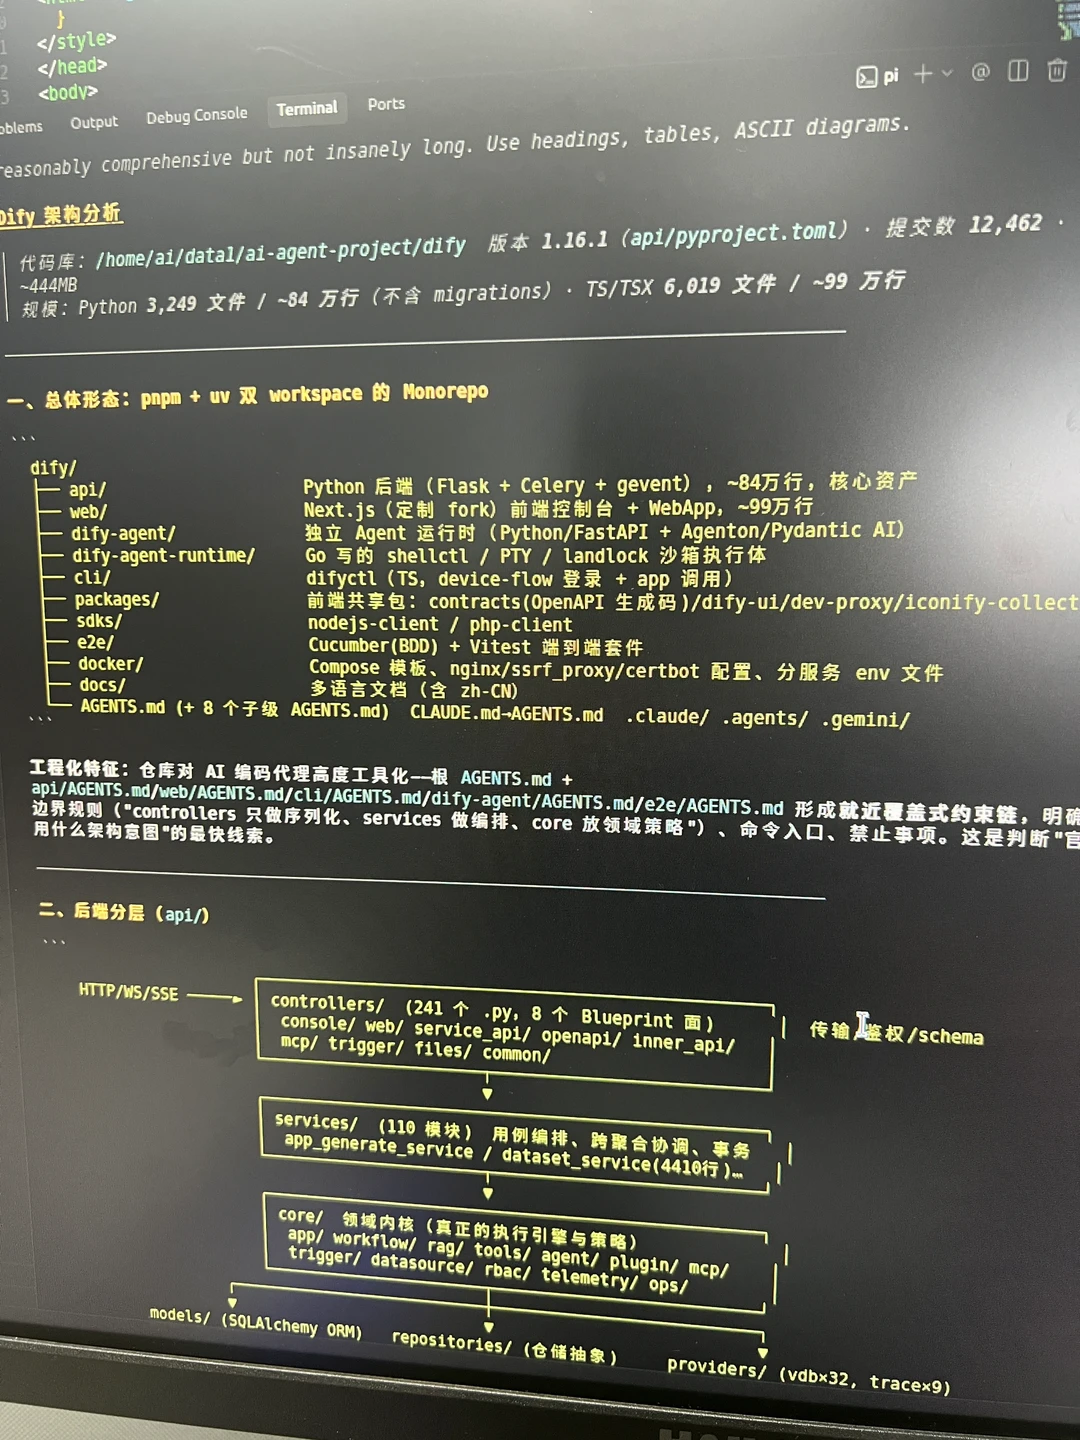
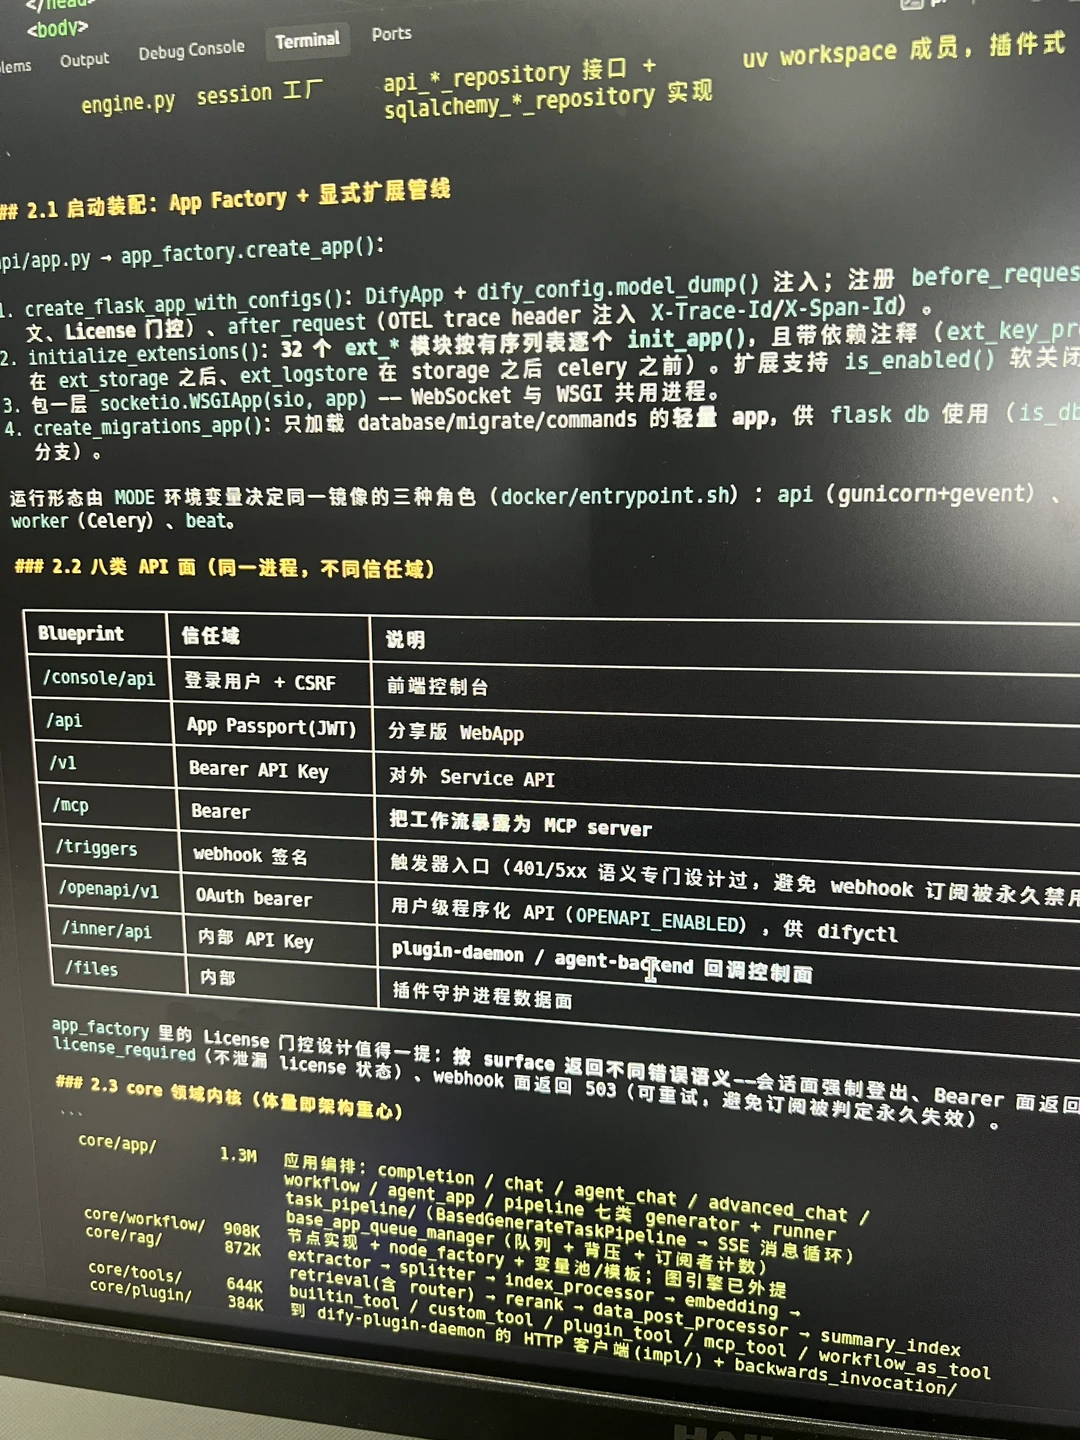
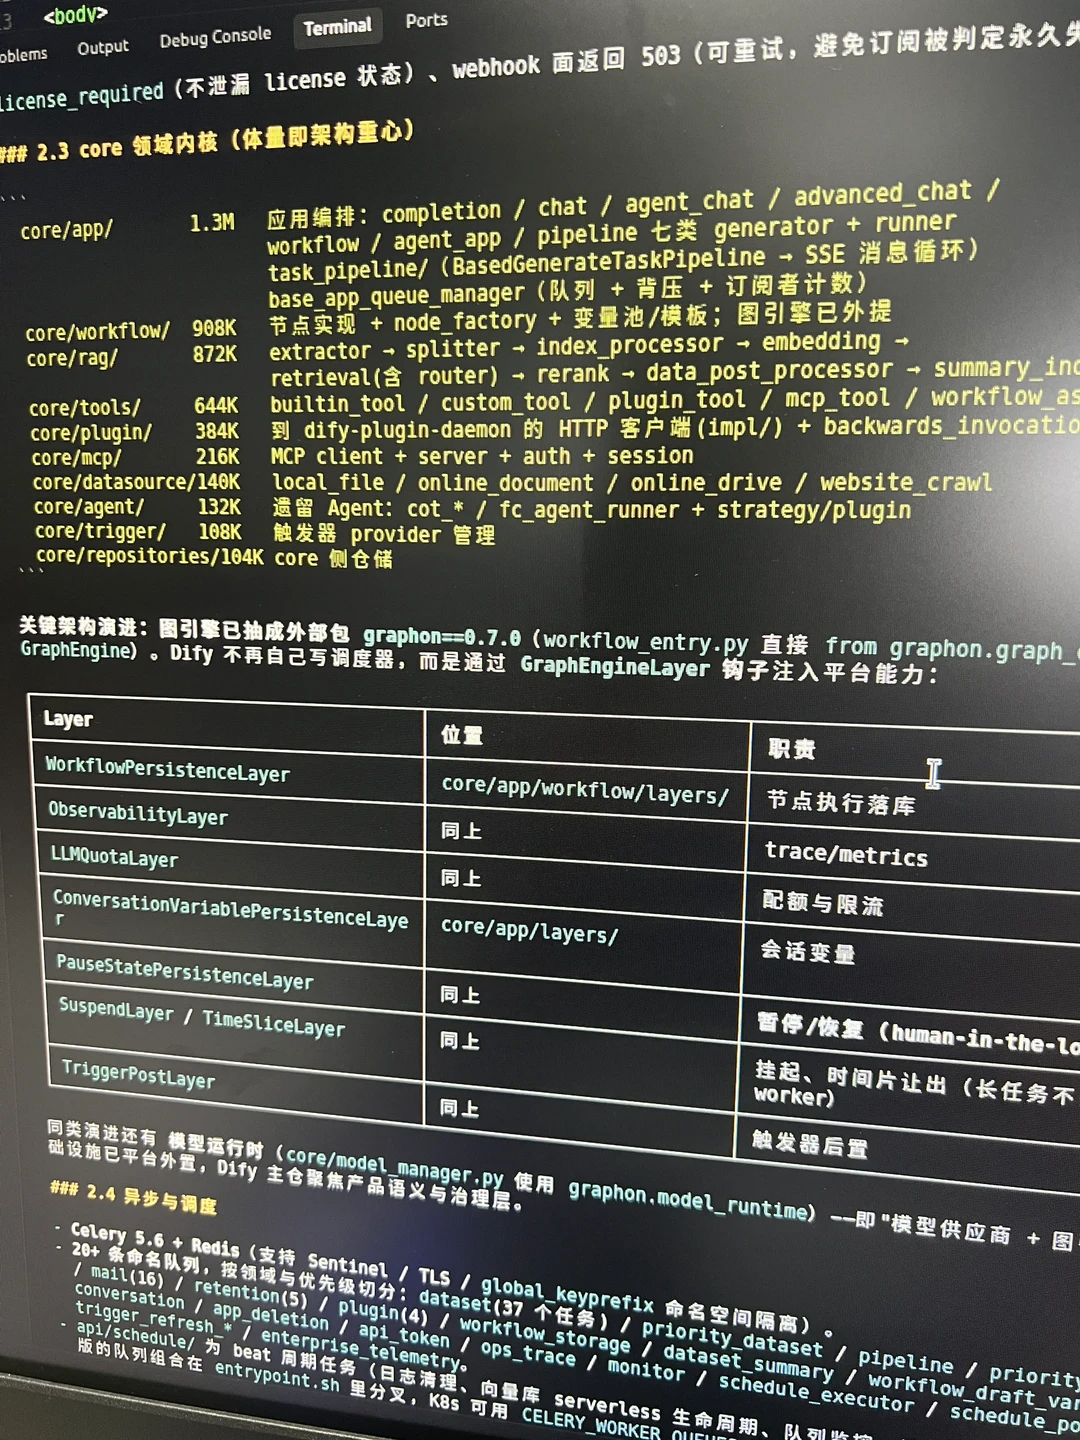
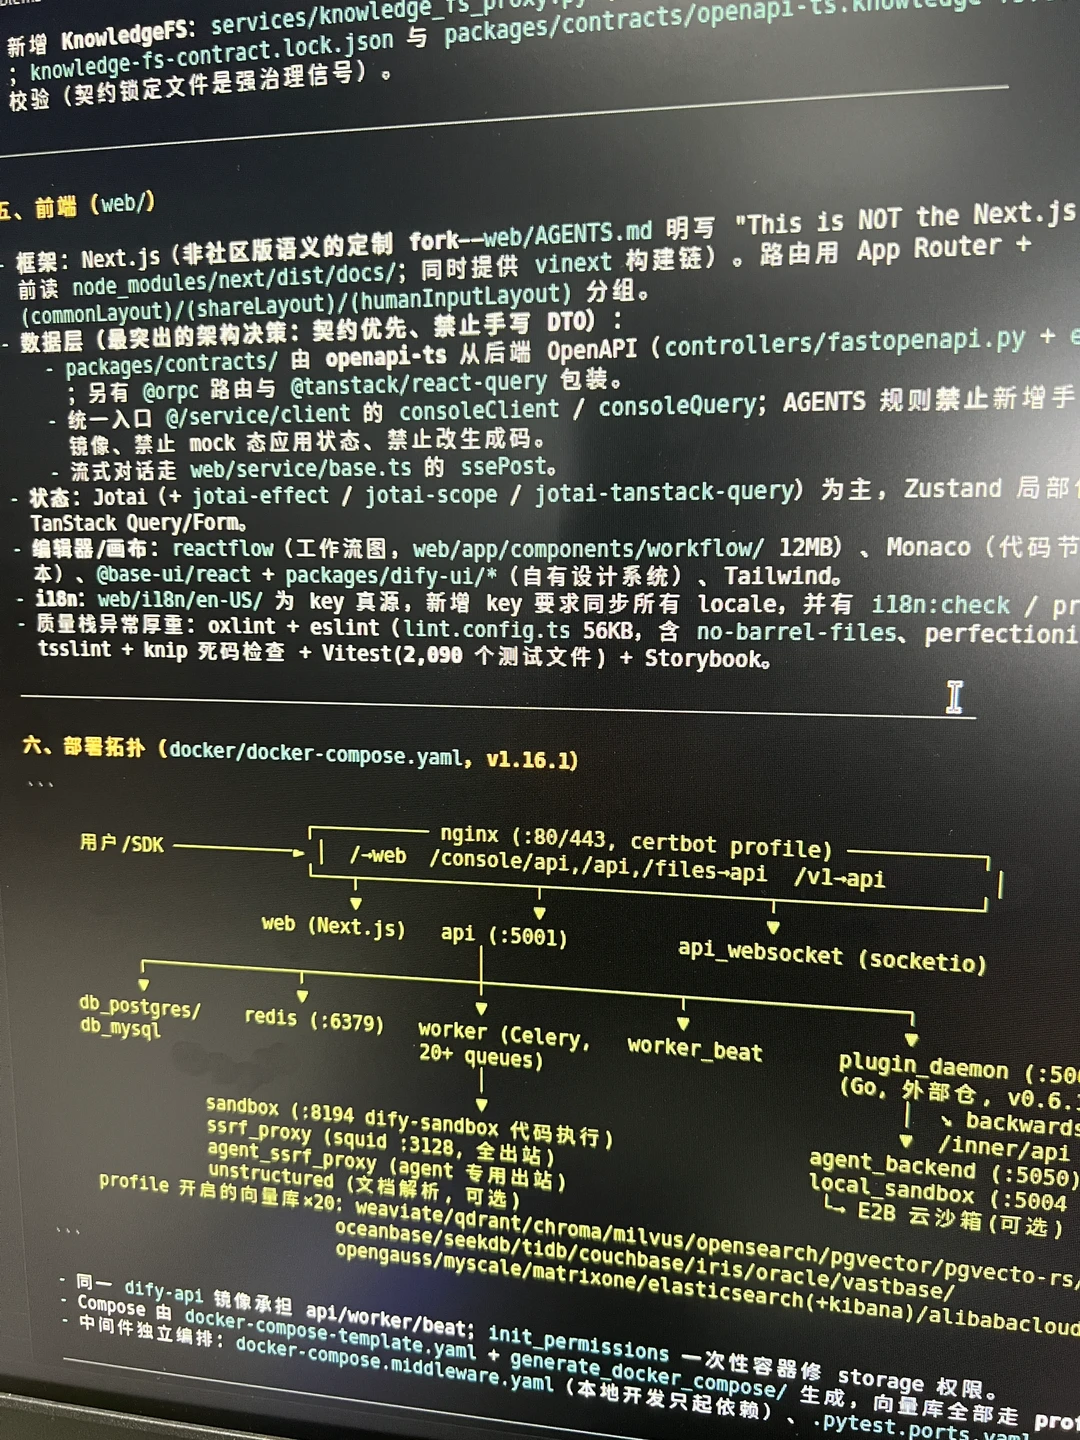
测试一下分析代码的能力如何,惊呆了,条理清晰,响应速度也很快,Dify这个仓库的代码有200万行的代码
模型分析了整体形态,后端分层,启动装配,api,core内核,异步调用,agent子系统,rag,前端,部署拓扑,请求链路,设计优点,风险与技术债
对于这个效果,简直惊呆了,本地有一个claude opus4.6 max级别的模型,终于实现ai token自由了。
#本地部署ai #codex#aiagent #claudecode