Agent 越来越强之后,一个有点反直觉的问题出现了:不是模型不会,而是快找不到合适的题给它学了。
混元最近的论文《Environment Evolution for Terminal Agents》,研究的就是这件事。
作者一开始收集了 47,678 个 Terminal Environment,经过可解性、Verifier、任务质量等一系列过滤,最后真正符合要求的只有 127 个。
这其实暴露了 Agent RL 的一个新瓶颈:高质量 Environment,正在变成稀缺资源。
为什么?
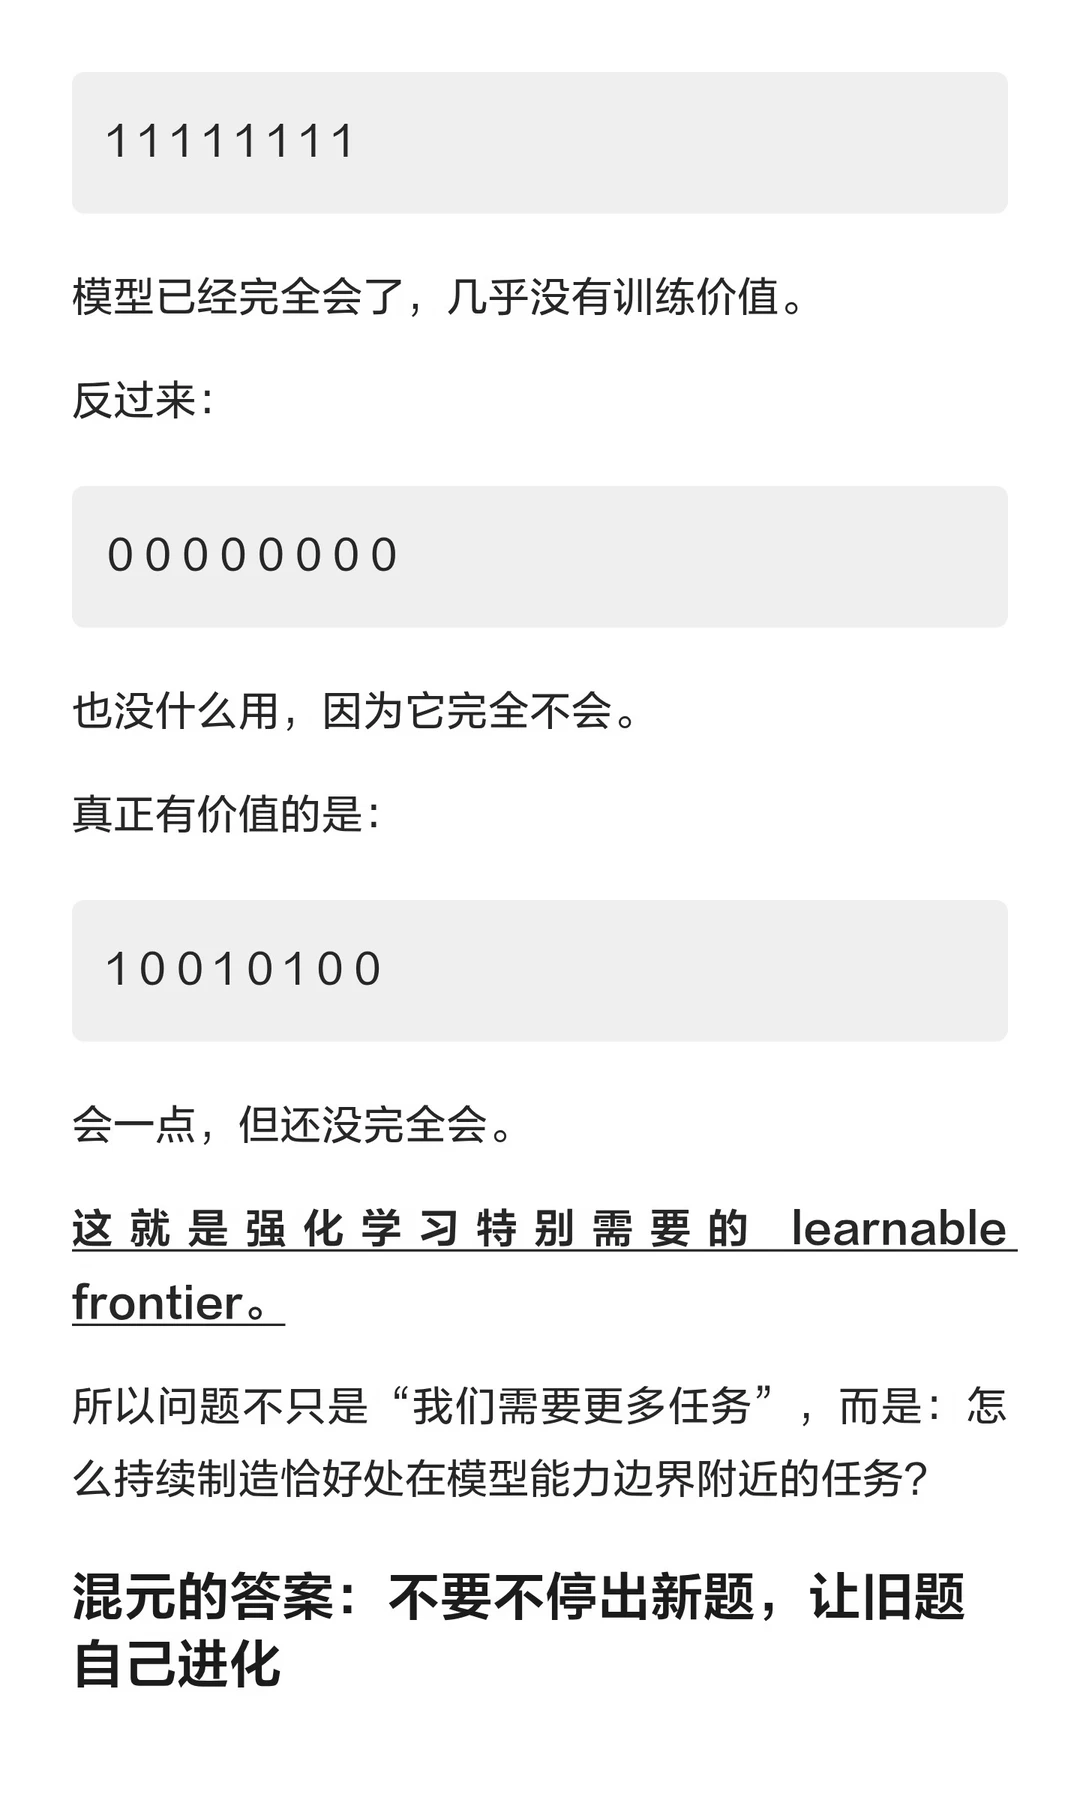
假设一个任务让 Agent 跑 8 次:全会了,没什么训练价值。完全不会,同样学不到多少。
真正有价值的就是:差一点就会。
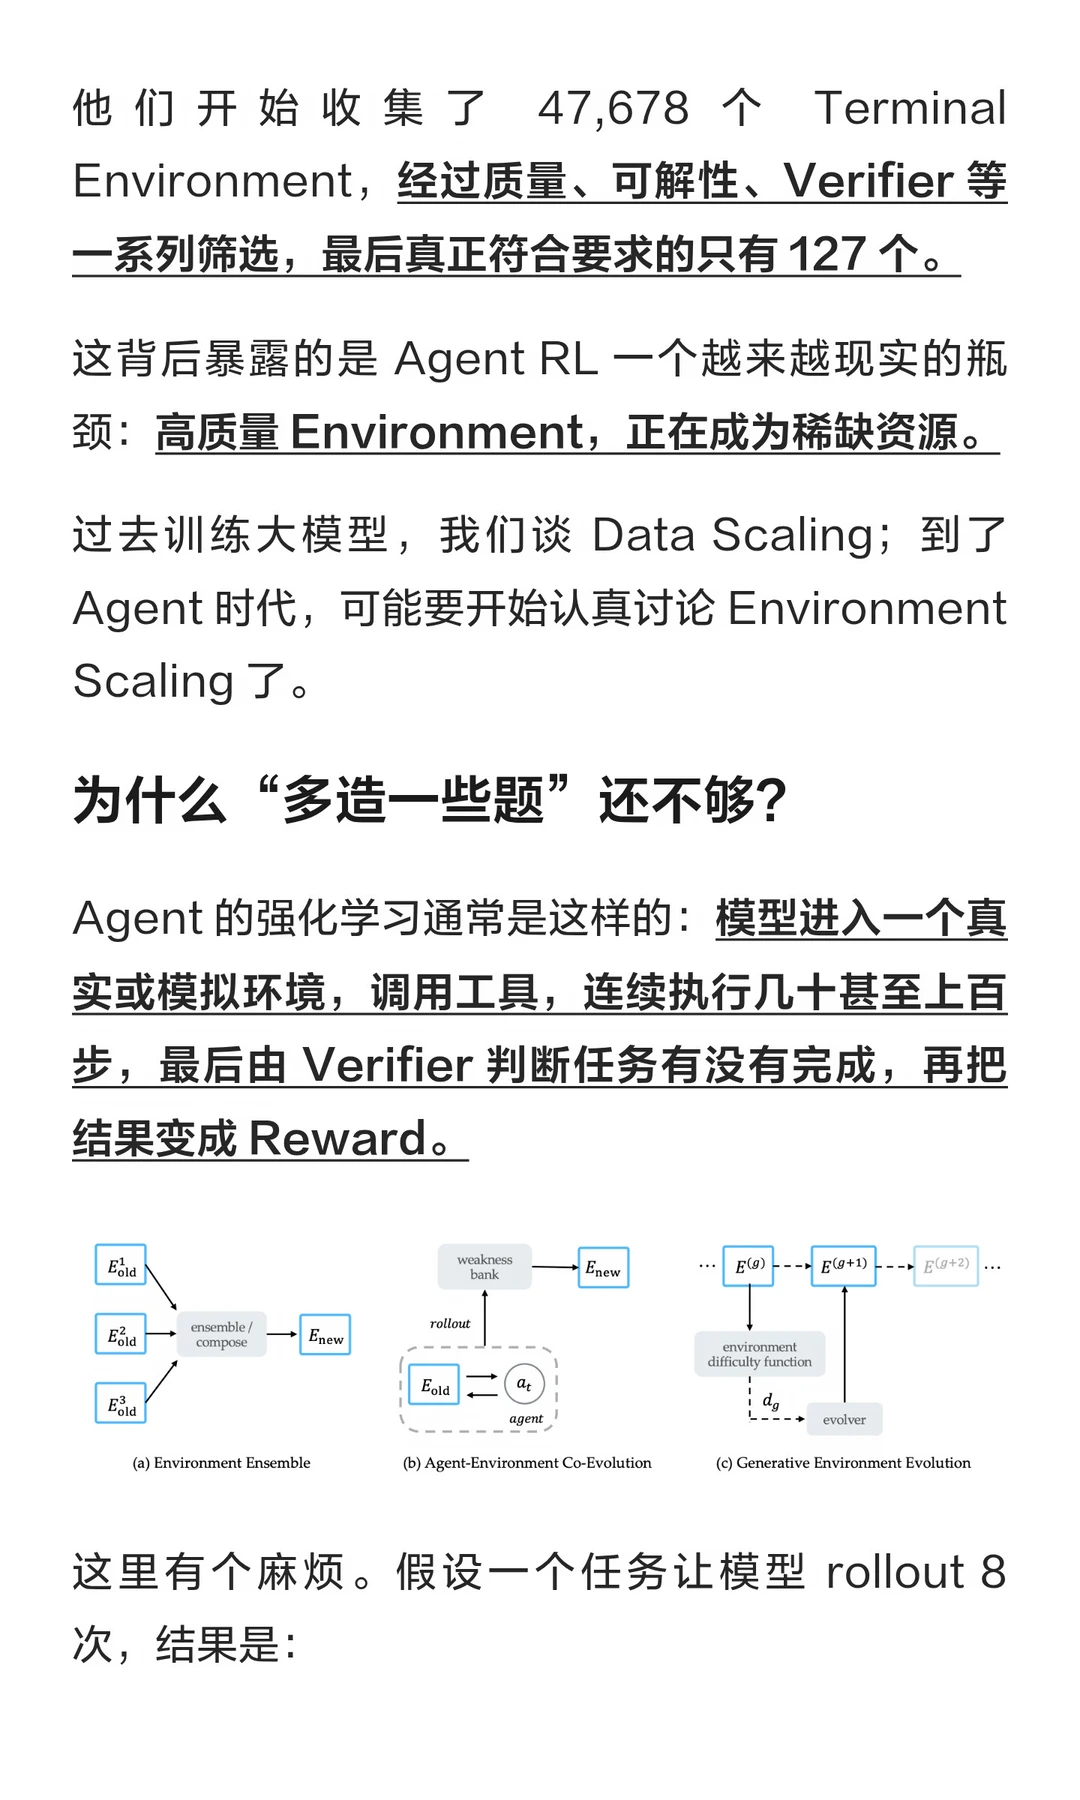
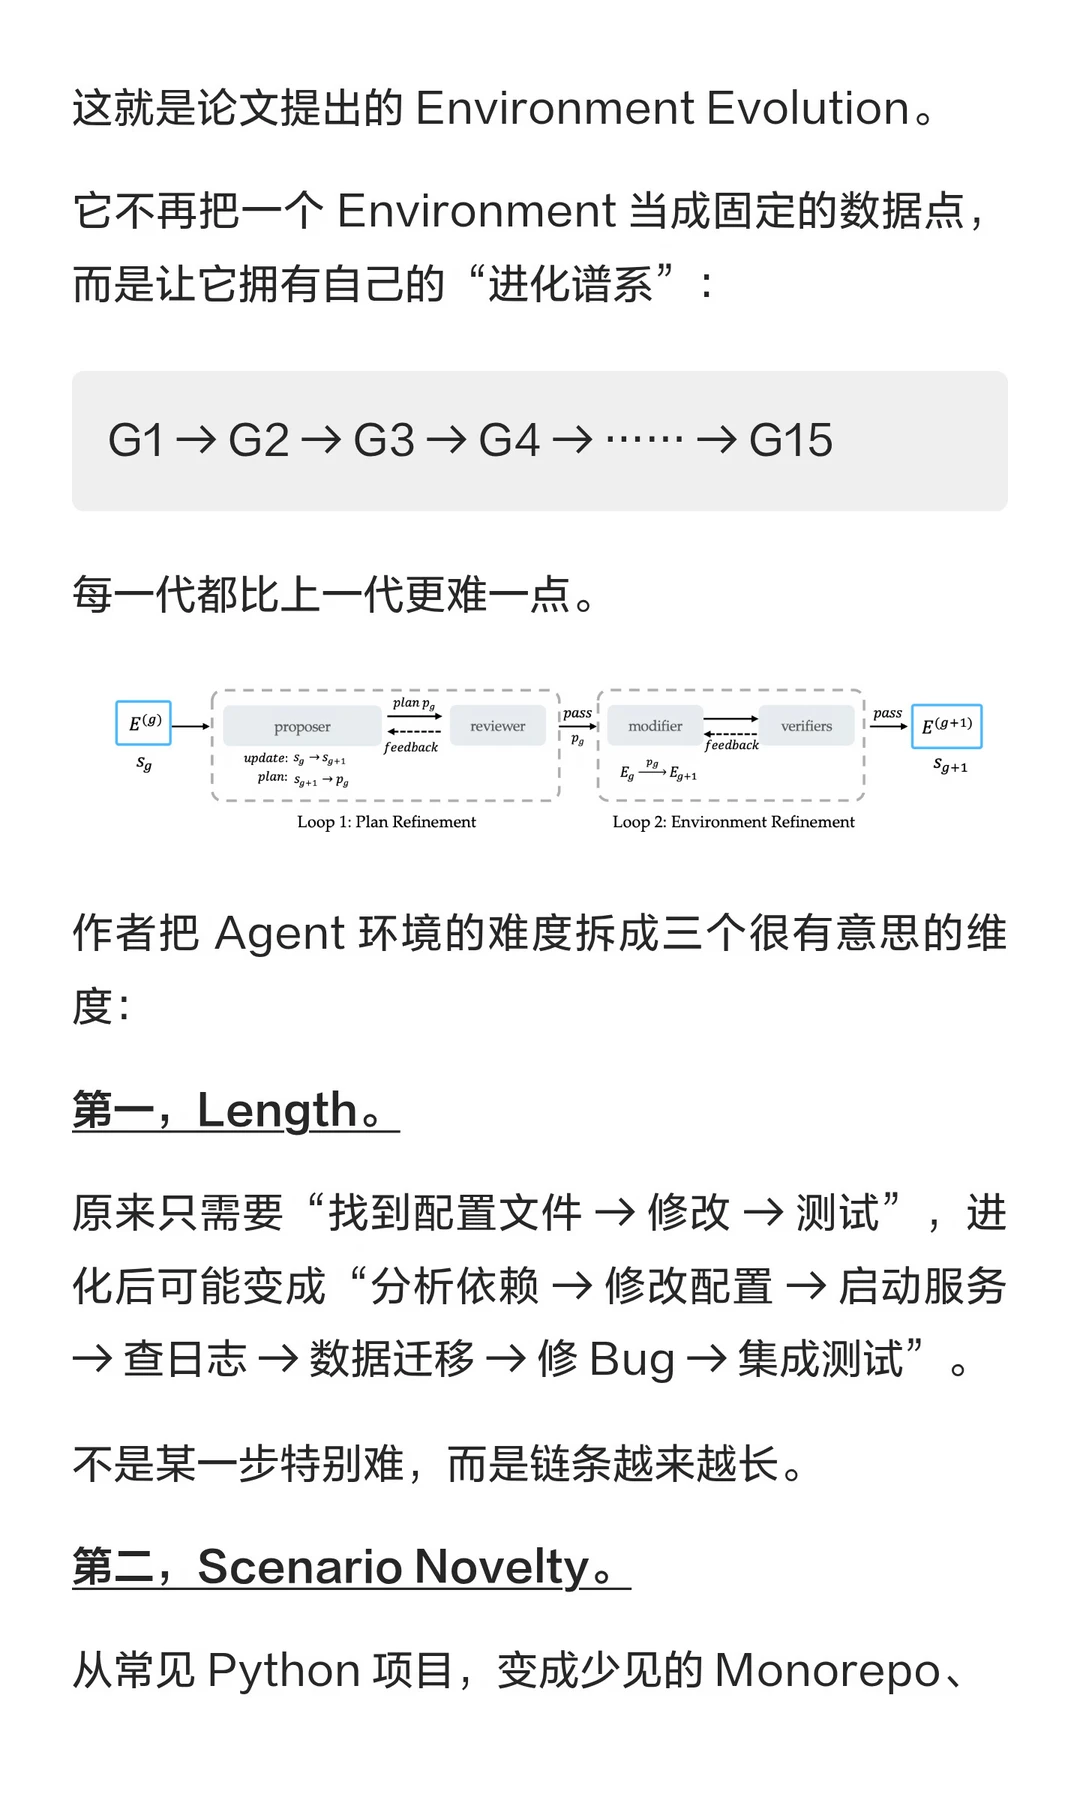
腾讯提出的 Environment Evolution,就是让训练环境自己不断进化。
每一代只比上一代难一点。
它主要从三个方向进化:Length:执行链越来越长;Scenario Novelty:场景越来越陌生;Skill Rarity:需要的技能越来越稀有。
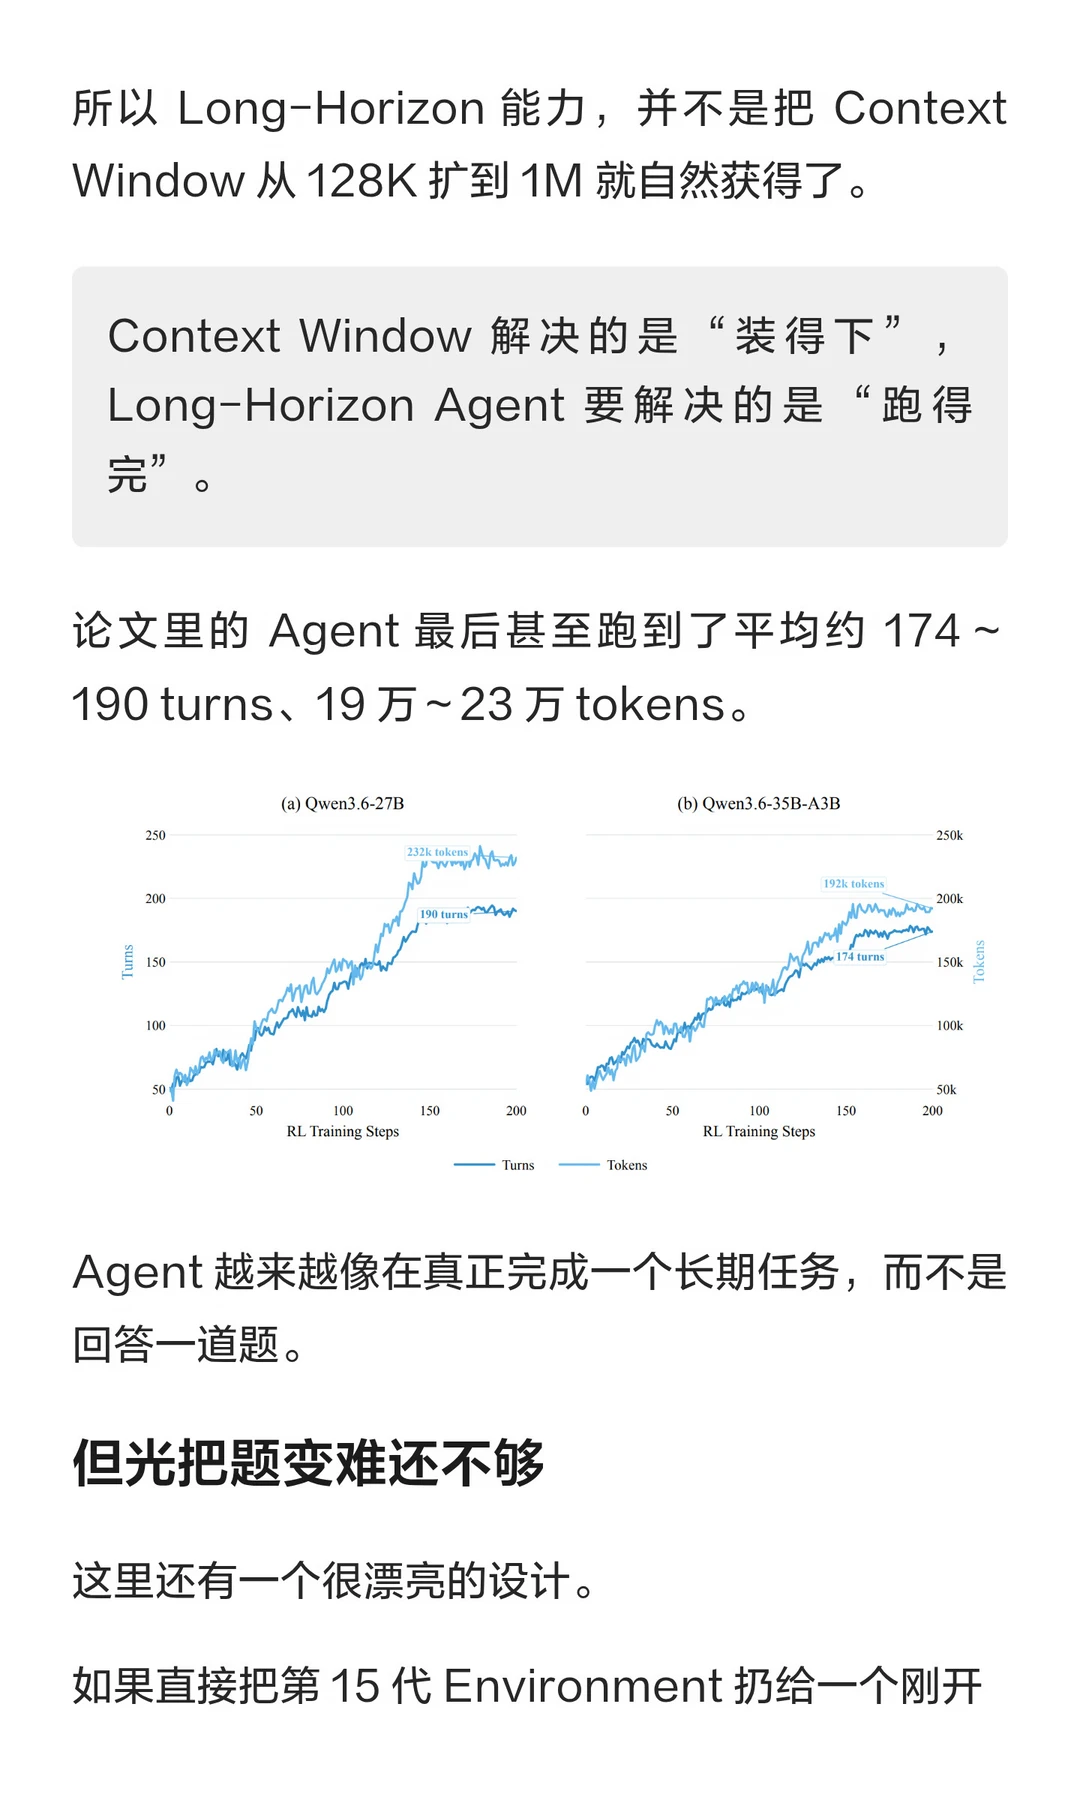
实验里一个很值得注意的结果是:Length Evolution 对 Agent 成功率打击最大。
这说明今天很多 Agent 真正的瓶颈,不一定是某一步不会,而是事情一长就容易崩。
Context Window 解决的是“装得下”。Long-Horizon Agent 要解决的是“跑得完”。
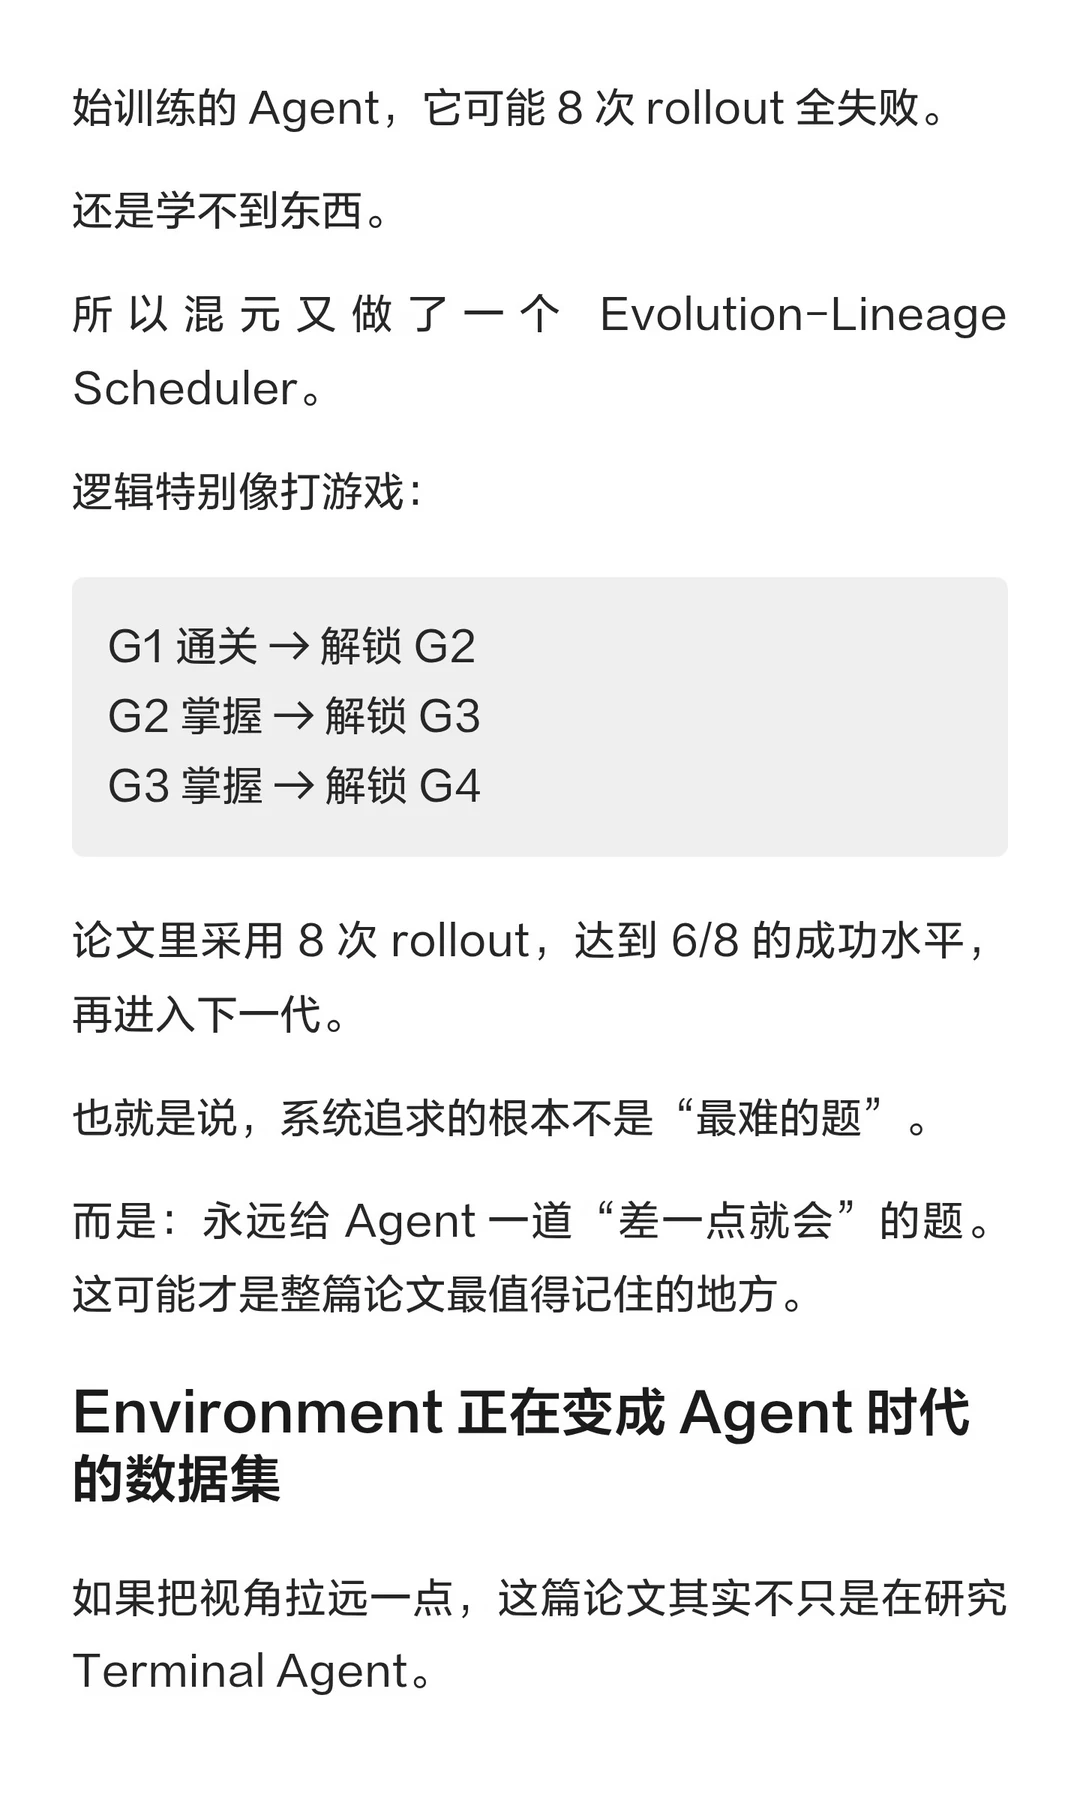
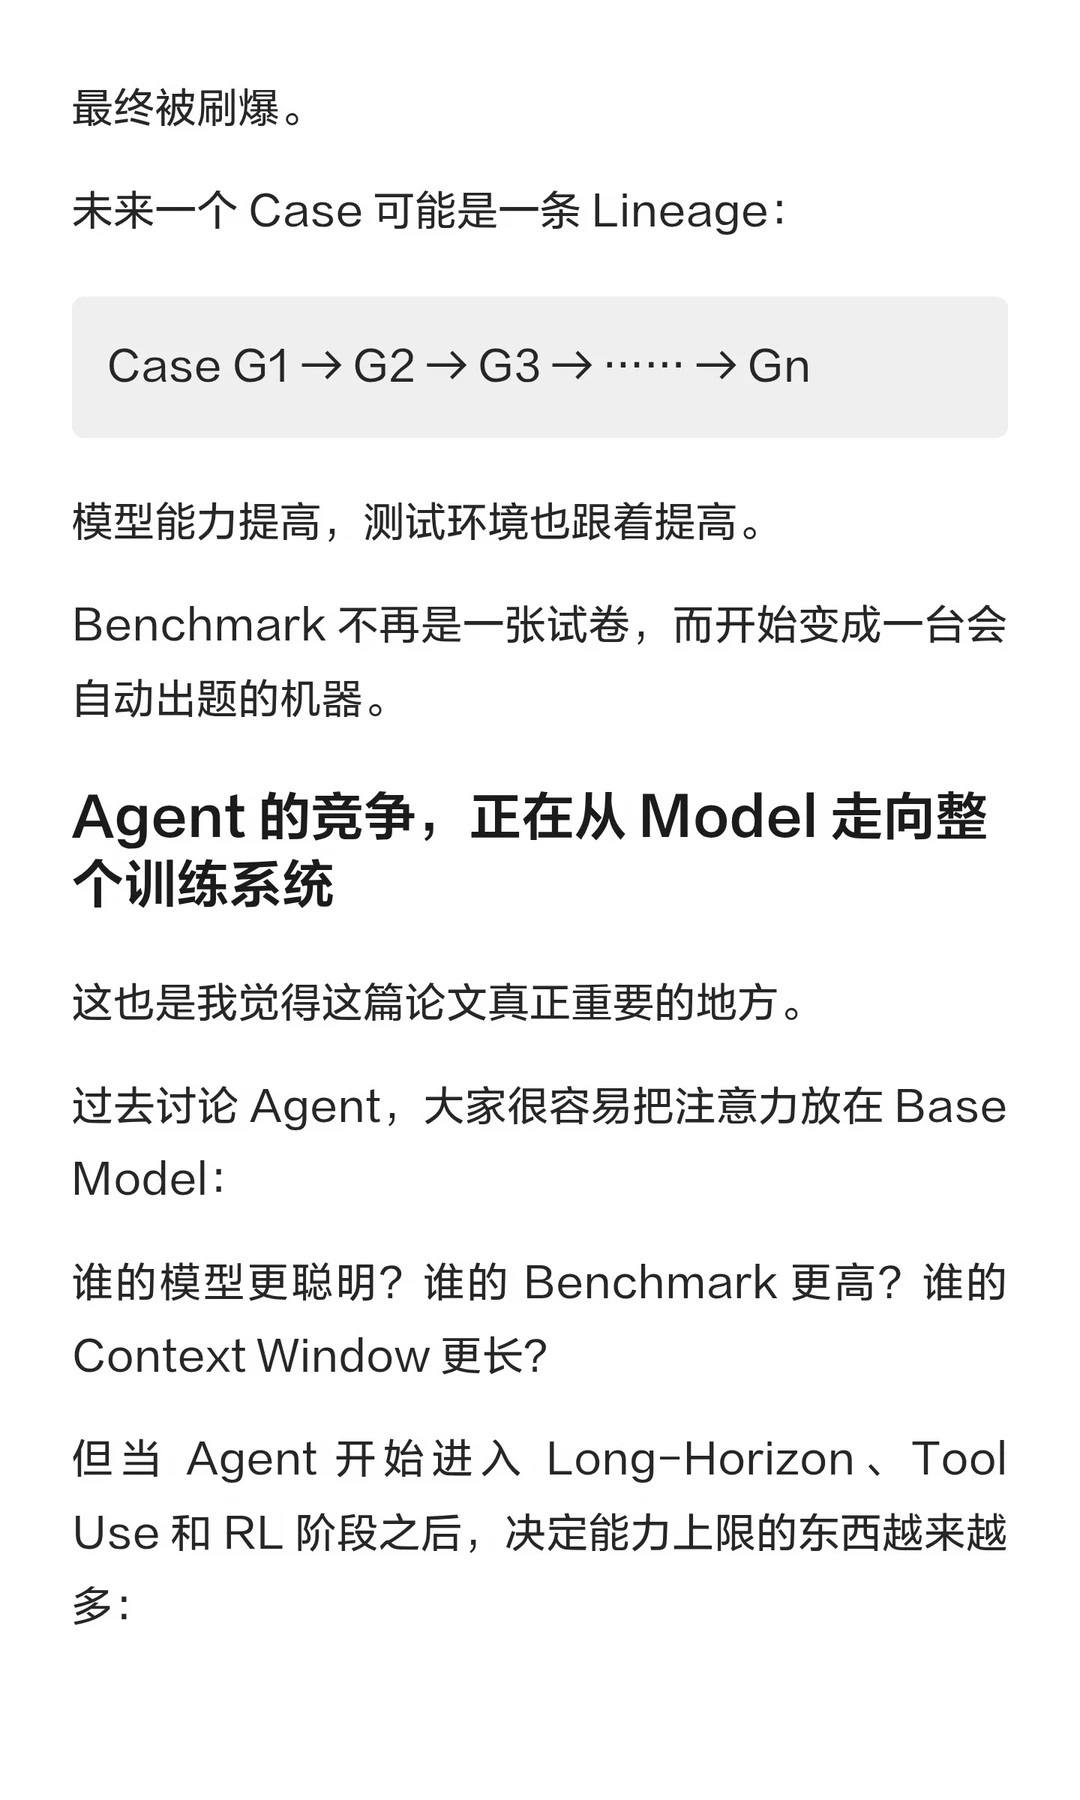
论文还设计了一套类似闯关的 Curriculum:
G1 掌握了,才解锁 G2; G2 掌握了,再进入 G3。
目标不是给模型最难的题,而是永远把它放在:“再努力一点就能学会”的区域。
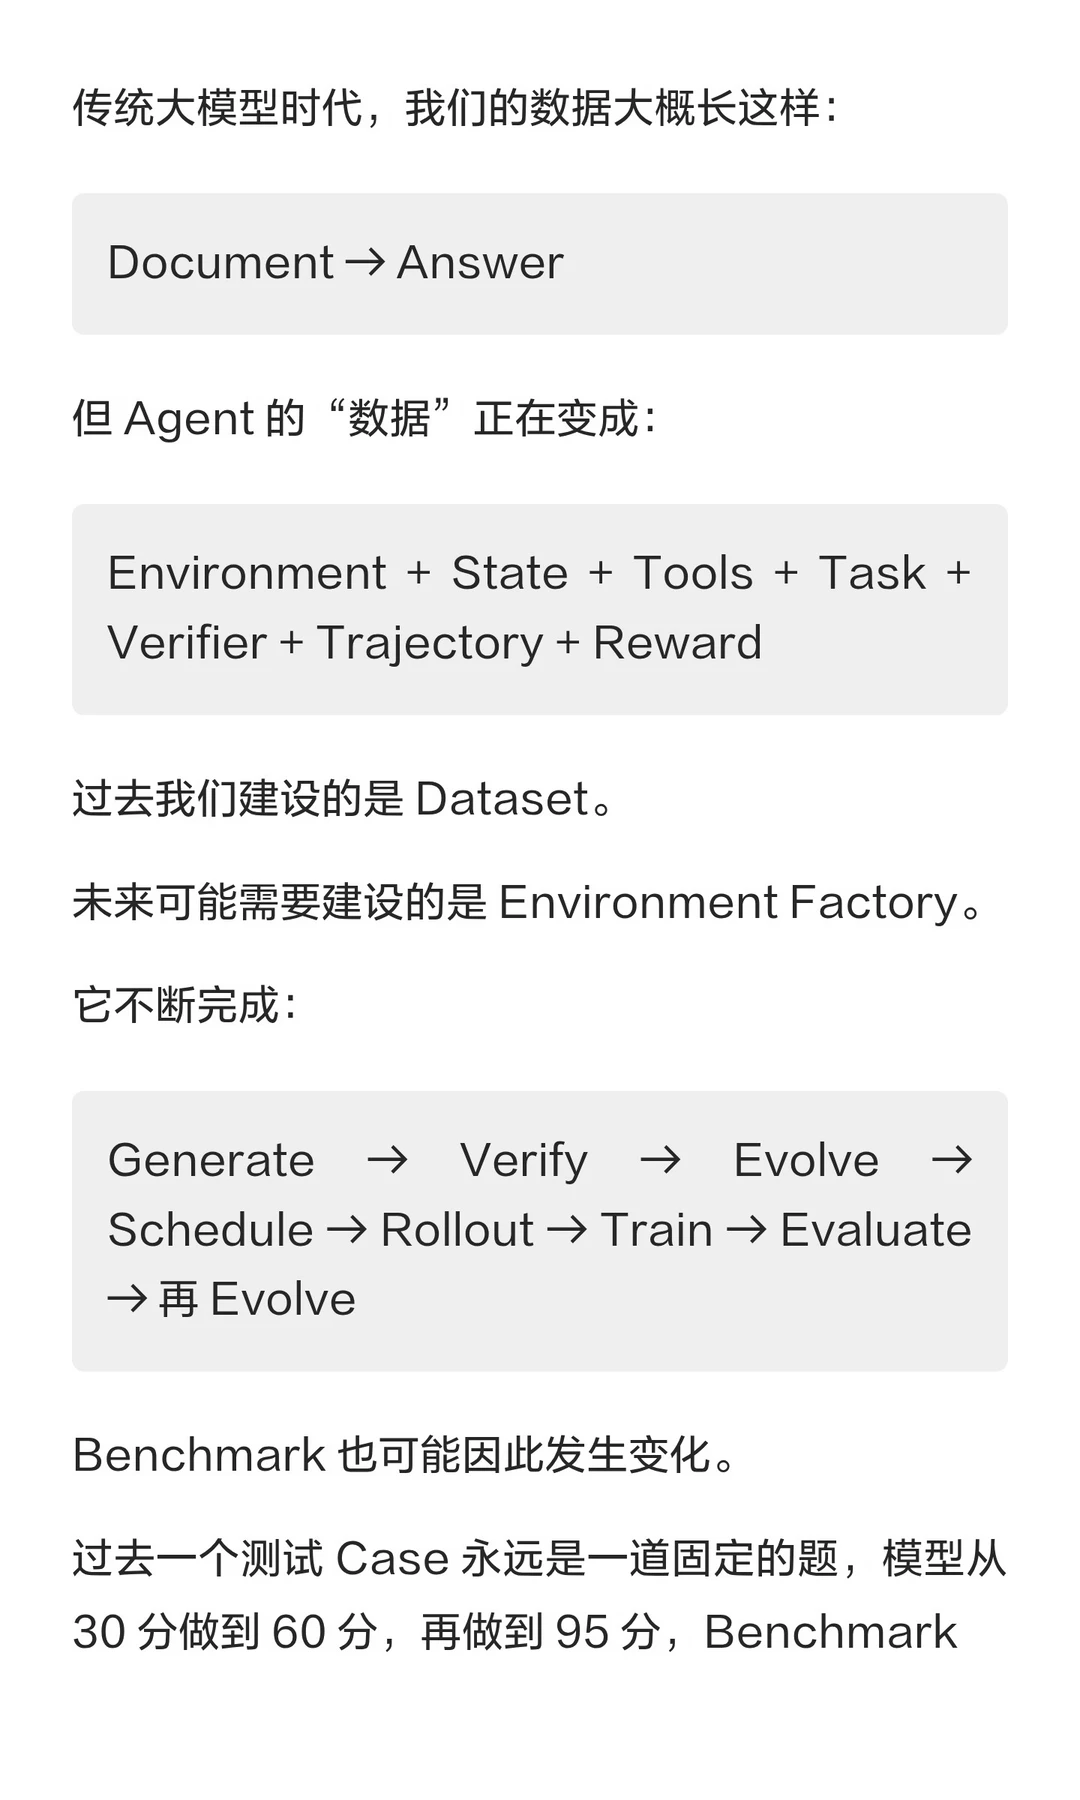
过去大模型时代,我们卷 Data Scaling。
到了 Agent 时代,下一阶段可能要开始卷:Environment Scaling。
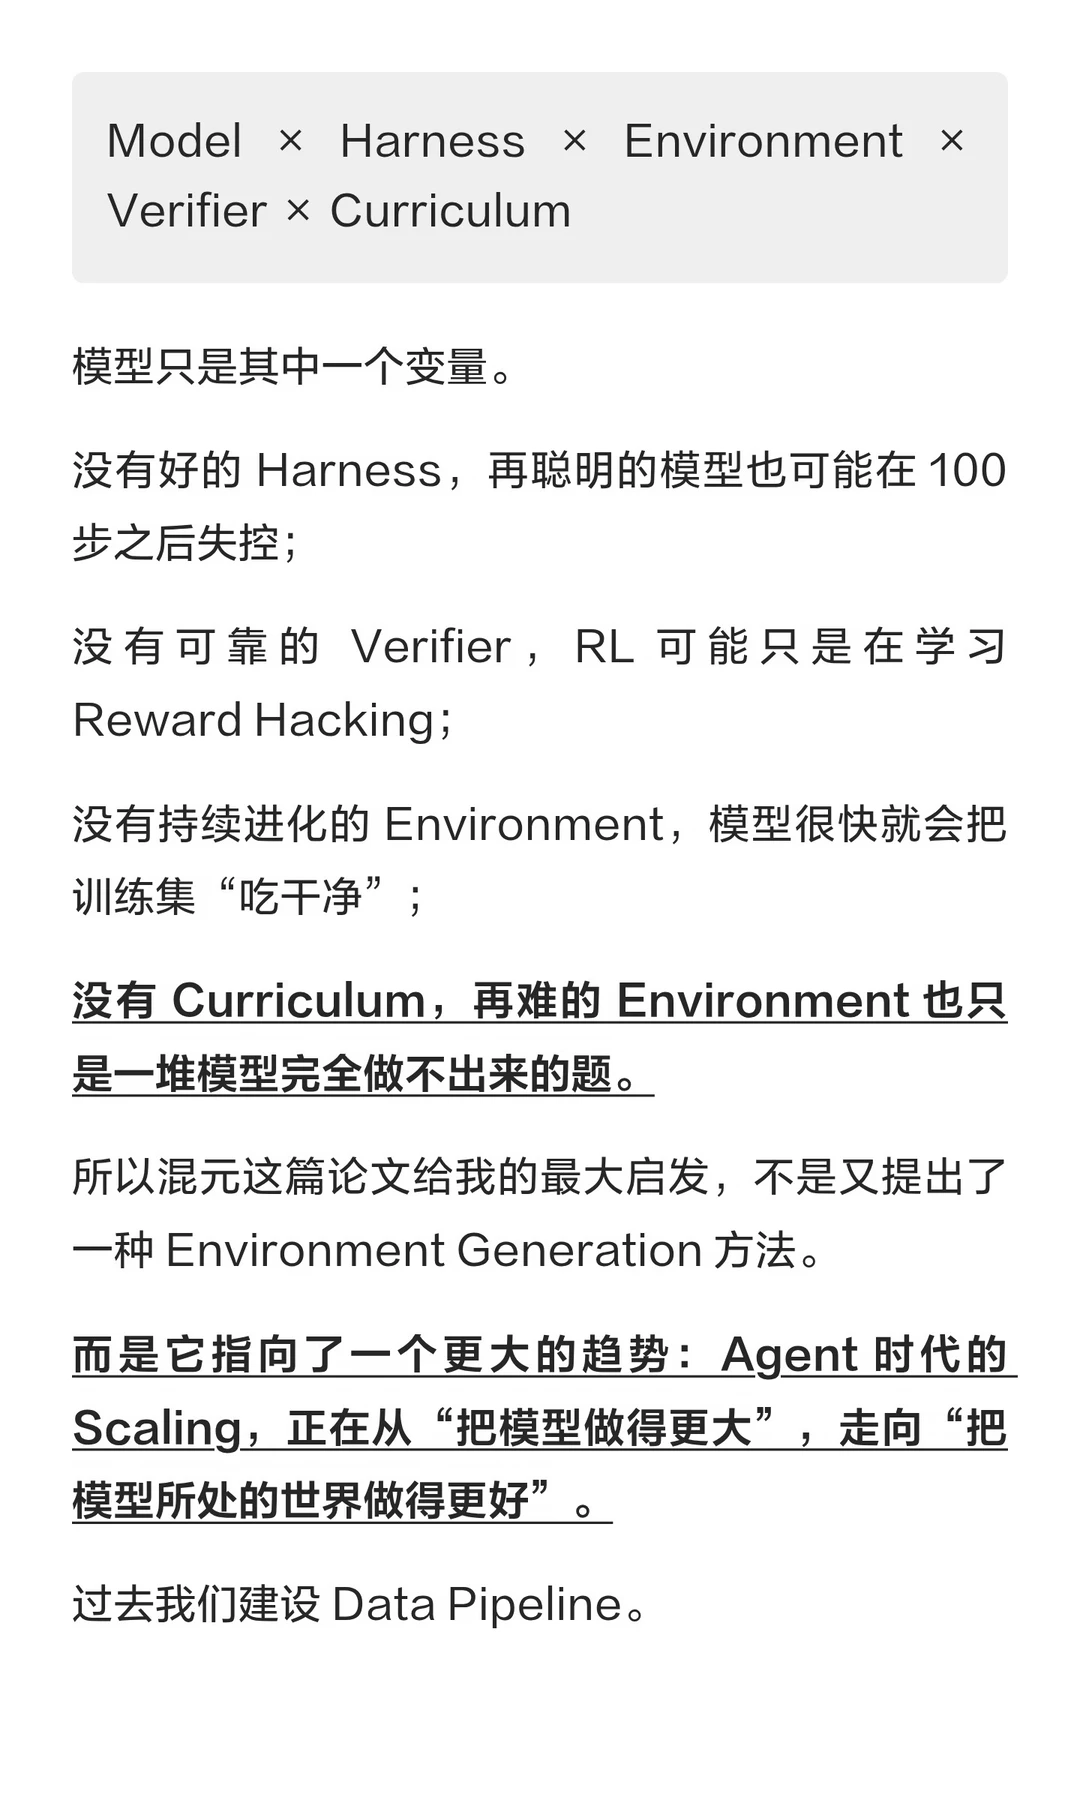
未来 Agent 的能力上限,可能越来越取决于:Model × Harness × Environment × Verifier × Curriculum。
让训练场本身,也跟着 Agent 一起进化。
#AIAgent #腾讯混元 #强化学习 #EnvironmentEvolution #AgentRL #Harness #LongHorizon #AI研究 #自进化 #AI反常识howto