Netflix 的论文《The Lifecycle of LLM-as-a-Judge for Large-Scale Recommendation Explanations》,讲述了他们如何把 Judge 真正做进了生产系统。
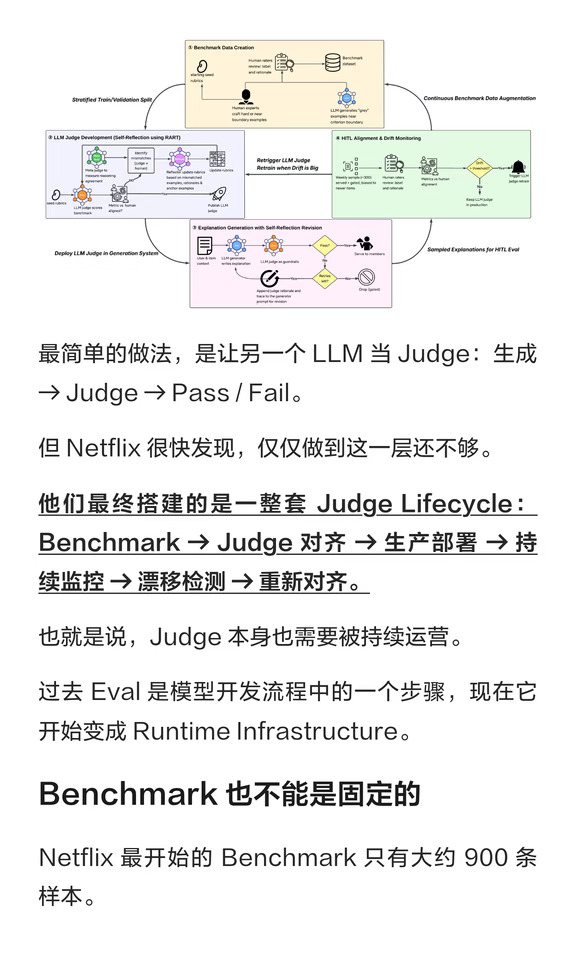
但 Netflix 的 AI Eval 思路演化成:生成 -> Judge -> 修正 -> 监控 -> 再对齐 -> 继续生产。
也就是说,Eval 不再只是上线前的一场考试,而开始变成 Runtime 的一部分。
他们的场景是推荐解释。LLM 每周生成大量推荐文案,人工显然不可能逐条看,于是引入 Judge 判断内容是否相关、准确、清晰、安全。
但 Netflix 很快发现,光判断 Pass / Fail 还不够。
因为 Judge 不只是裁判,还会把“为什么失败”反馈给 Generator,让它重新修改。
但是判断对了,不代表理由对了。
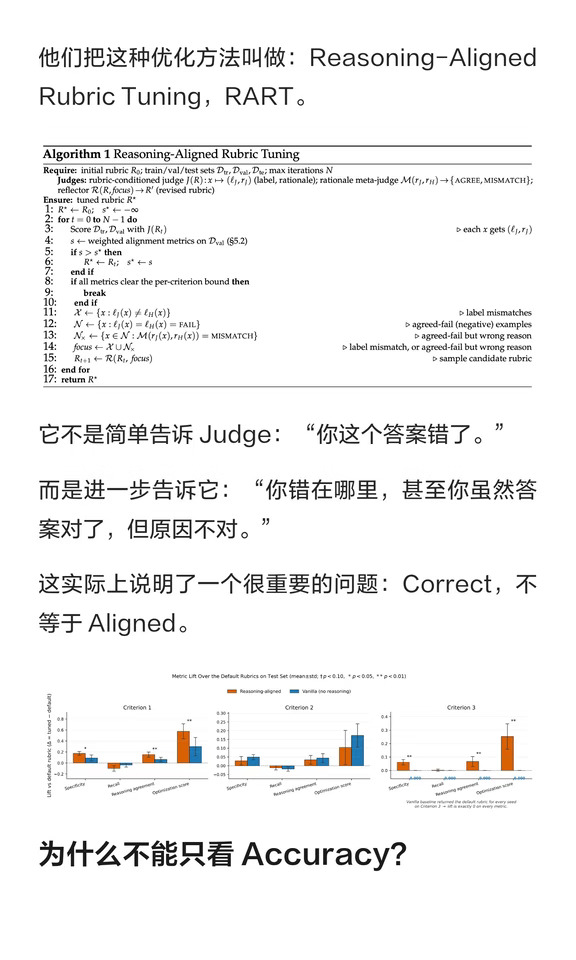
于是他们提出 RART - Reasoning-Aligned Rubric Tuning,不仅看 Judge 和人工的 Label 是否一致,还要比较双方的判断理由是否一致。
未来更有价值的数据会变成:Input -> Output -> Label -> Rationale -> Evidence。
还有一点值得关注,是 Netflix 把 Benchmark 做成了 Living Benchmark。
系统上线后,每周继续从生产流量里抽样,让人工复核。
一旦发现新的失败模式,这些数据就继续进入 Benchmark,再反过来更新 Judge。
这对 Agent 场景尤其重要。
未来 Judge 可能不只是负责“打分”,而是进一步决定:是否放行、是否重试、怎么修改、什么时候提示、什么时候重新对齐。
换句话说,Judge 正在从 Evaluator 变成一种 AI Control Plane。
我觉得这也是 Agent Harness 接下来很重要的一层:Eval 不再只是测试 AI,而是运行 AI 的一部分。
#AI #AIAgent #LLM #LLMJudge #AgentEval #AI评测 #AgentHarness #Netflix #人工智能 #AI反常识howto