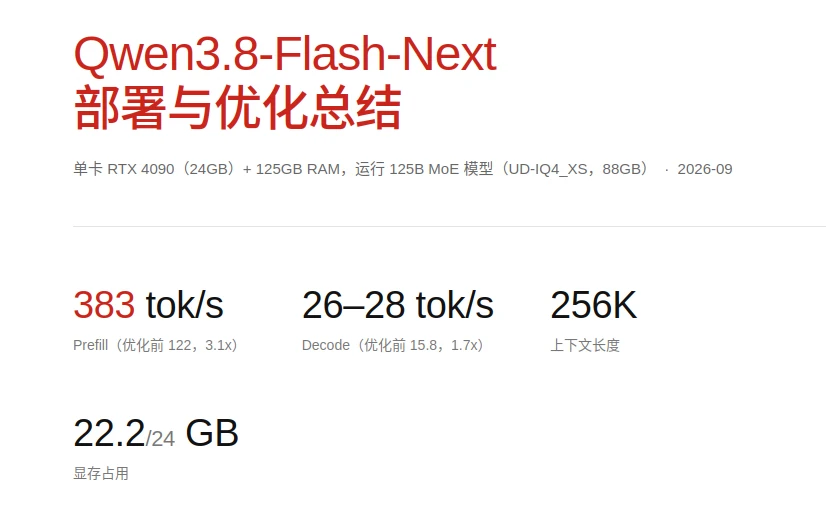
模型Qwen3.8-Flash-Next Q4_XS
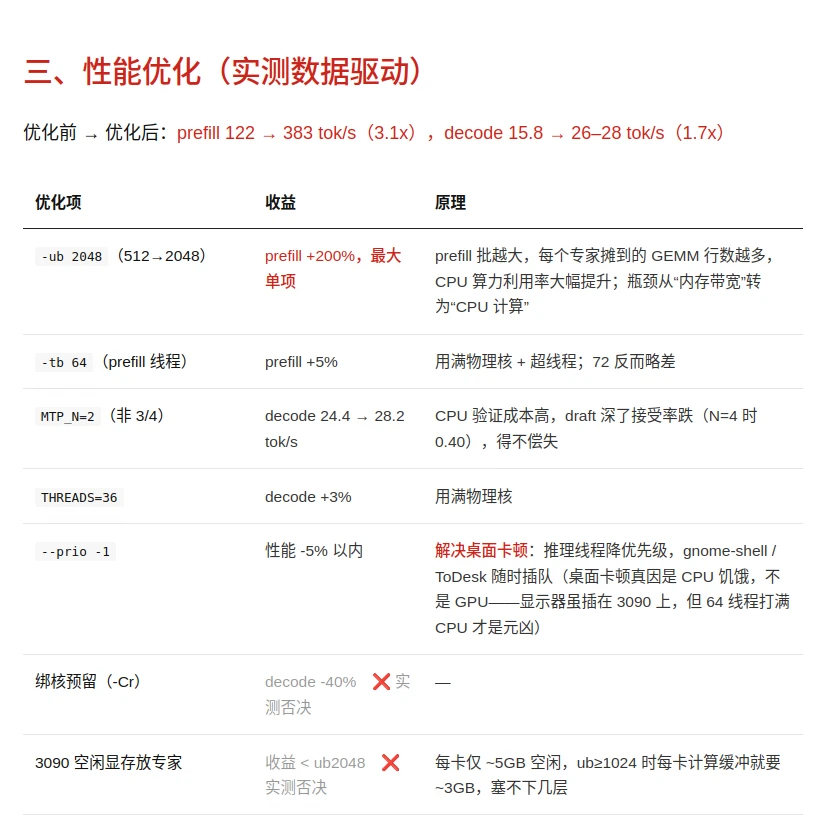
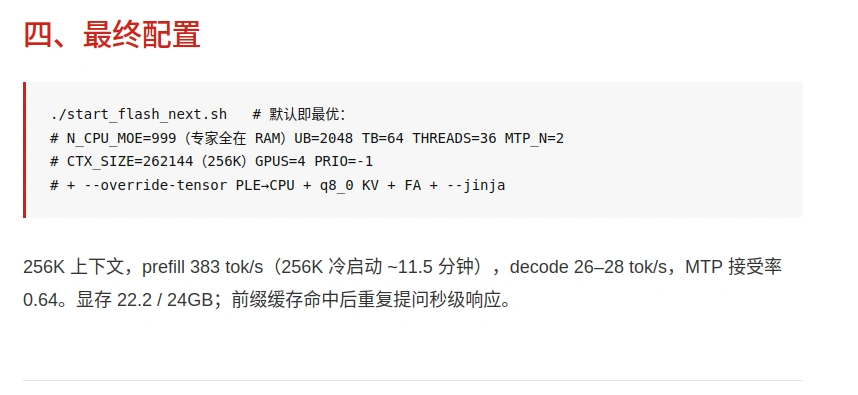
prefill 383
Decode 30
如果要实现单卡部署的话,而且还要保证模型的质量没有什么下降的话,Q4的量化比较合适的,上下文选择256K
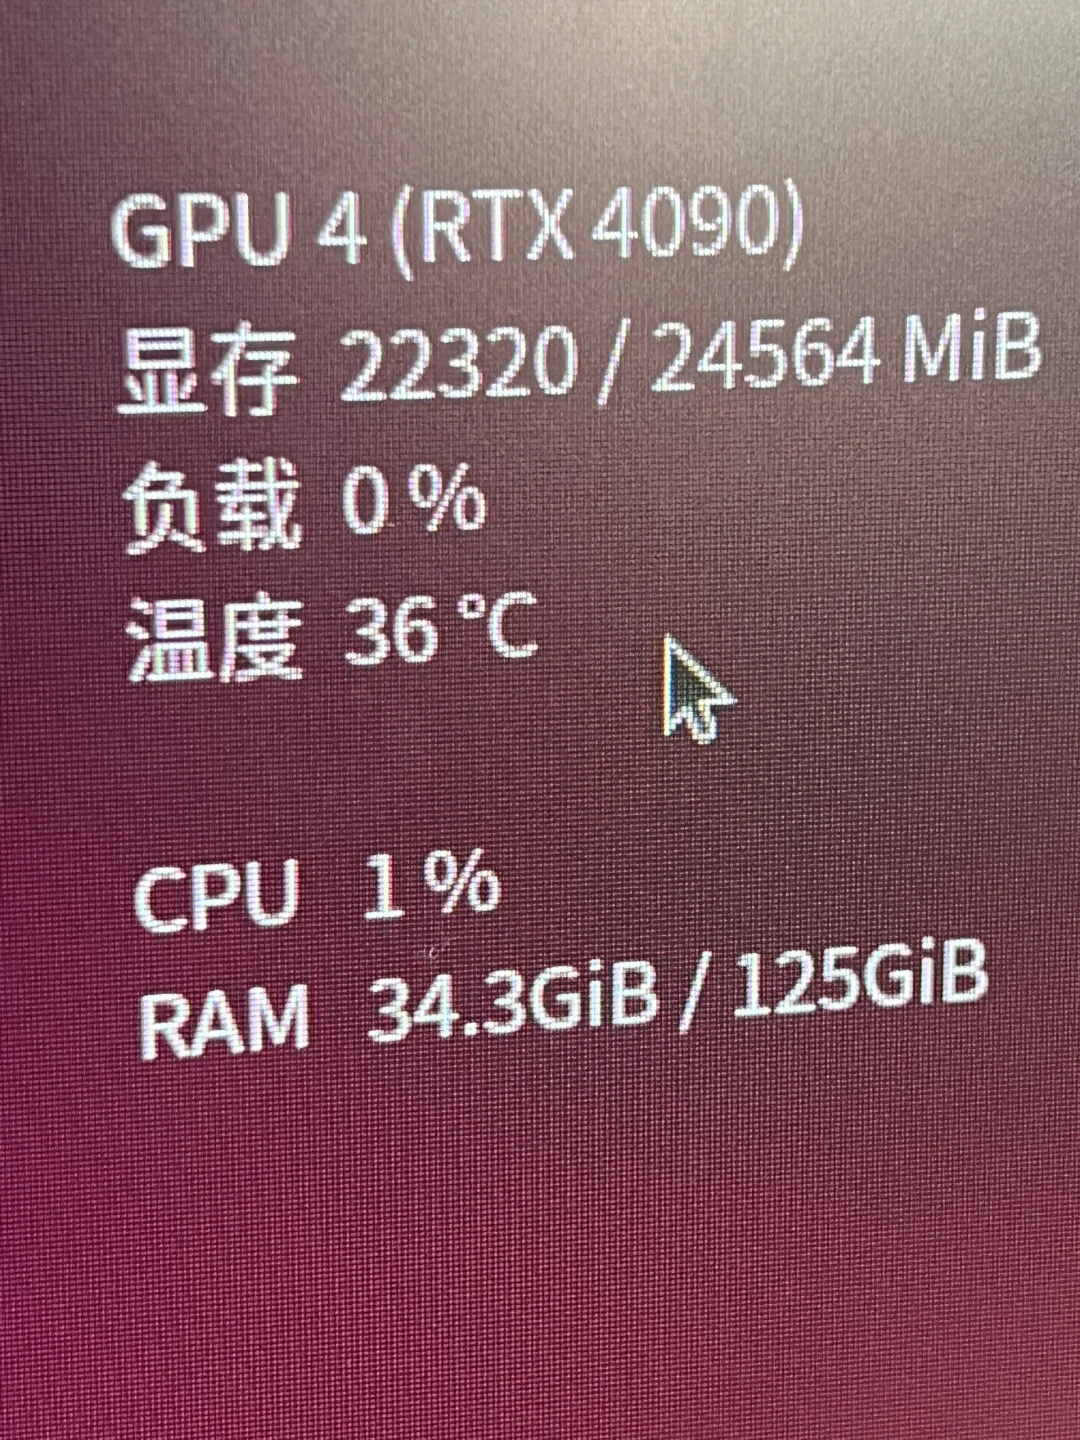
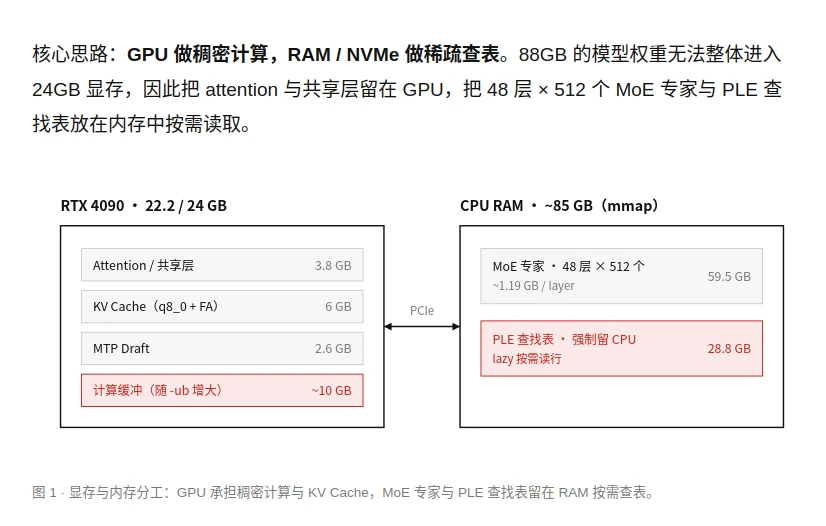
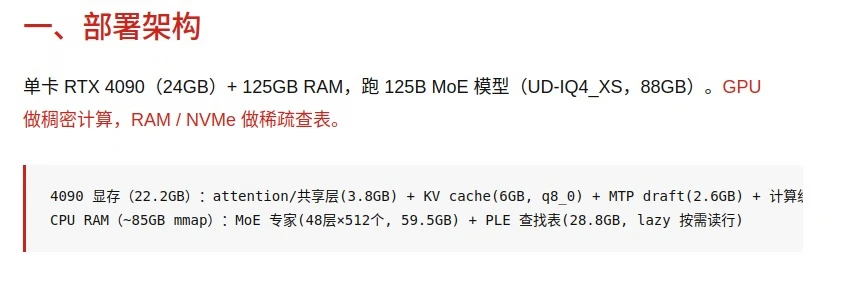
把模型的attention的22G部署到GPU,moe和ple一共85G部署到内存
Qwen3.8-Flash-Next Q4_XS这个模型基本相当于Glm5.3 flash这个水平,对于编程和本地的agent来说已经完全的够用了。本地部属的好处就是可以无限的使用。完全不用考虑token的费用。#本地部署模型 #codex #pi #大模型 #本地部署ai