最近千问开源了一个很有意思的项目:MyContext。
第一眼看,它很像 RAG、知识库或者 Agent Memory;但真正翻代码后,我觉得它想解决的问题更大:怎么让 AI 持续理解一个人的工作世界。
今天很多 Agent 最大的问题,不是不会推理,而是每次启动都像第一天入职。
你问它:“上次那个方案后来怎么定了?”
答案可能散落在群聊、会议、文档和后续讨论里。传统 RAG 能帮你找回相关内容,但“找到了历史”不等于“知道现在什么才是真的”。
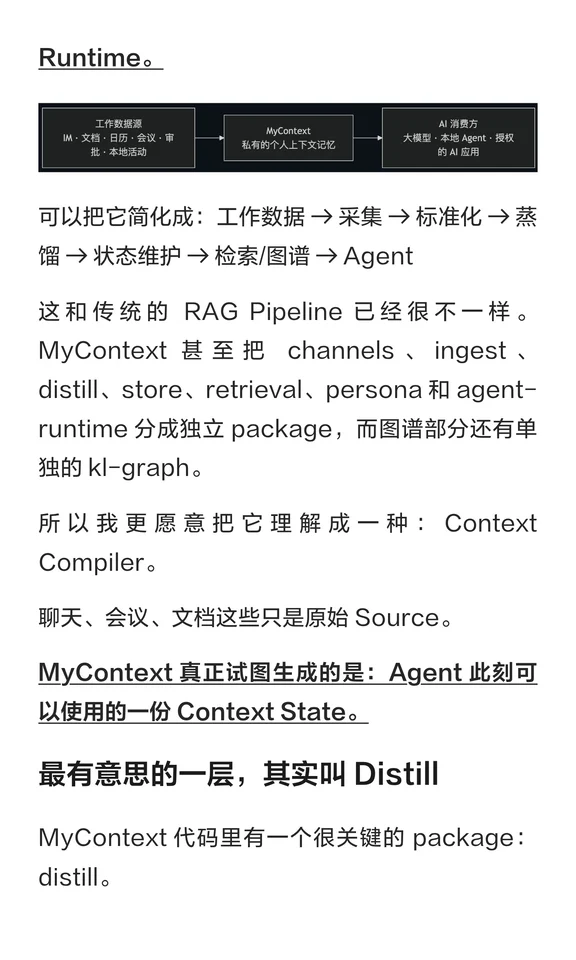
MyContext 做的事情更像一个 Context Compiler:工作数据 -> 采集 -> 蒸馏 -> 状态维护 -> 检索 / 图谱 -> Agent。
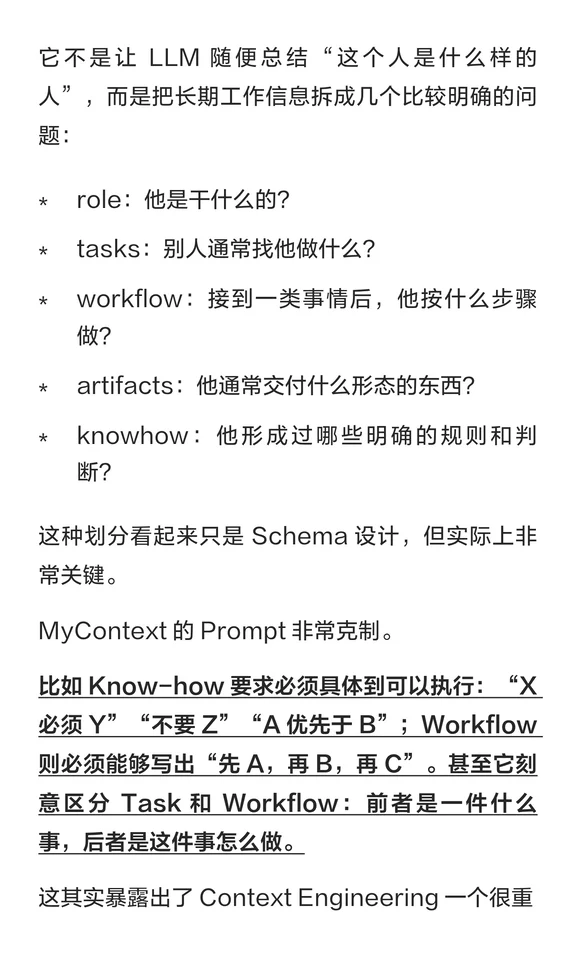
它会从工作记录中持续提炼 role、tasks、workflow、artifacts、knowhow 等结构化 Context,而不是只生成一份泛泛的用户画像。
更值得注意的是它对“可信 Context”的处理。
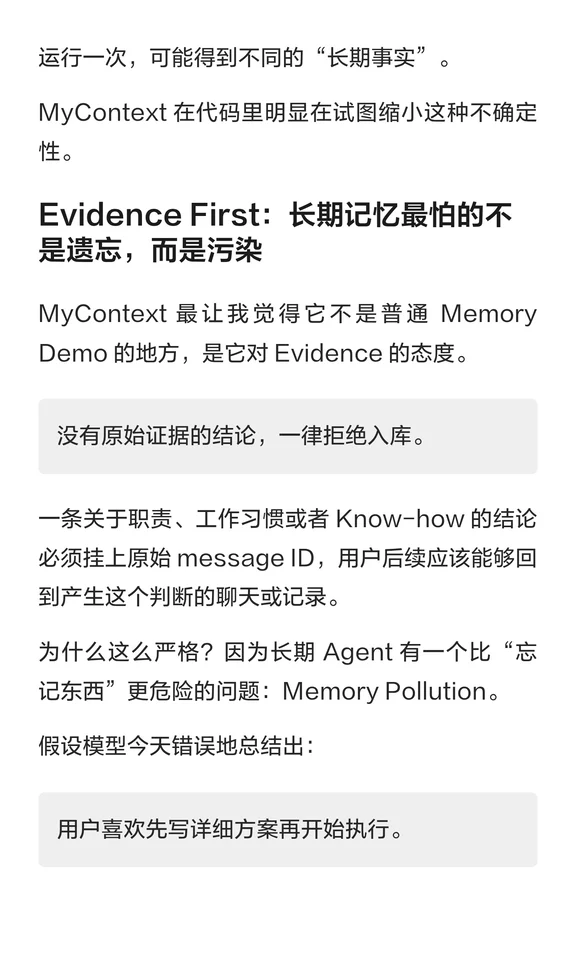
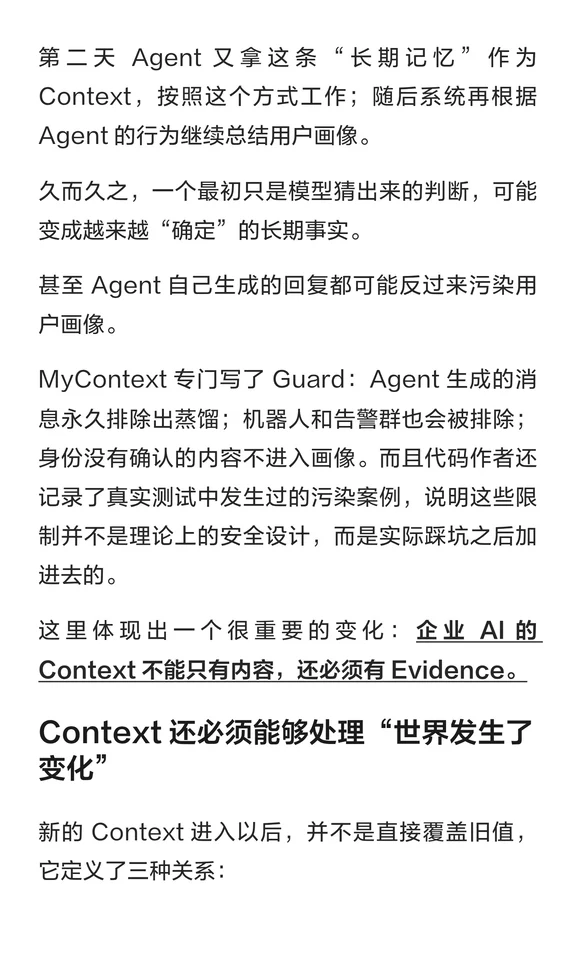
第一,Evidence First。 没有原始证据的长期结论,拒绝入库。Agent 自己生成的回复、机器人消息等,也会被排除,避免长期 Memory 被模型自己污染。
第二,Context 不是覆盖,而是演进。 新信息和旧信息之间分成 supplement、confirm、conflict。发生冲突时不会简单“取最新”,而是保留双方,降低置信度,必要时交给人处理。用户手工修正过的内容,则遵循 user_override_wins。
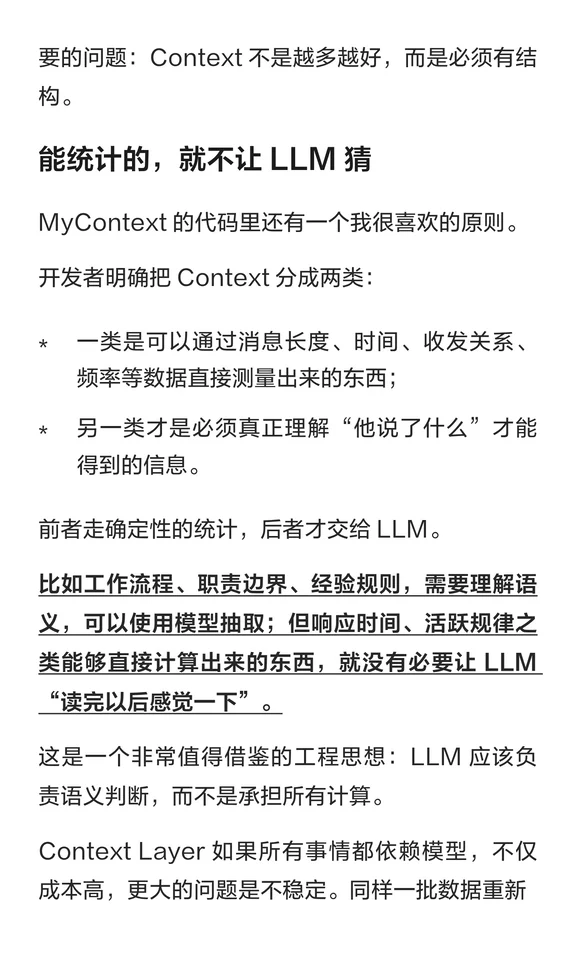
第三,能统计的就不让 LLM 猜。 响应时间、活跃规律等可以直接计算;只有职责、流程、经验这种必须理解语义的内容才交给模型。
第四,检索不只靠向量。 MyContext 同时组合全文检索、语义召回和知识图谱,再做多路融合。
MyContext 想解决的是:“在不断变化的信息里,现在应该怎样理解这个人的工作状态?”
#MyContext #ContextEngineering #阿里 #HarnessEngineering #Harness #RAG #AgentMemory #大模型 #Agent #AI反常识howto