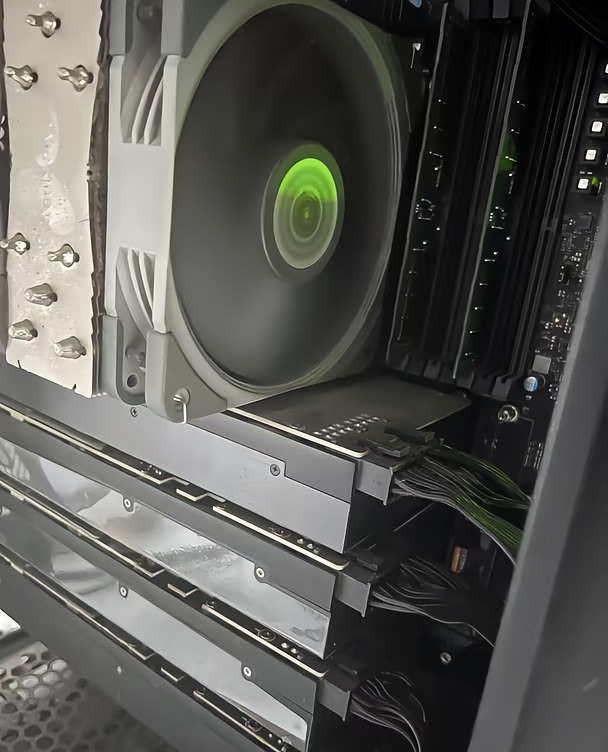
老显卡3090如何焕发青春?
本地模型如何加速推理?
1️⃣量化模型qwen3.8 27b w8a8 int8降显存
2️⃣利用3090的tensor core int8加速比bf16快2倍约
3️⃣tp4部署,最大限度发挥目前架构优势
4️⃣开启mtp投机速度又提升快2倍
5️⃣批处理和调度优化vllm加速
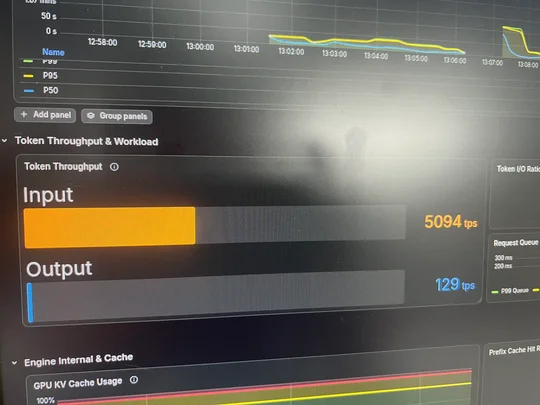
监控平台:
开源的prometheus+grafana直接docker部署就可以了
接入:pi agent. Codex可以无限跑代码,测试,本地业务的agent调用。#opc #codex #大模型 #大模型部署