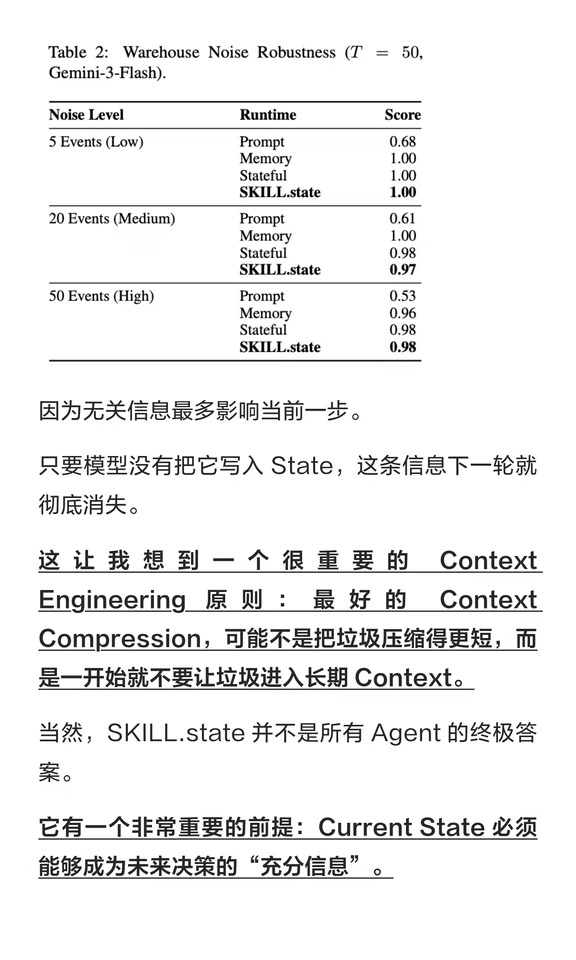
Google 最近一篇论文:《SKILL.state: Scalable Long-Horizon Agent Skills》。
它讨论的不是怎么让 Agent “记住更多”,而是一个更反直觉的问题:Agent 真的有必要记住自己之前做过的所有事情吗?
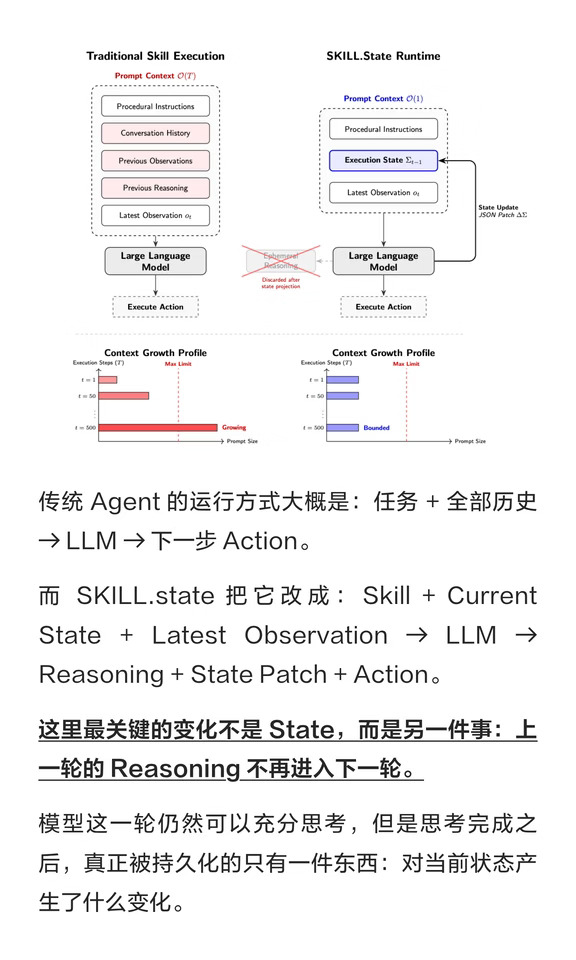
今天很多 Agent 的运行方式,本质上是在不断追加 History:任务 + 过去所有 reasoning + tool call + tool result → 下一步。
短任务没问题,但一旦跑到 100、200 个 Step,问题就来了。
Context 越来越长,Token 越来越贵,更麻烦的是,里面会同时存在旧事实、失败假设、过期结果和已经完成的计划。
Agent 每走一步,都得重新从历史里判断:“现在到底什么才是真的?”
SKILL.state 的做法很简单:只给模型三样东西,Skill + Current State + Latest Observation。
模型这一轮仍然可以充分 reasoning,但 reasoning 不再进入下一轮。
真正被保存的,只有对状态的修改:Reasoning 是临时的,State 才是持久的。
(怎么有点反其道而行之呢)
论文里有一个夸张的实验,是一个 200 Step 的长程任务。
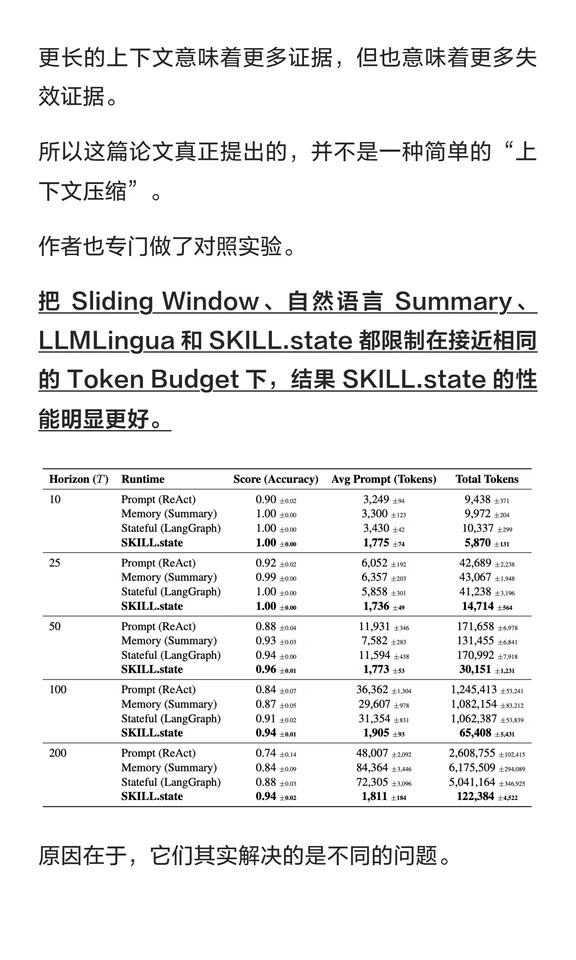
传统 ReAct 总 Token 消耗约 261 万,带 Memory 的方法超过 618 万。
SKILL.state 只有约 12.2 万。
更关键的是,准确率反而更高:ReAct 是 0.74,SKILL.state 达到 0.94。
所以这篇论文真正想说的其实是不要把 History 当成 Runtime。
Summary 是“把历史压短”,而State 是“把历史编译成现在”。
这篇论文表面上讲的是 Skill,实际上讲的是 Agent Harness:Skill 负责定义怎么做, State 负责描述现在做到哪, Tool 负责获取外部信息, LLM 负责当前一步的判断, Harness 负责状态更新、验证、持久化和下一轮 Context 的构造。
也许长程 Agent 的关键,从来都不是无限记忆,而是一个不会被过去拖累的现在。
#SkillState #AgentHarness #ContextEngineering #LLM #GoogleAI #大模型 #howto手搓skill