稍微记录&吐槽一下这几天给 H3 训练 LoRA 的体会。
MiniMax H3 真的挺惊人的,画质好、指令遵循可靠。可惜有些我想画的内容还是画得不太行,试了几个社区的 LoRA 也觉得还差不少,想了想觉得还是自己动手训练一个吧。
其实也不是我盲目膨胀,之前 SD 生图的时候就试做过一个 LoRA,流程有点不太人性化但反正能跑通;LLM 模型从零开始训练也小试了一把,还传了 HuggingFace;最重要的是,我已经搭好一台 AI 专用机了,96G 内存、单卡 64G 显存、三卡 100G,以个人爱好者来说已经轻奢了,训练个 LoRA 还是不难的吧,INT8 的未剪枝模型不也就 32G。
来,开始了解、规划、动手。
然后逐渐发觉自己挖了一个好深坑啊……
为了好的生成效果,要训练 LoRA;为了训练 LoRA,要整理出一些训练样本,还需要有对应的文本描述;为了让训练样本和文本描述都符合 H3 的需求&风格,开始研究怎么搭一个视频处理和文本描述生成的管线,还得试一试现成的开源视频描述模型好不好使,不好使的话不会还得先训练一个符合需求的视频描述模型吧……
到这里我已经开始觉得有点走歪了,我本来是要生成视频的啊,可我现在在干什么,仿佛ADHD上身……
本着“先能跑通再迭代”的精神,暂且搭了一套猴版的训练样本整理管线,大概准备了 200 条 3 到 10 秒的视频和对应的初版文本描述(然而对于一个 33B 的模型,200 条视频按理说也不够塞牙缝,先当作第一次小规模实验吧)。手工修正了一些描述里的大问题之后,终于能进入训练了。
训练过程则是另外一套折磨。ComfyUI 这种用来“消费”模型的工具,当然是比较易用的,教程也很多;用来生产模型的工具,则从安装开始就要复杂得多,埋了一堆暗坑。好在我也算见得多了,好歹装上了,添加了数据集、设好了训练参数,准备开始训练了。
训练流程里首先让人无语的是把所有训练样本(以及衍生的低分辨率和数据扩增变体)统一用 VAE 转成 latent,哇,就这么点视频,一共转了一天多(24小时以上),就这个转的过程里还爆内存了好几次(我这可是 96G 内存啊)。H3 的 VAE 比较大比较复杂我也大概能理解,但这种速度和这内存管理实在像是有大病。并且,跑跑 VAE 而已,来个多卡多线程加速完全可行,可就是欠奉,一卡有难两卡围观 ╮(╯_╰)╭
训练里的下一关是显存容量。训练当然只能在单卡上能跑,64G 怎么看都不小了,但就是动不动就不够,说好的 pytorch 显存管理灵活和 Ubuntu 下稳定效率高我是一点都没看出来。经过了二三十次 OOM 导致的报错乃至驱动崩溃之后,我终于差不多摸出来了,对于 64G 显存,不论怎么设置模型的按比例卸载乃至全部放在内存,7.3秒以上(175帧) x 768p 以上的训练样本都会导致爆显存。于是我专门混合了多种时长和分辨率的训练数据们还得再重新分组,按照显存能够承受的规模来。
莫名其妙的细节问题也有一些,按理说 torch.compile() 能加速且省资源,但开了以后 loss 总是 NaN、基础的生成都不正常;在训练过程完全稳定之前,没在家的时候也需要通过远程控制动一动,但非常神奇,一部分窗口能正常操控,一部分就不行,甚至同一个浏览器窗口里同一个页面上的元素,有的就能正常点、有的就点不了。我大开眼界。
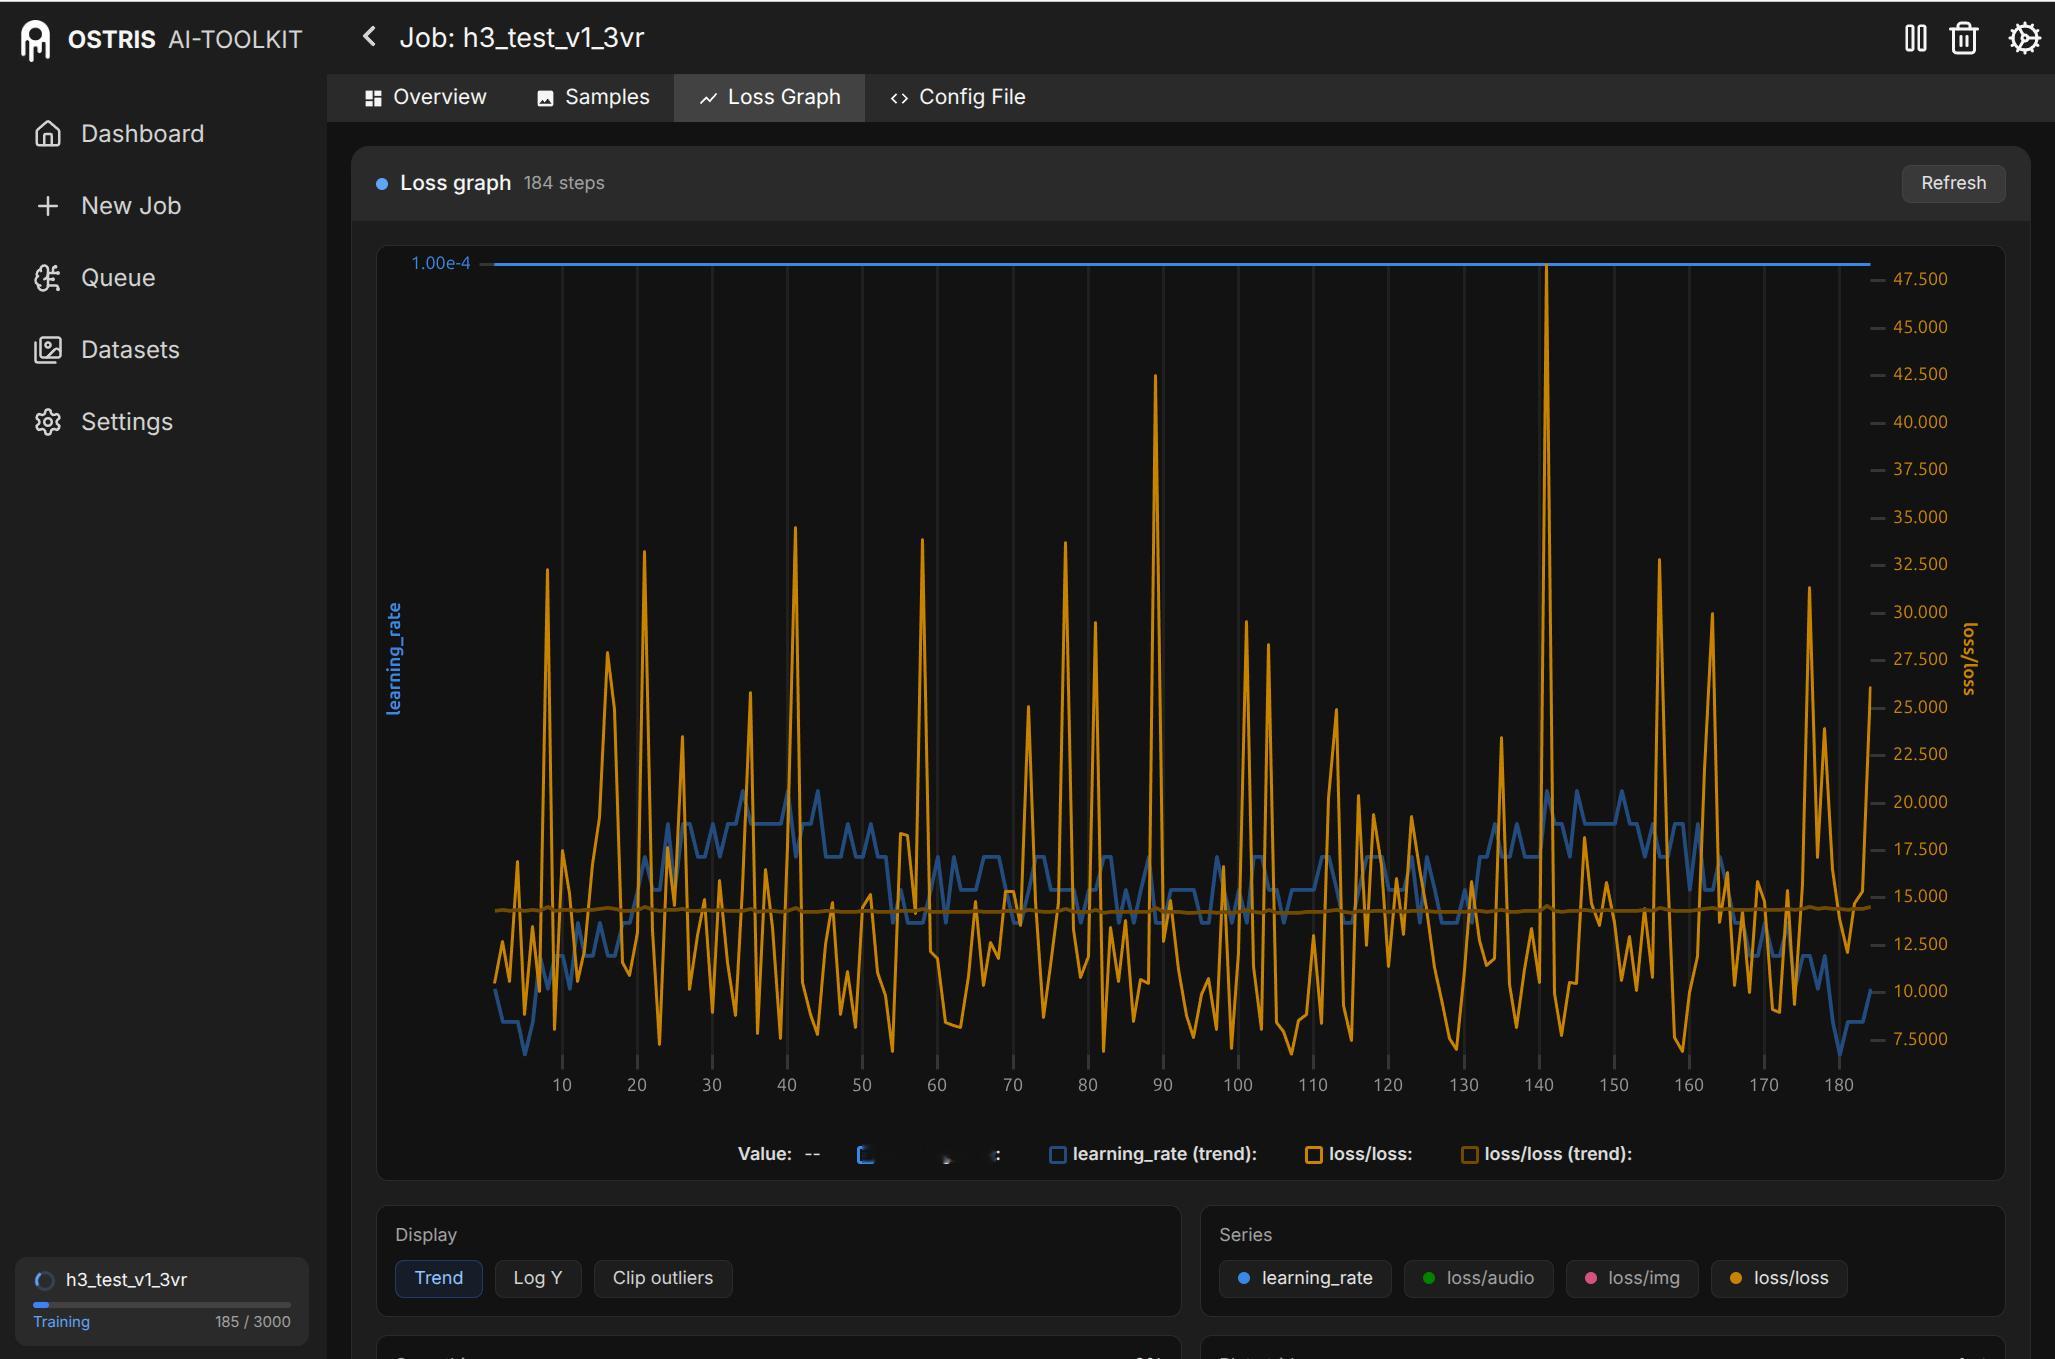
总之,一关一关过到现在,训练好歹是先跑起来了,显存占用仍然时不时蹭到95%的危险线。现在看着这上蹿下跳的 loss 曲线我还是有点心里发毛,不知道是不是还隐藏着下一个大问题等待我解决。