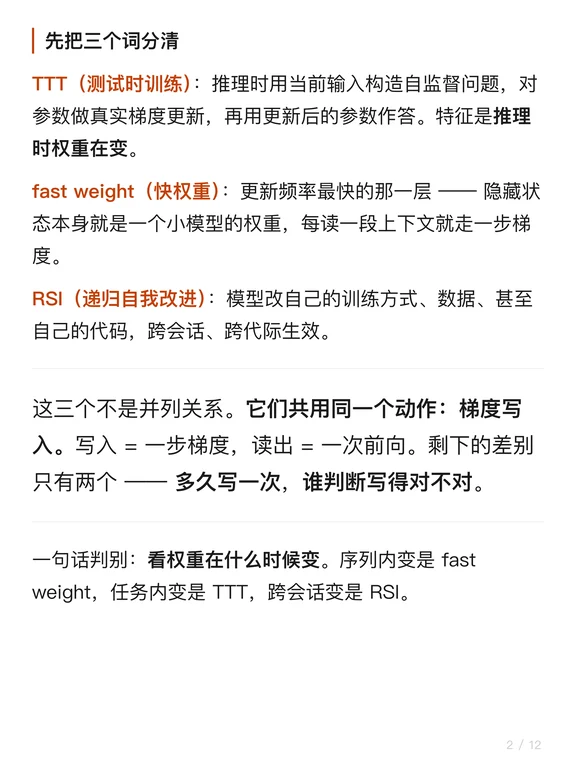
TTT、fast weight、RSI 到底什么关系,这半年我被问过太多次。上周把这条线的论文集中读完,结论很干脆:同一件事在三个更新频率上的分身。
共用的动作是梯度写入。写入 = 一步梯度,读出 =一次前向。差别只有两个:多久写一次,谁判断写得对不对。
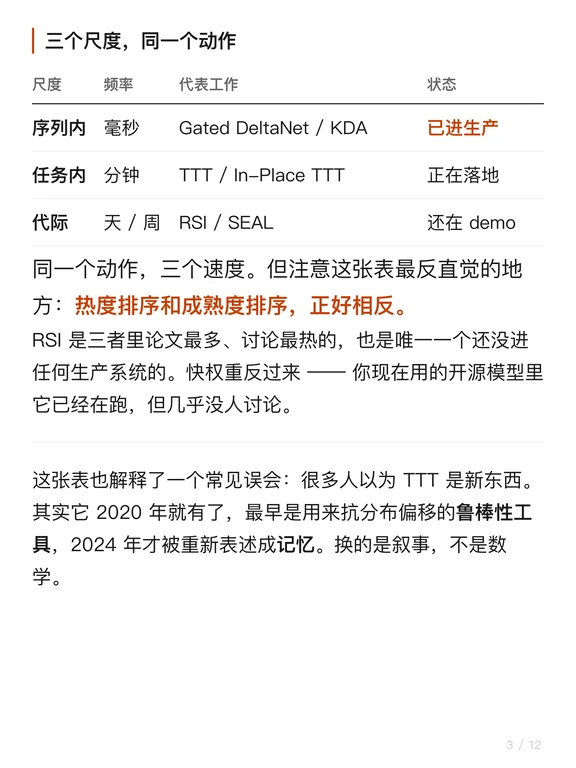
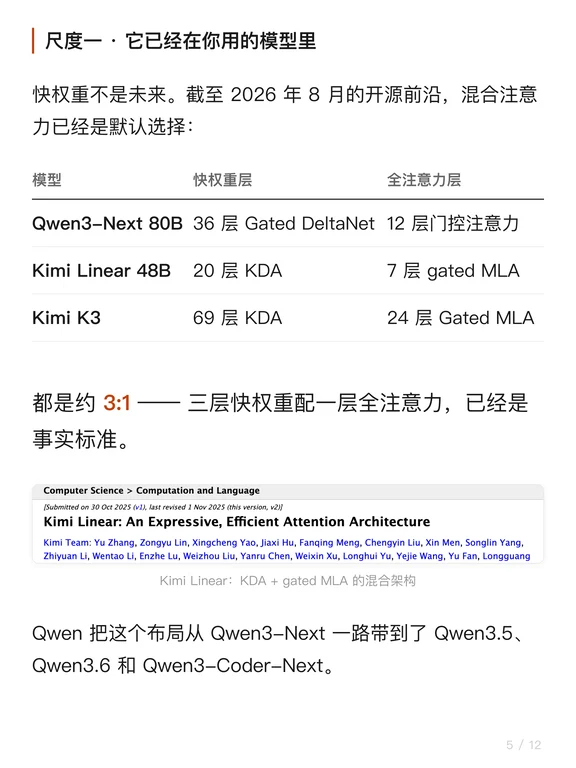
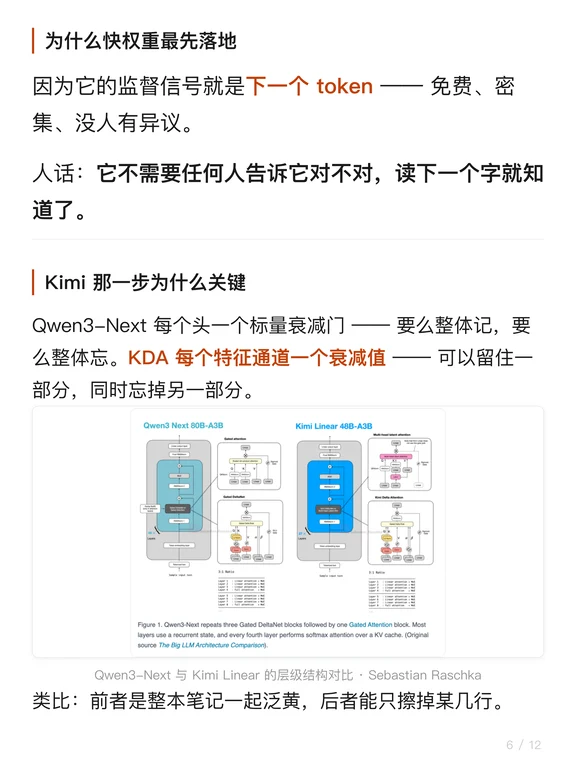
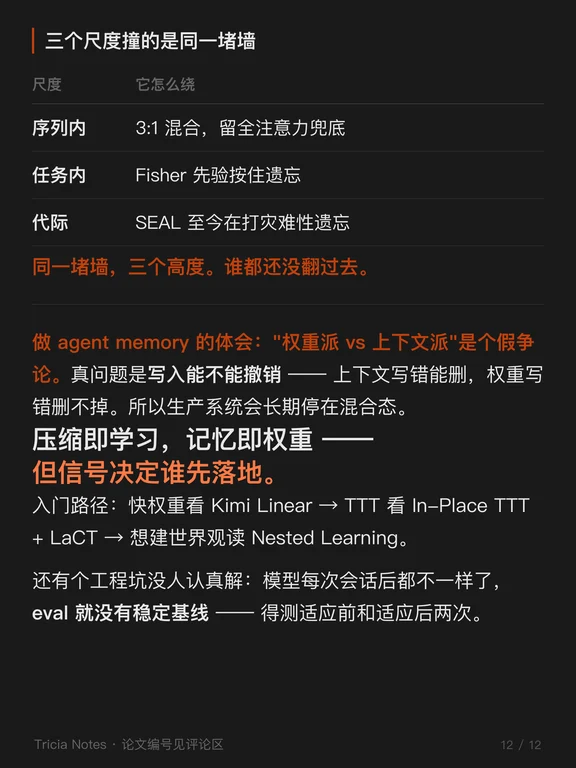
序列内(毫秒级)是快权重。Qwen3-Next 是 36 层 Gated DeltaNet + 12 层注意力,Kimi Linear 是 20 层 KDA + 7 层 gated MLA,都是 3:1。你现在用的开源模型里它已经在跑。
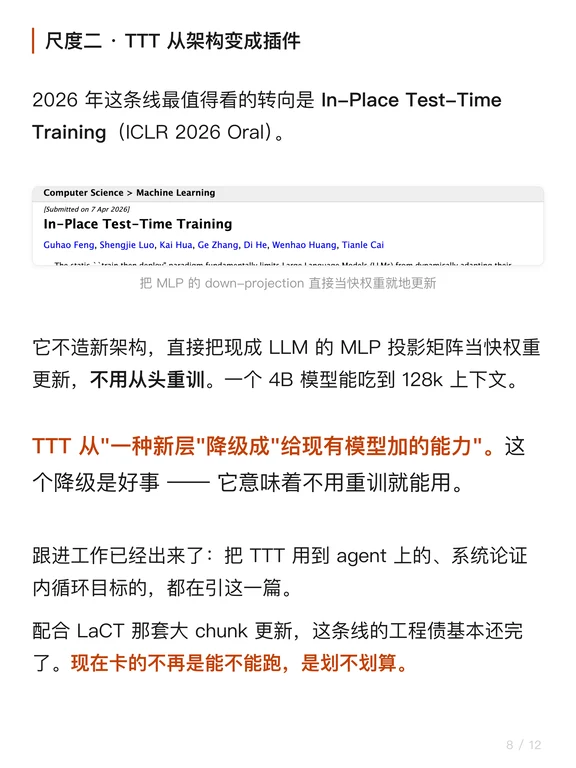
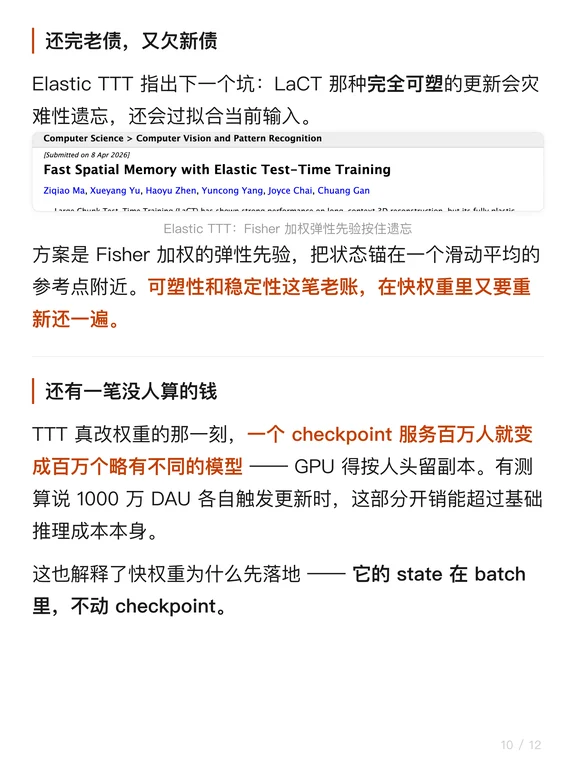
任务内(分钟级)是 TTT。In-Place TTT 直接把现成 LLM 的 MLP投影当快权重更新,不用重训 —— TTT 从"新架构"降级成"给现有模型加的能力"。
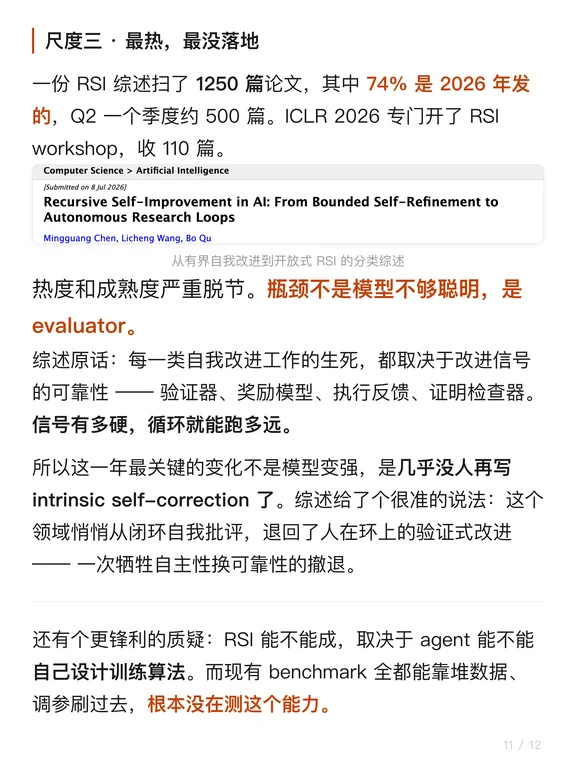
代际(天/周)是 RSI。论文最多,落地最差。
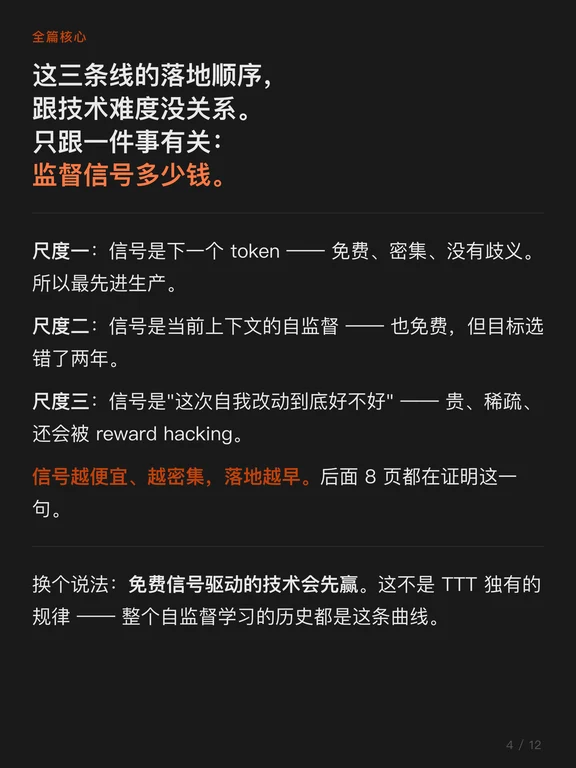
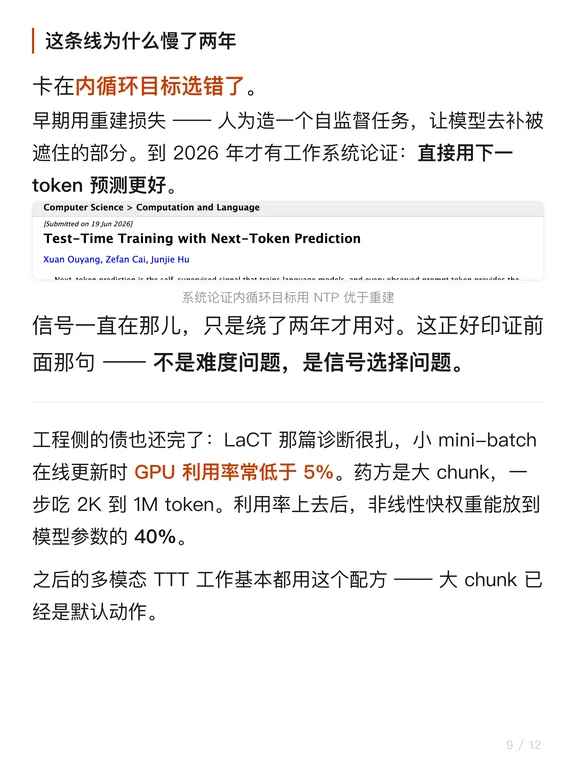
为什么是这个顺序?跟技术难度没关系,跟监督信号多少钱有关系。尺度一的信号是下一个token,免费又密集;尺度三是"这次改动到底好不好",贵、稀疏、还会被 reward hacking。
三条线撞的是同一堵墙:精确召回 vs 有损压缩。
我的判断:权重派 vs 上下文派是个假争论。真问题是写入能不能撤销 ——上下文写错能删,权重写错删不掉。
#TTT #测试时训练 #fastweight #RSI #大模型 #AI架构 #持续学习 #agent记忆 #howto用好AI