Terminal‑Bench‑Science:面向多科学领域研究工作流的AI智能体评测基准
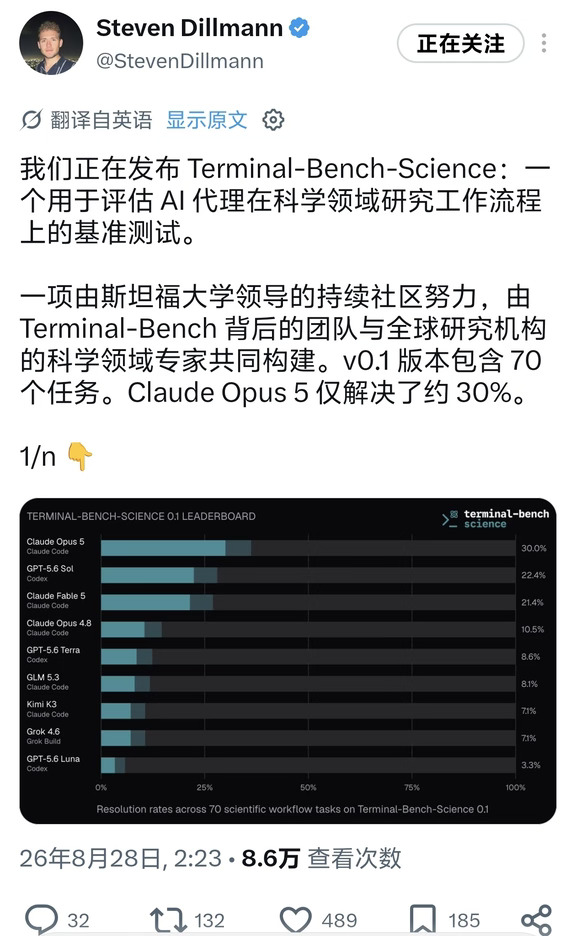
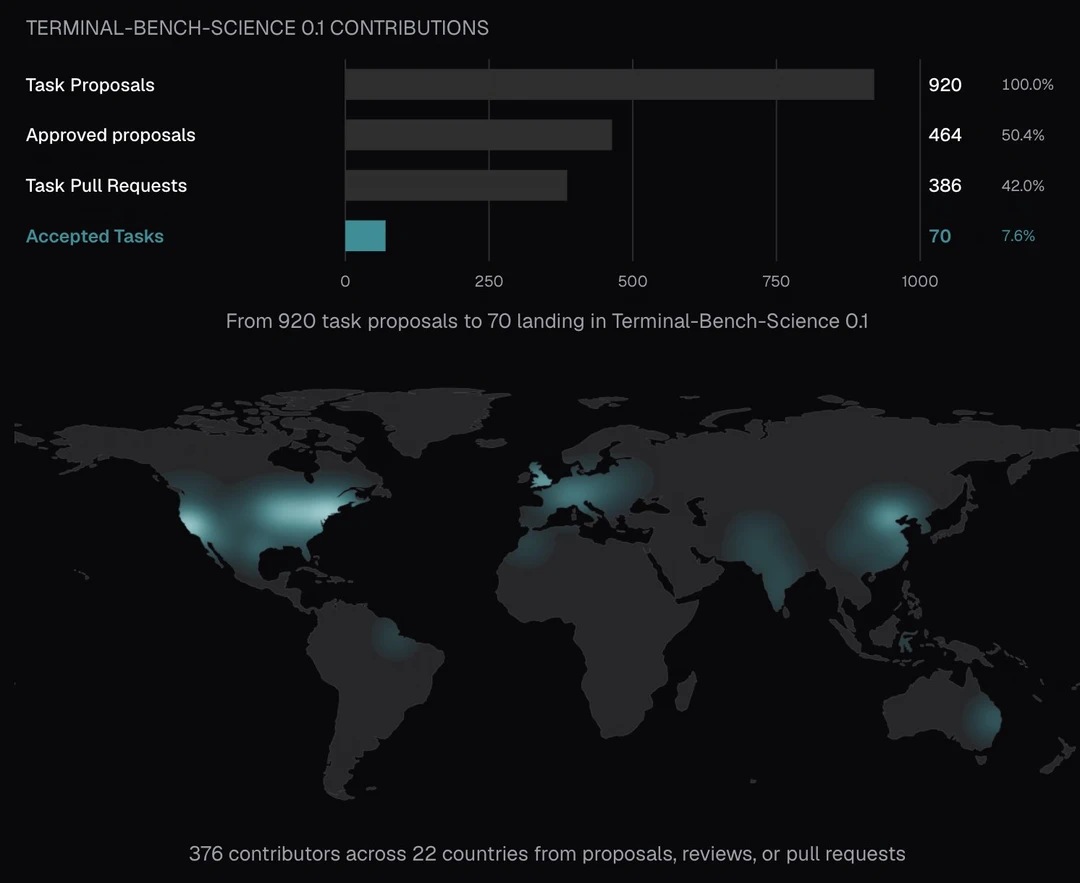
这是由斯坦福牵头、持续迭代的社区项目,由 Terminal‑Bench 原团队联合全球多家科研机构的各领域科学专家共同搭建。v0.1 版本共包含70项任务,Claude Opus 5 的任务完成率仅约30%。
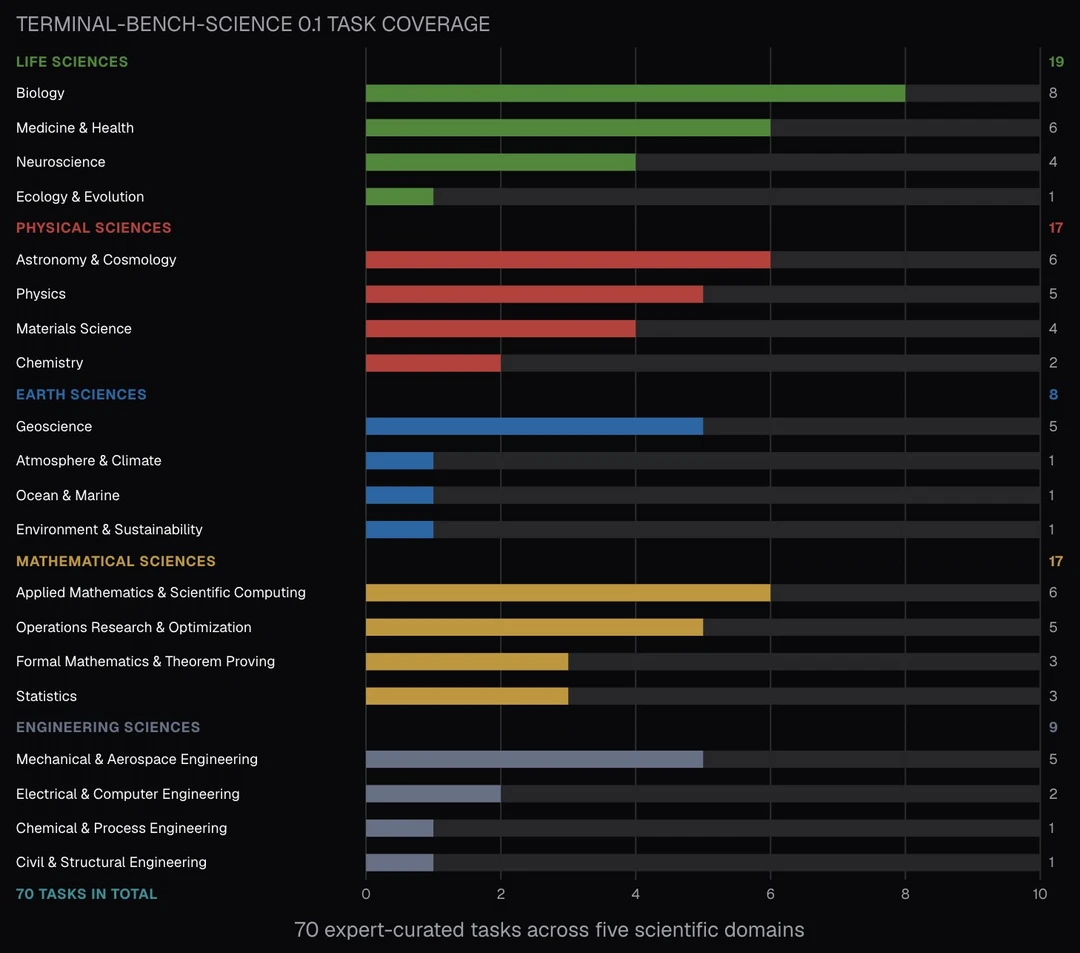
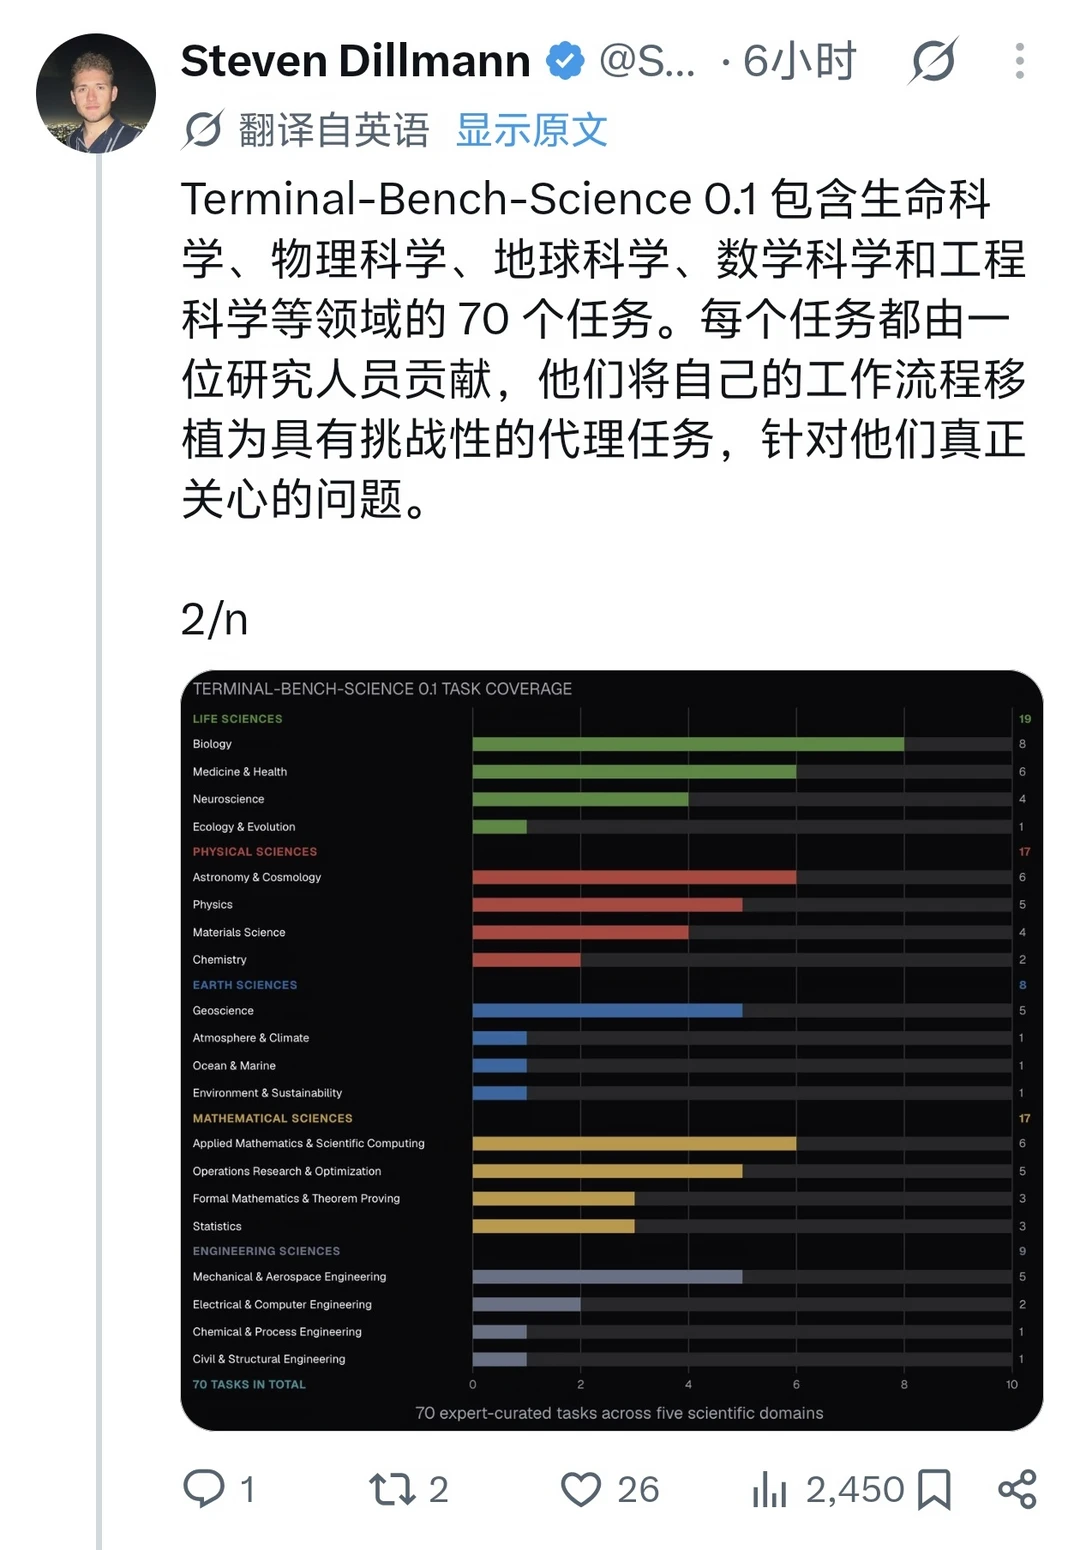
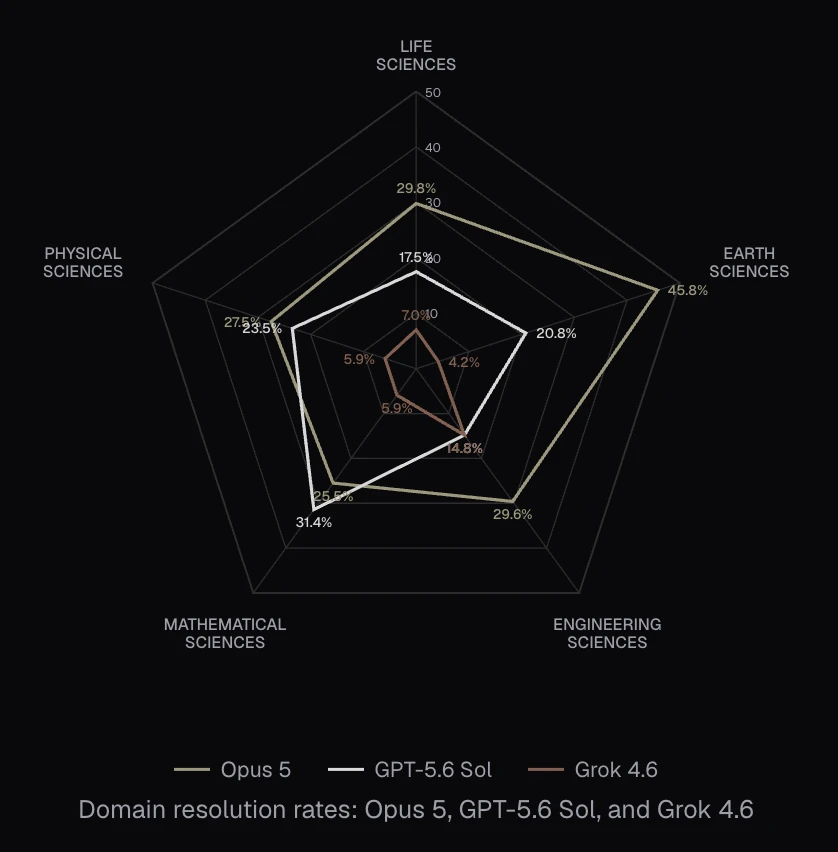
Terminal-Bench-Science 0.1 包含生命科学、物理科学、地球科学、数学科学和工程科学等领域的 70 个任务。每个任务都由一位研究人员贡献,他们将自己的工作流程移植为具有挑战性的代理任务,针对他们真正关心的问题
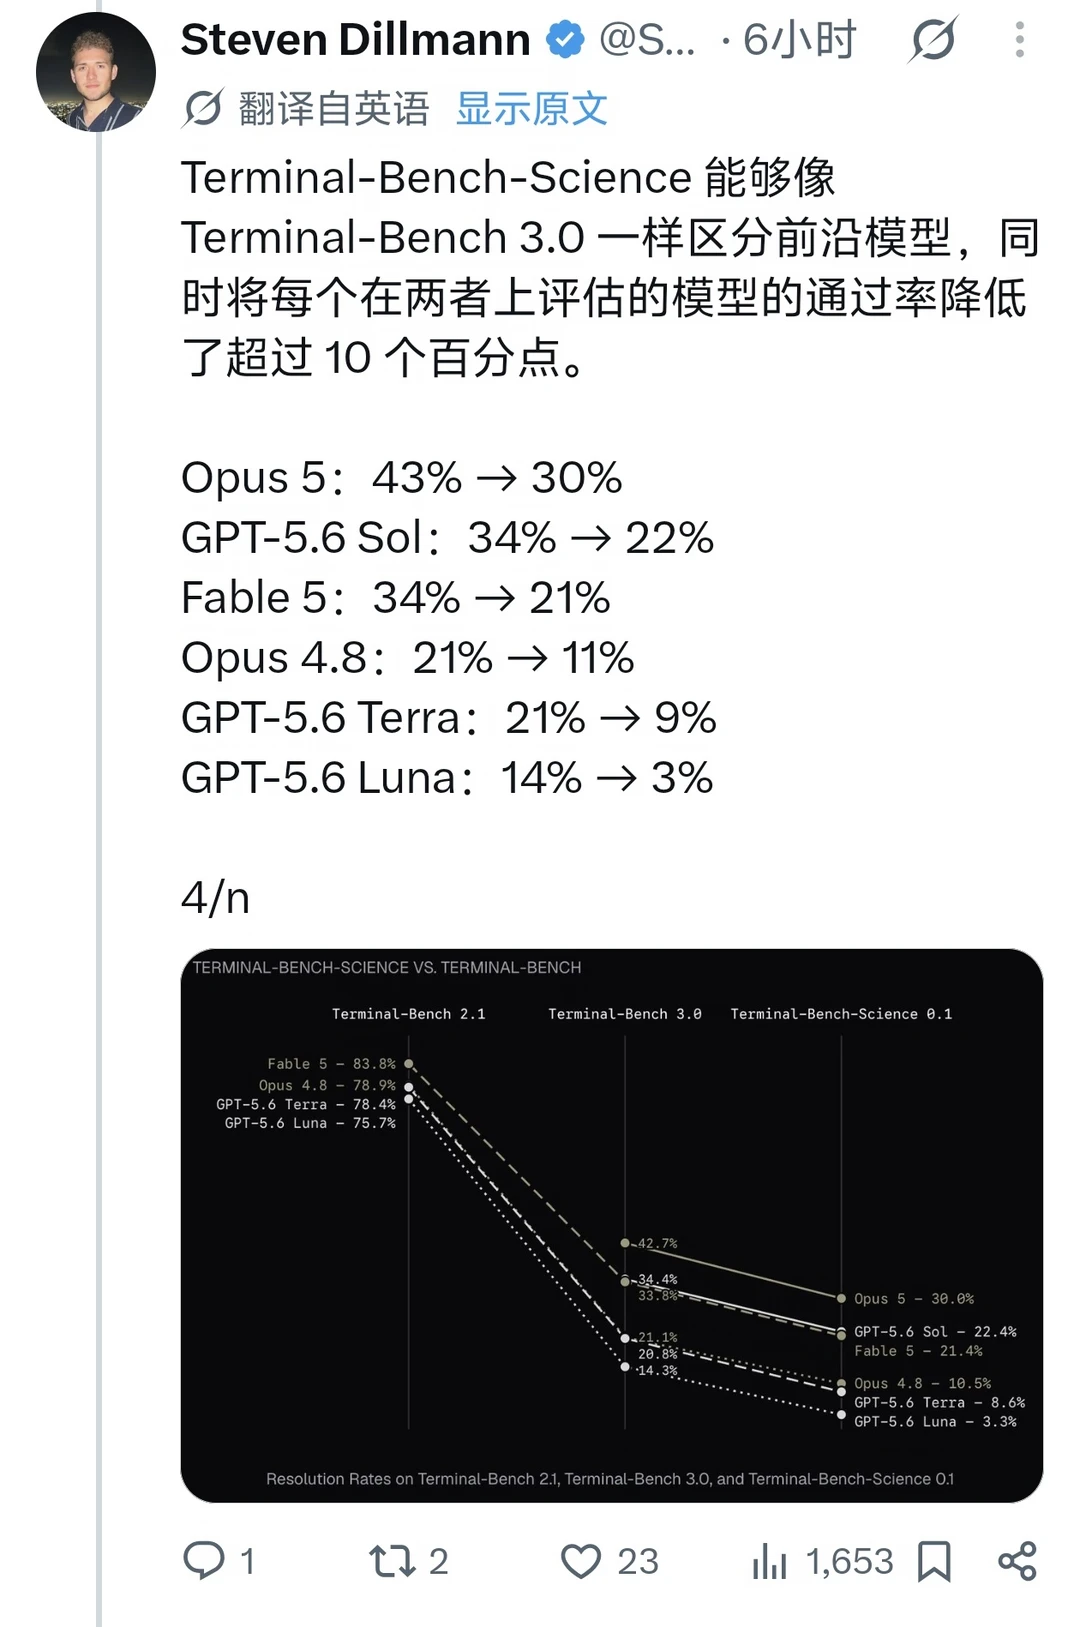
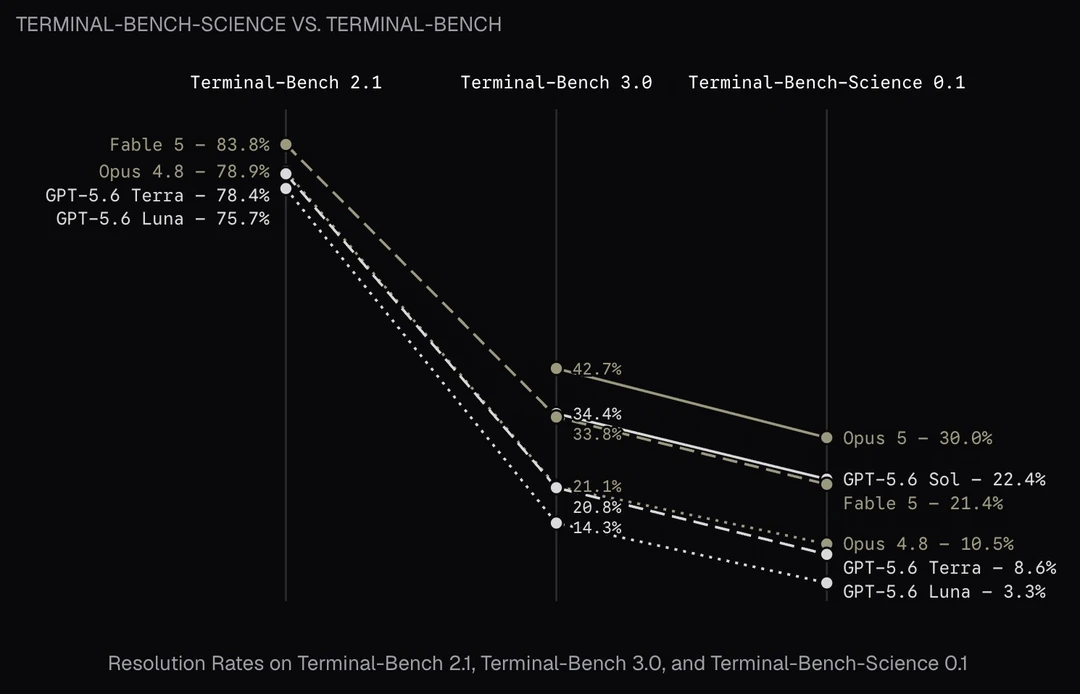
Terminal-Bench-Science 能够像 Terminal-Bench 3.0 一样区分前沿模型,同时将每个在两者上评估的模型的通过率降低了超过 10 个百分点
Opus 5:43% → 30%
GPT-5.6 Sol:34% → 22%
Fable 5:34% → 21%
Opus 4.8:21% → 11%
GPT-5.6 Terra:21% → 9%
GPT-5.6 Luna:14% → 3%
#人工智能 #大模型评测