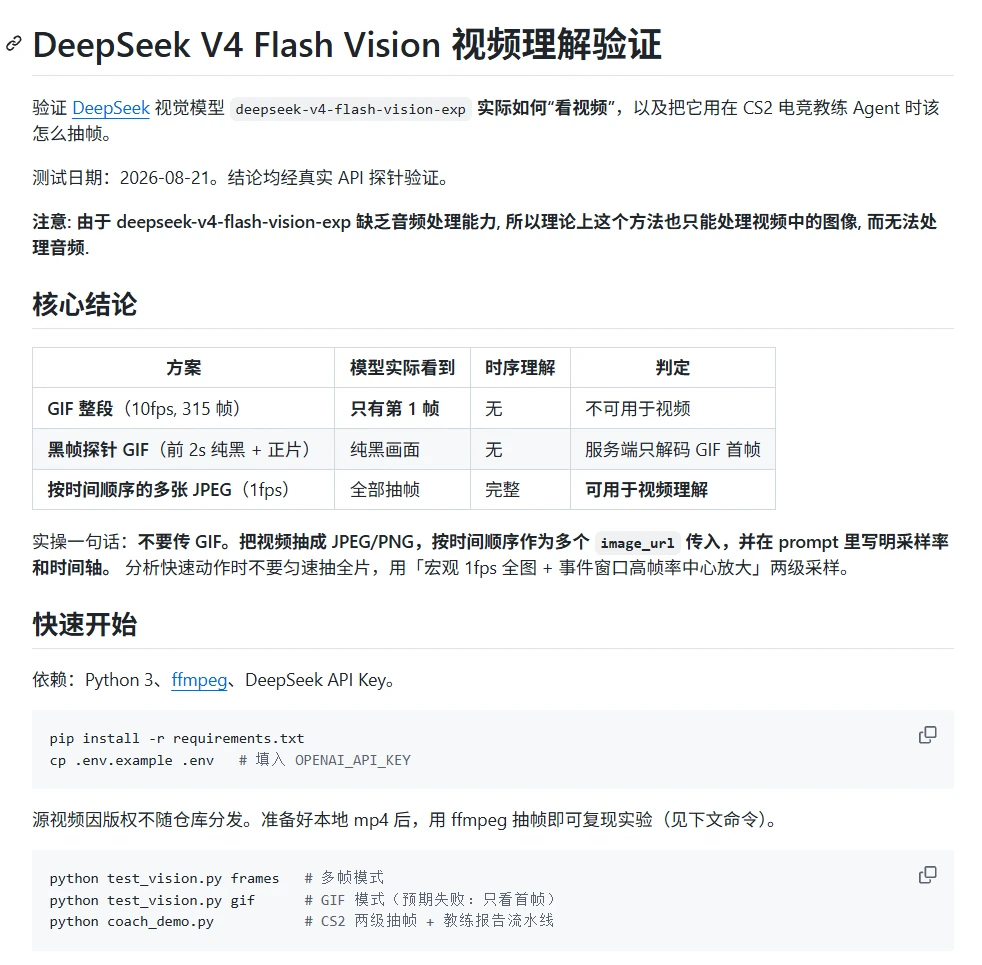
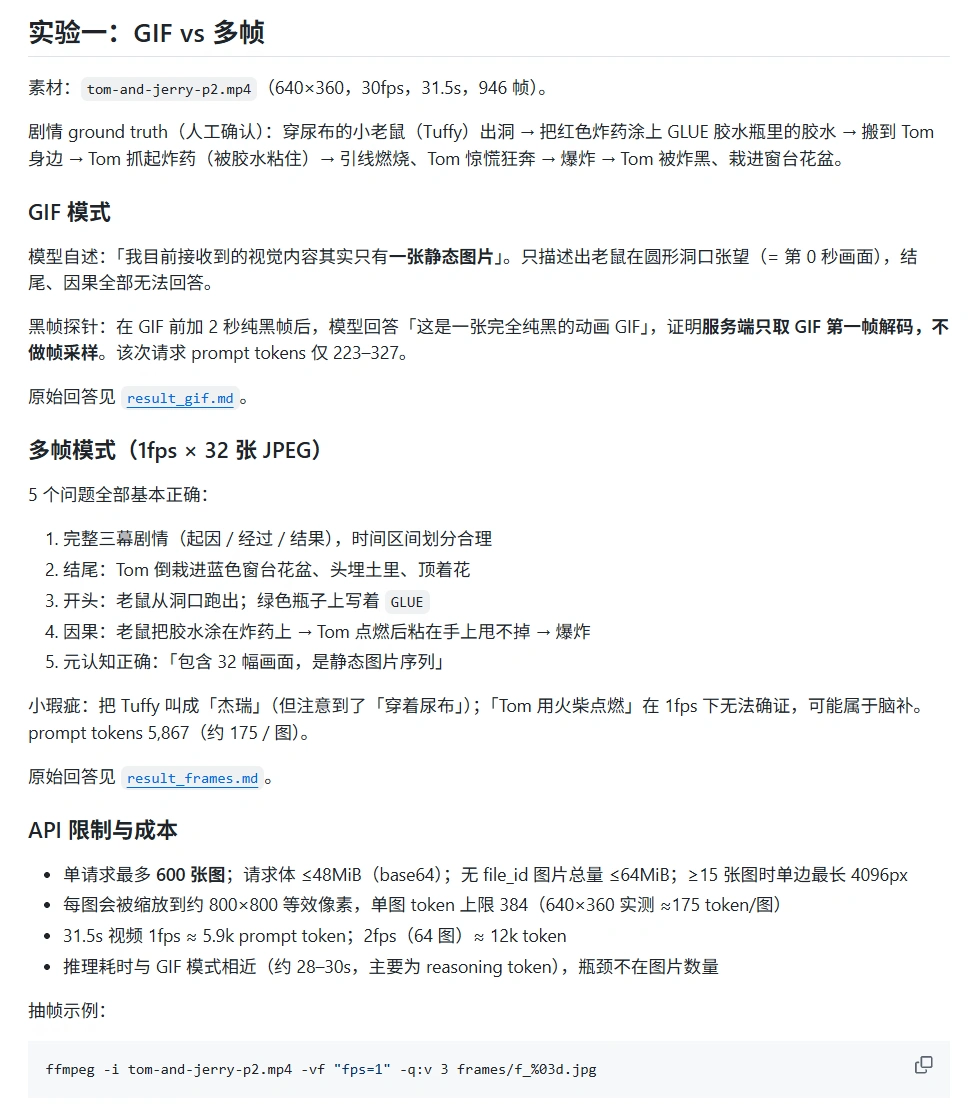
简单来讲, 方法就是直接把视频抽帧. 而且需要注意, 虽然模型支持gif输入, 但是它只识别 gif 的第一帧(我写代码验证了). 所以把视频转换为gif是行不通的.
抽帧的最佳实践也给大家: 把视频抽成 JPEG/PNG, 按时间顺序作为多个 `image_url` 传入, 并在 prompt 里写明采样率和时间轴. 这样分析会更准确. 我使用了一个猫和老鼠的片段进行分析, 这样做模型识别很准确.
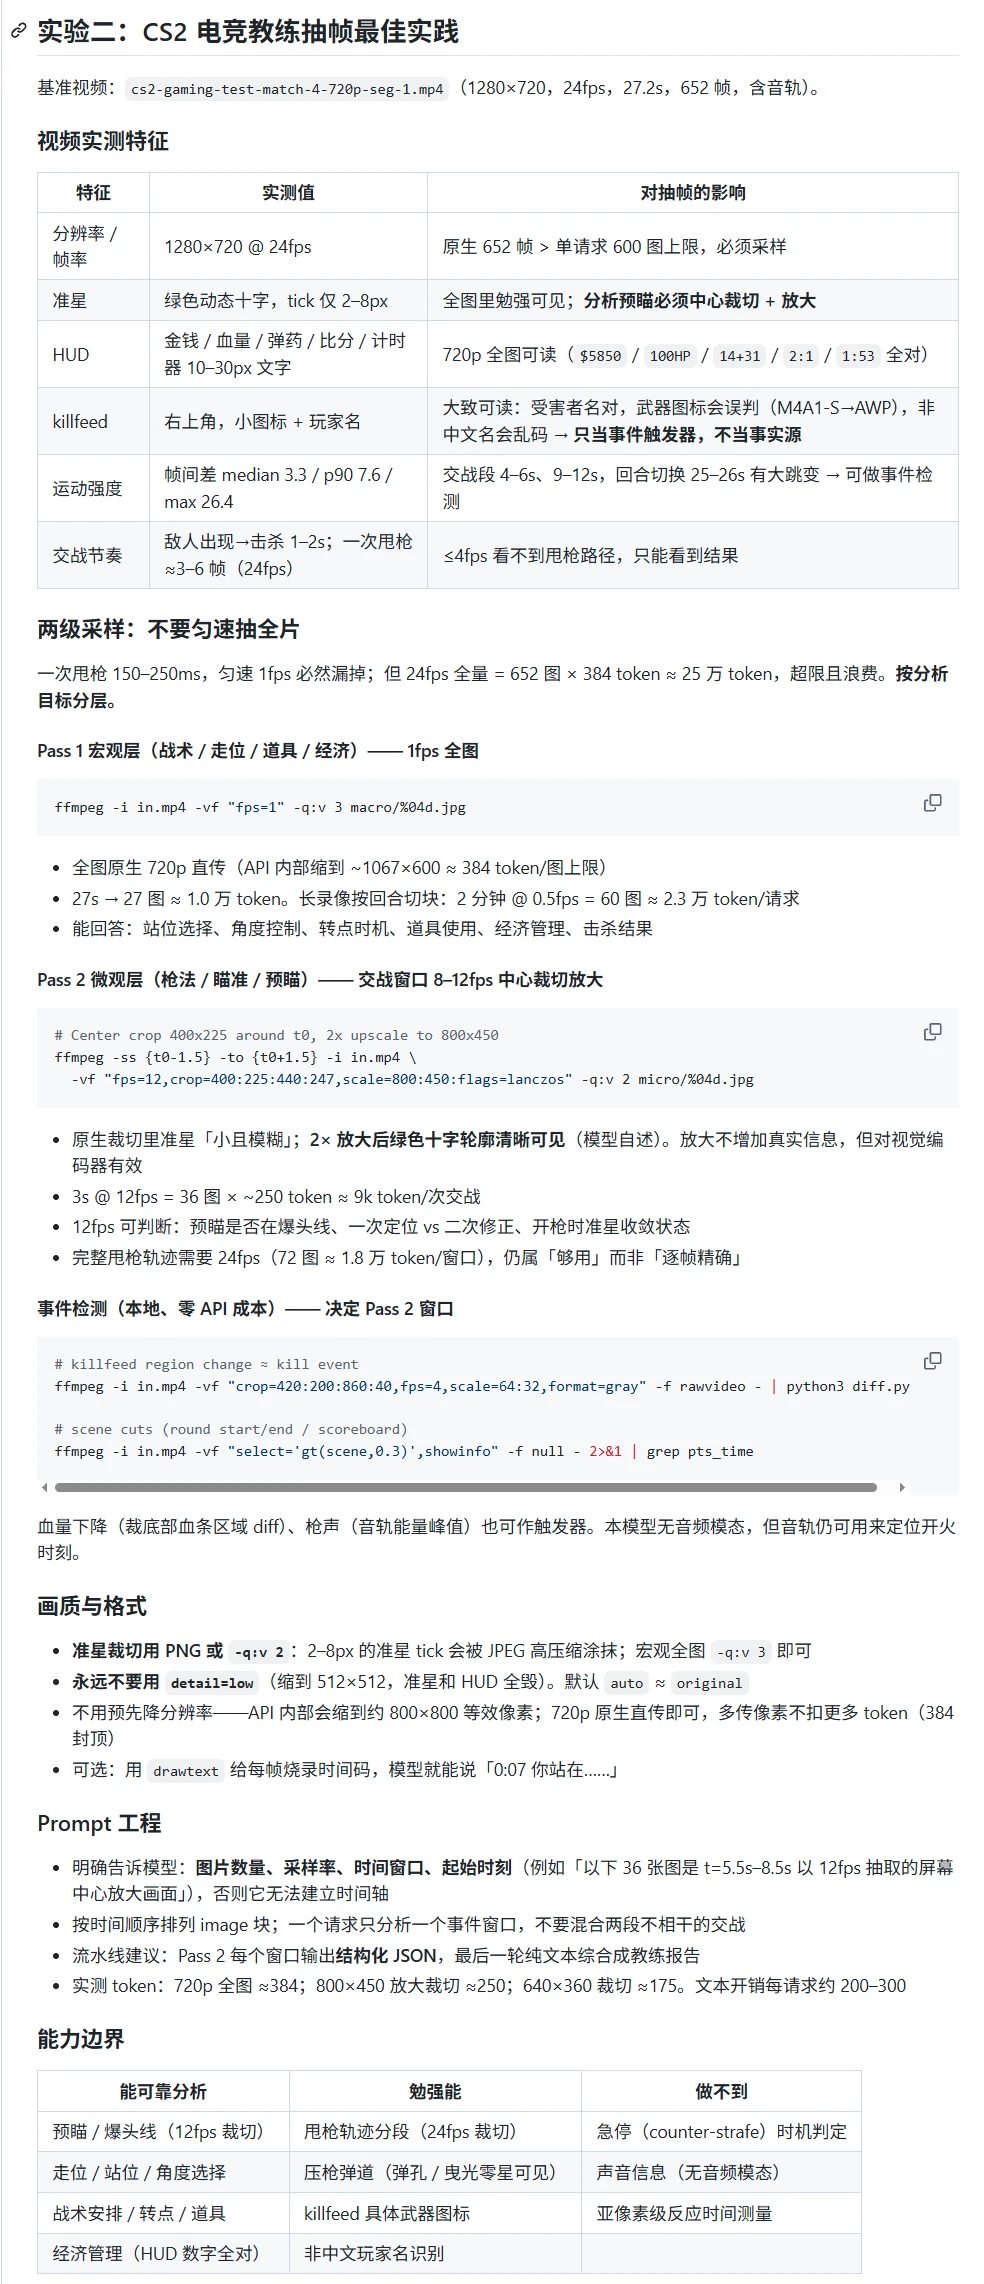
另外, 我还用了一段 CS2 录像来验证分析快速动作时的最佳方案, 结论是不要匀速抽全片, 用「宏观 1fps 全图 + 事件窗口高帧率中心放大」两级采样。效果会更好.