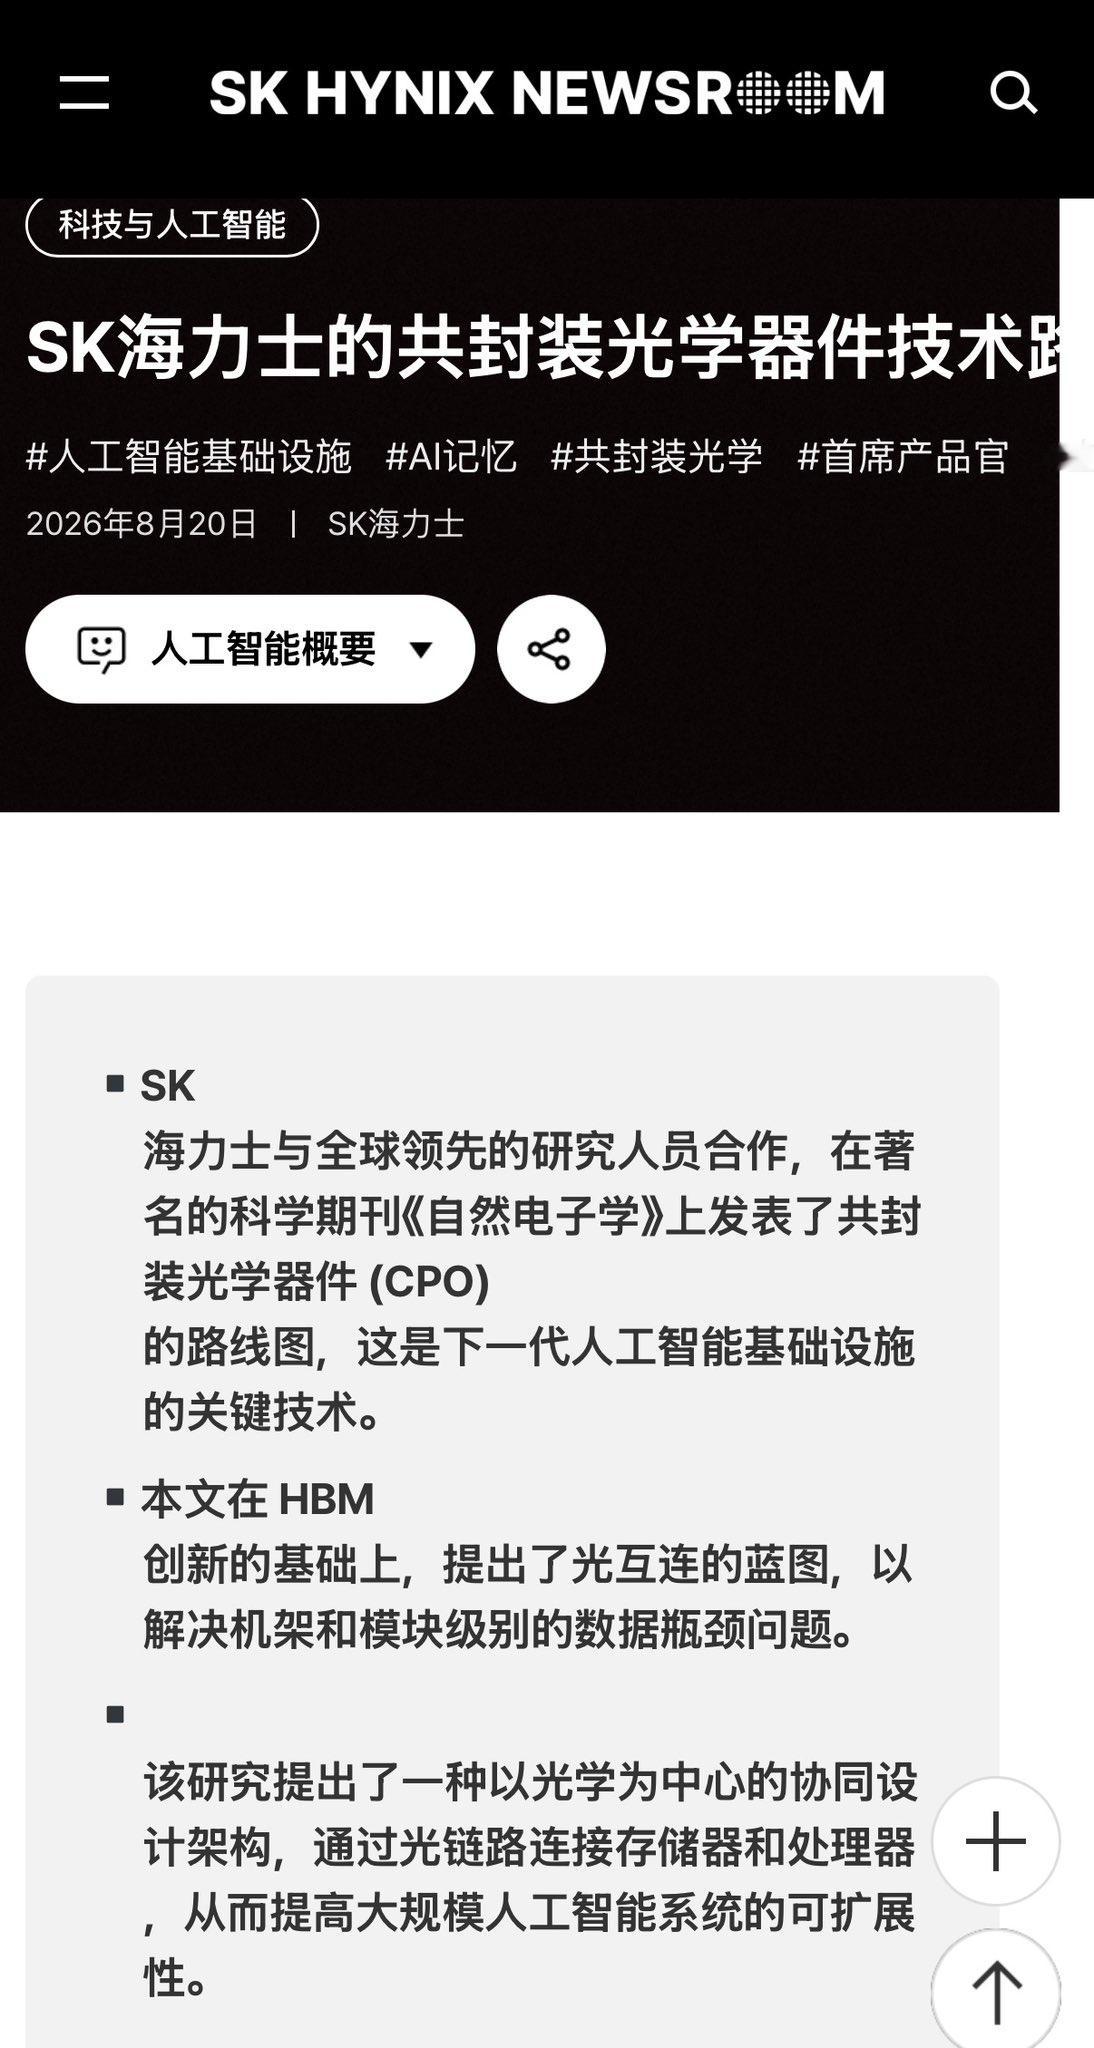
SK海力士在《Nature Electronics》发表的关于共封装光学(CPO)论文:Co-packaged optics for high-performance computing and artificial intelligence(用于高性能计算和人工智能的共封装光学器件)。
• 发表时间:2026年8月。
• 核心团队:由SK海力士AI基础设施团队负责人Seunghoon Hong(洪承勋)与弗吉尼亚大学教授Kyu-sang Lee(李圭相)担任共同通讯作者,联合MIT、南洋理工大学等全球顶尖科研机构共同撰写。
🎯 核心背景:AI系统的“带宽墙”
随着大模型参数量的爆炸式增长,AI加速器(XPU)的算力需求激增。数据显示,计算吞吐量大约每两年增长3倍,而传统的铜缆互联带宽同期仅提升约1.4倍。这种极不对等的增长导致了严重的“带宽墙”危机,使得海量算力因等待数据传输而空转,限制了系统整体性能的发挥。
💡 核心解决方案:系统级CPO技术路线图
该研究不仅回顾了CPO技术,更提出了一份面向下一代AI基础设施的系统级技术蓝图:1. CPO破局短距传输:传统的可插拔光模块电信号传输路径长、损耗大。CPO的核心在于将光引擎(Optical Engine)与处理器共封装,极大缩短电信号的传输距离,转而利用光纤进行长距离传输,从而在提升带宽的同时大幅降低功耗与延迟。2. 迈向“以光为中心”的架构:论文提出了极具前瞻性的长期愿景——将光互联进一步延伸至内存接口。通过引入光子中介层(Photonic Interposer),构建“以光为中心(Optics-centric)”的架构,直接连接分散的XPU计算资源池与内存资源池。3. 打破物理限制:这一架构将颠覆传统的“一颗GPU绑定固定几颗HBM”的物理封装限制,允许多个AI加速器共享大容量的内存池,从而实现计算与存储资源的灵活配比和独立扩容。
📈 下一代AI基础设施性能指标
研究团队为未来的AI系统设定了严苛且明确的技术目标,以验证该路线的可行性:• 单节点带宽:> 100 Tb/s
• 数据传输能耗:< 1 pJ/bit
• 芯片间传输延迟:< 10 ns
🛠️ 技术演进路径与挑战
论文系统性地梳理了光互连技术从2D封装、2.5D中介层配置,逐步向3D异构集成演进的完整路线图。同时,研究也客观指出了商业化落地前必须攻克的现实难题,包括高密度光电混合封装的良率控制、极低热膨胀系数的热管理、以及Micro-LED阵列等新型光源的制造工艺与长期可靠性挑战。
————————海力士也开始扩展其他领域的业务,向内存系统提供商进军,如果成功,护城河会明显提高