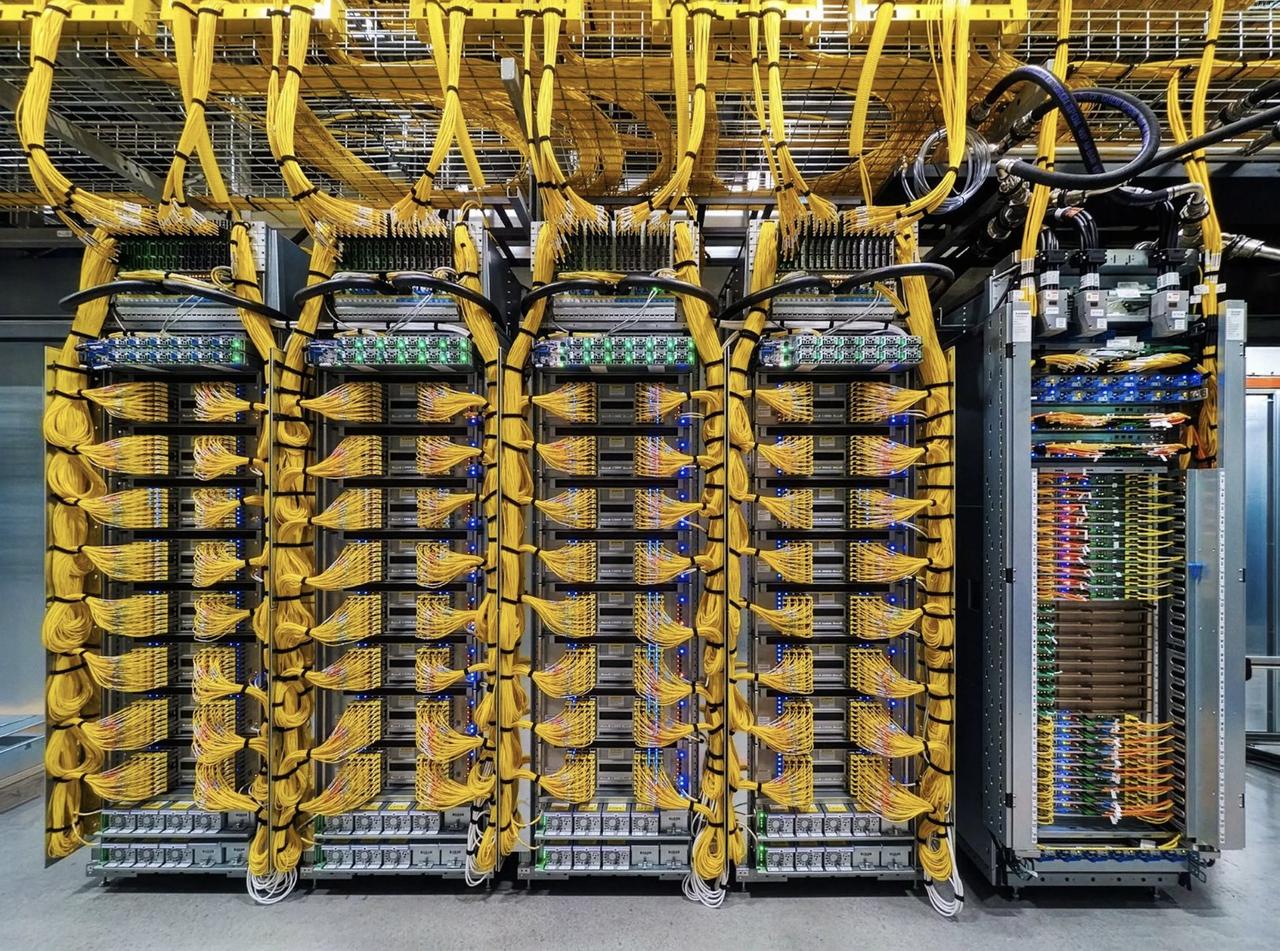
第一批 Vera Rubin 集群到货了!
AI硬件再加速!首台Vera Rubin NVL72集群已交付昨天,
@IneffableLabs
从Google Cloud正式接收NVIDIA Vera Rubin NVL72超级集群!72颗Rubin GPU+36颗Vera CPU,性能与效率大幅跃升,AI前沿又往前猛冲一大步。硬件加速永不止步,下一个超级智能时代,正在快速到来!
Vera Rubin架构详解
Vera Rubin是NVIDIA在Blackwell之后的下一代AI平台架构(2026年量产部署),专为代理AI(Agentic AI)、大规模训练与高效推理设计。核心是Vera Rubin NVL72机架级超级计算机系统。
1. 核心硬件配置(单机架NVL72)
GPU:72个NVIDIA Rubin GPU
CPU:36个NVIDIA Vera CPU(与GPU组成Superchip)
内存:
GPU总HBM4:约20.7 TB(单GPU最高288 GB)
CPU内存:54 TB LPDDR5X
互联:NVLink 6,机架内规模化带宽达260 TB/s
其他:ConnectX-9 SuperNIC、BlueField-4 DPU,支持InfiniBand与Spectrum-X Ethernet扩展
2. 关键性能指标(NVFP4精度)
推理:约3600 PFLOPS
训练:约2520 PFLOPS
与Blackwell相比:
训练相同模型可减少约75% GPU数量
推理:每瓦特tokens吞吐量提升约10倍,每百万tokens成本降至1/10
3. 架构亮点
HBM4高带宽内存:单GPU带宽达22 TB/s,大幅提升长上下文与MoE模型效率。
NVLink 6全互联:72个GPU形成单一高带宽域,降低通信开销,适合超大规模模型并行。
液冷+MGX模块化设计:继承第三代MGX架构,便于从Blackwell平滑升级。
Vera CPU强化:Arm兼容自定义核心,擅长强化学习、代理环境模拟与后训练任务。
全栈优化:结合软件(NVIDIA AI Enterprise、Mission Control),针对“预训练+后训练+测试时缩放”全流程。
4. 应用场景
前沿实验室:如IneffableLabs用于“超级学习者”(通过经验自主学习而非仅依赖数据集)。
云服务:Google Cloud、CoreWeave、Lambda等已部署或计划部署。
科学计算:高FP64性能,支持物理模拟、能源、气候等科学工作负载。
Vera Rubin代表NVIDIA从“规模扩张”向“效率跃迁”的转变,让更大模型、更智能代理在可控能耗下成为现实,是2026-2027年AI基础设施的核心驱动力。
数据来源于NVIDIA官方规格(2026年发布)。实际部署性能会受软件优化与具体 workload影响。