原生多模态:大模型的下一个赛点,百度文心已抢占技术制高点
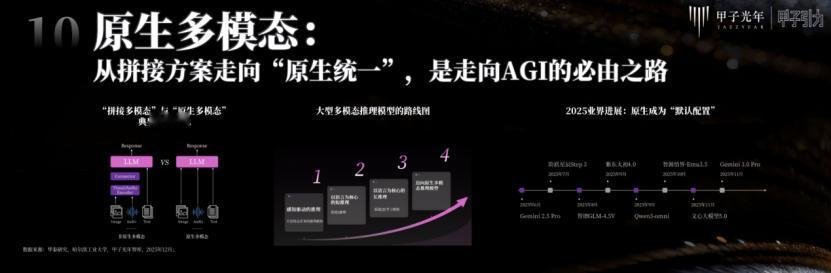
当我们习惯于让AI看图说话、听音转文时,一个更深层的技术变革正在发生:大模型正在从“拼接多模态”走向“原生多模态”。这不仅是架构的升级,更是AI理解世界方式的一次根本性跨越。行业分析机构甲子光年明确指出,从拼接方案走向“原生统一”,是走向通用人工智能(AGI)的必由之路。而在这一全球性技术拐点上,百度文心大模型已展现出显著的领跑姿态。
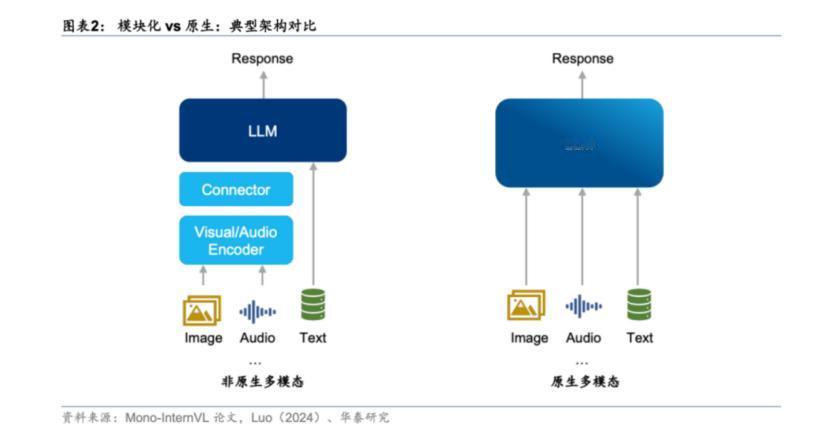
那么,什么是原生多模态?我们可以用一个比喻来理解。传统的“拼接式”多模态模型,就像一个翻译团队:视觉模型负责“看图说话”,语音模型负责“听写转文字”,最后由语言模型进行整合。任何环节的“误译”都会导致最终理解的偏差。而“原生多模态”大模型,则像一位天生的“通才”,它在训练之初就让文本、图像、音频、视频等信息在同一个语义空间里共同学习、相互滋养,直接实现跨模态的深度理解与统一生成。这种架构带来了效率的飞跃,更重要的是,它实现了前所未有的跨模态一致性。
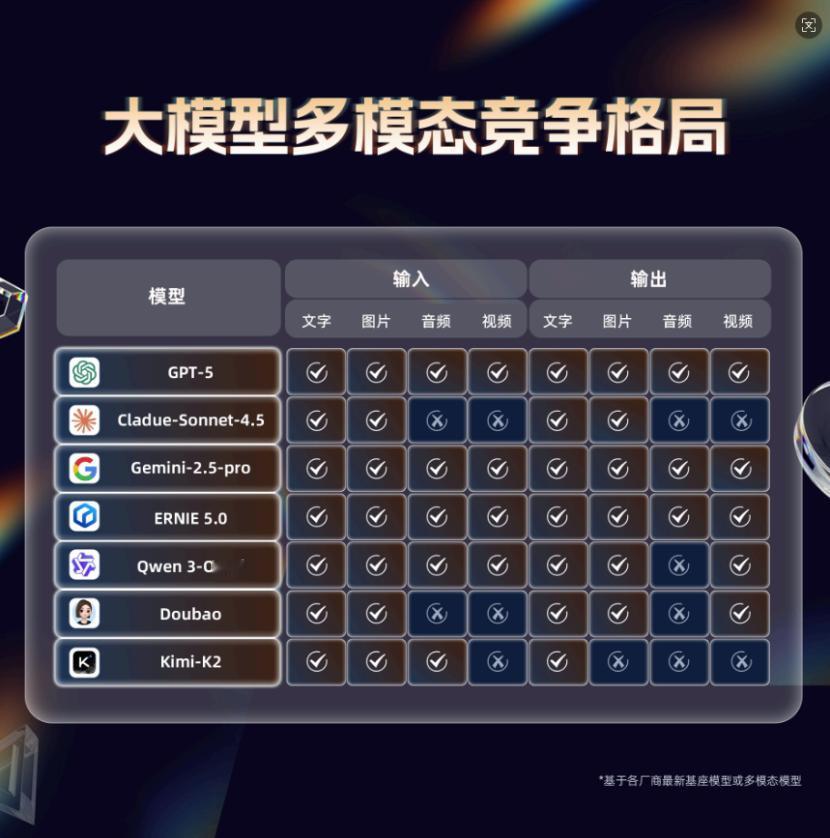
2025年,原生多模态已成为全球顶级模型的“默认配置”。谷歌Gemini 3的发布,进一步将行业焦点拉回这一核心赛道。而在国内,百度于2025年底发布的文心大模型5.0,以2.4万亿参数的庞大规模,实现了纯粹的原生全模态统一建模,成为国内走在这条技术最前沿的典范。华泰证券在报告中警示,若国内厂商未能在2025-2026年突破原生架构,可能在未来竞争中沦为功能跟随者。这凸显了百度文心5.0技术路线的战略价值。
文心5.0的领先性并非空谈。在权威基准评测中,其综合能力已与Gemini 2.5 Pro、GPT-5 High等国际顶尖模型持平。在更具象的榜单上,文心5.0预览版相继登上全球知名的LMarena竞技场文本榜第二、视觉理解榜前列,直观证明了其原生全模态架构的实力。这背后是百度全栈AI自研体系的支撑:从昆仑芯、飞桨深度学习框架,到大规模训练集群和庞大的生态数据,构成了攻克这一技术堡垒的完整基石。
原生多模态为何如此关键?因为真实世界本就是多模态信号的融合流。要让AI真正理解并融入人类世界,它必须能像人一样,自然地关联所见、所闻、所读。原生架构正是实现这一目标的最优路径。它让大模型在工业质检中能同时分析图像异常和维修日志文本,在医疗诊断中能交叉参考医学影像与患者自述,在自动驾驶中能瞬间融合摄像头画面、激光雷达点云和导航指令。
百度文心5.0的突破,标志着中国大模型技术从“跟随应用”到“攻坚核心架构”的重要一步。随着2026年竞争深化,谁能将原生多模态的理解深度与规模化工程落地更好结合,谁就能掌握下一阶段的主动权。百度在这场关乎未来的技术赛点上,已经凭借文心大模型,站上了关键的制高点。这场从“拼接”到“原生”的进化,将决定AI如何真正走进并改变我们的生产与生活。