初步看下V100配置情况:
显存:16/32GB 带宽:897.0 GB/s
架构:Volta
FP16算力:113.0 TFLOPS
支持NVlink2.0(300GB/S)除了架构太老之外,其他参数不亚于普通的游戏显卡,那它跑本地大模型(如Qwen3.8-27B)到底怎样呢?
注:本文主要聚焦大模型的运行速度测试,如果对此大模型的能力感兴趣,可以看看上一篇,在此文下半部分有基本的能力测试。
速度对比
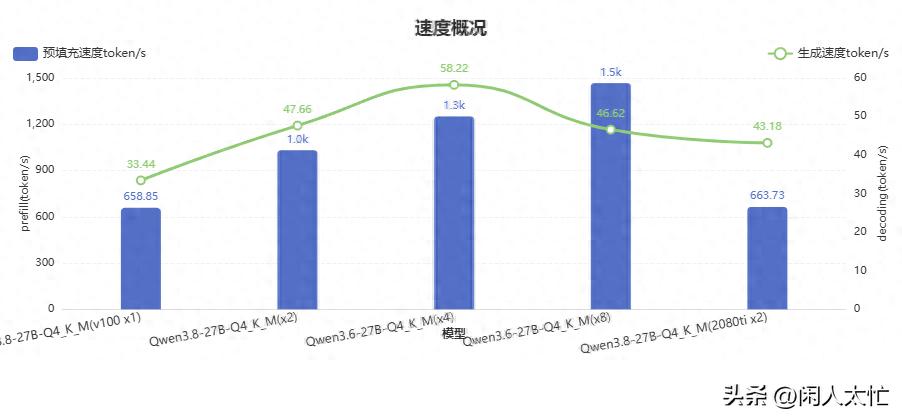
上图从前到后展示了1、2、4、8张V100运行大模型的预填充速度和输出速度,最后一个上文两张2080ti+nvlink的速度,主要作为对比展示。
测试的框架和环境:
Llama.cpp(b10092+cuda12.8+ubuntu22.04)
图中的预填充prefill速度和输出decoding速度都是在5种上下文长度(500-32k tok)采样多次平均而来。
上下文处理速度即prefill预填充速度方面,2张V100速度比1张快50%+,4张刚好比1张快1倍,8张只比4张快15%,提升不够明显。
值得一提的是,8张V100在32k的上下文时能高达2200tok/s,4张V100在超过4096tokens上下文时,prefill预填充速度为1500tok/s左右,8张卡的算力比较要强一倍,加上nvlink的连接,在prefill阶段整体上还是胜出的。
输出decoding即解码速度,2张V100的提升是最明显的,prefil提升了60%,decoding提升了40%,再增加V100个数就没有高的收益了,甚至8卡V100的输出decoding速度还略低于2张V100。
所以,不是那么追求速度的话,2卡V100是性价比最高的,4卡的综合性能最高,如果应用场景不是那么复杂苛刻,用1张V100也是能跑的。
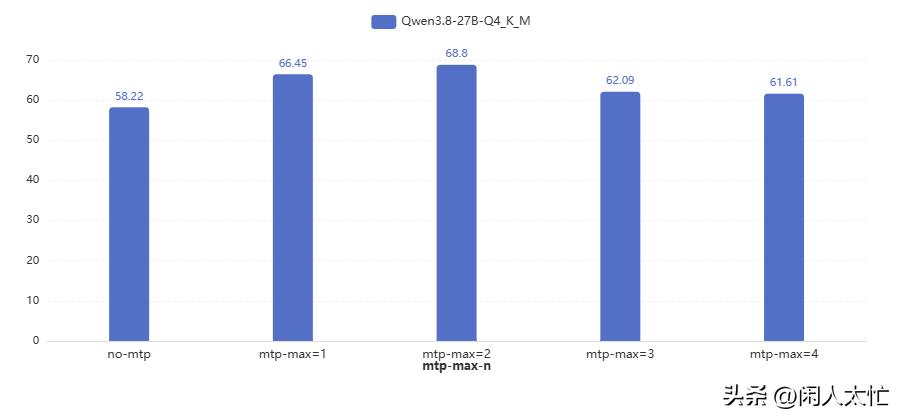
MTP提速效果这里,以4卡V100跑Qwen3.8-27B-Q4_K_M量化模型为例,下图为各mtp的输出decoding速度图。各mtp加速的预填充prefill速度都保持一致在1100tok/s左右,低于无mtp约180tok/s,图中就不列出了。
从上图可以看出,mtp为2时效率最高,提升最大。
总体来看,V100的基础能力是优于2080ti的,跑Qwen3.8-27B这个优秀本地大模型的话,2卡基本上算是很大的发挥V100的实力了,4卡是最土豪的选择,再堆多卡收益可以说为负。
大家看看自己的应用场景,择优选择V100,上文如有错误缺漏之处,还望指正交流。