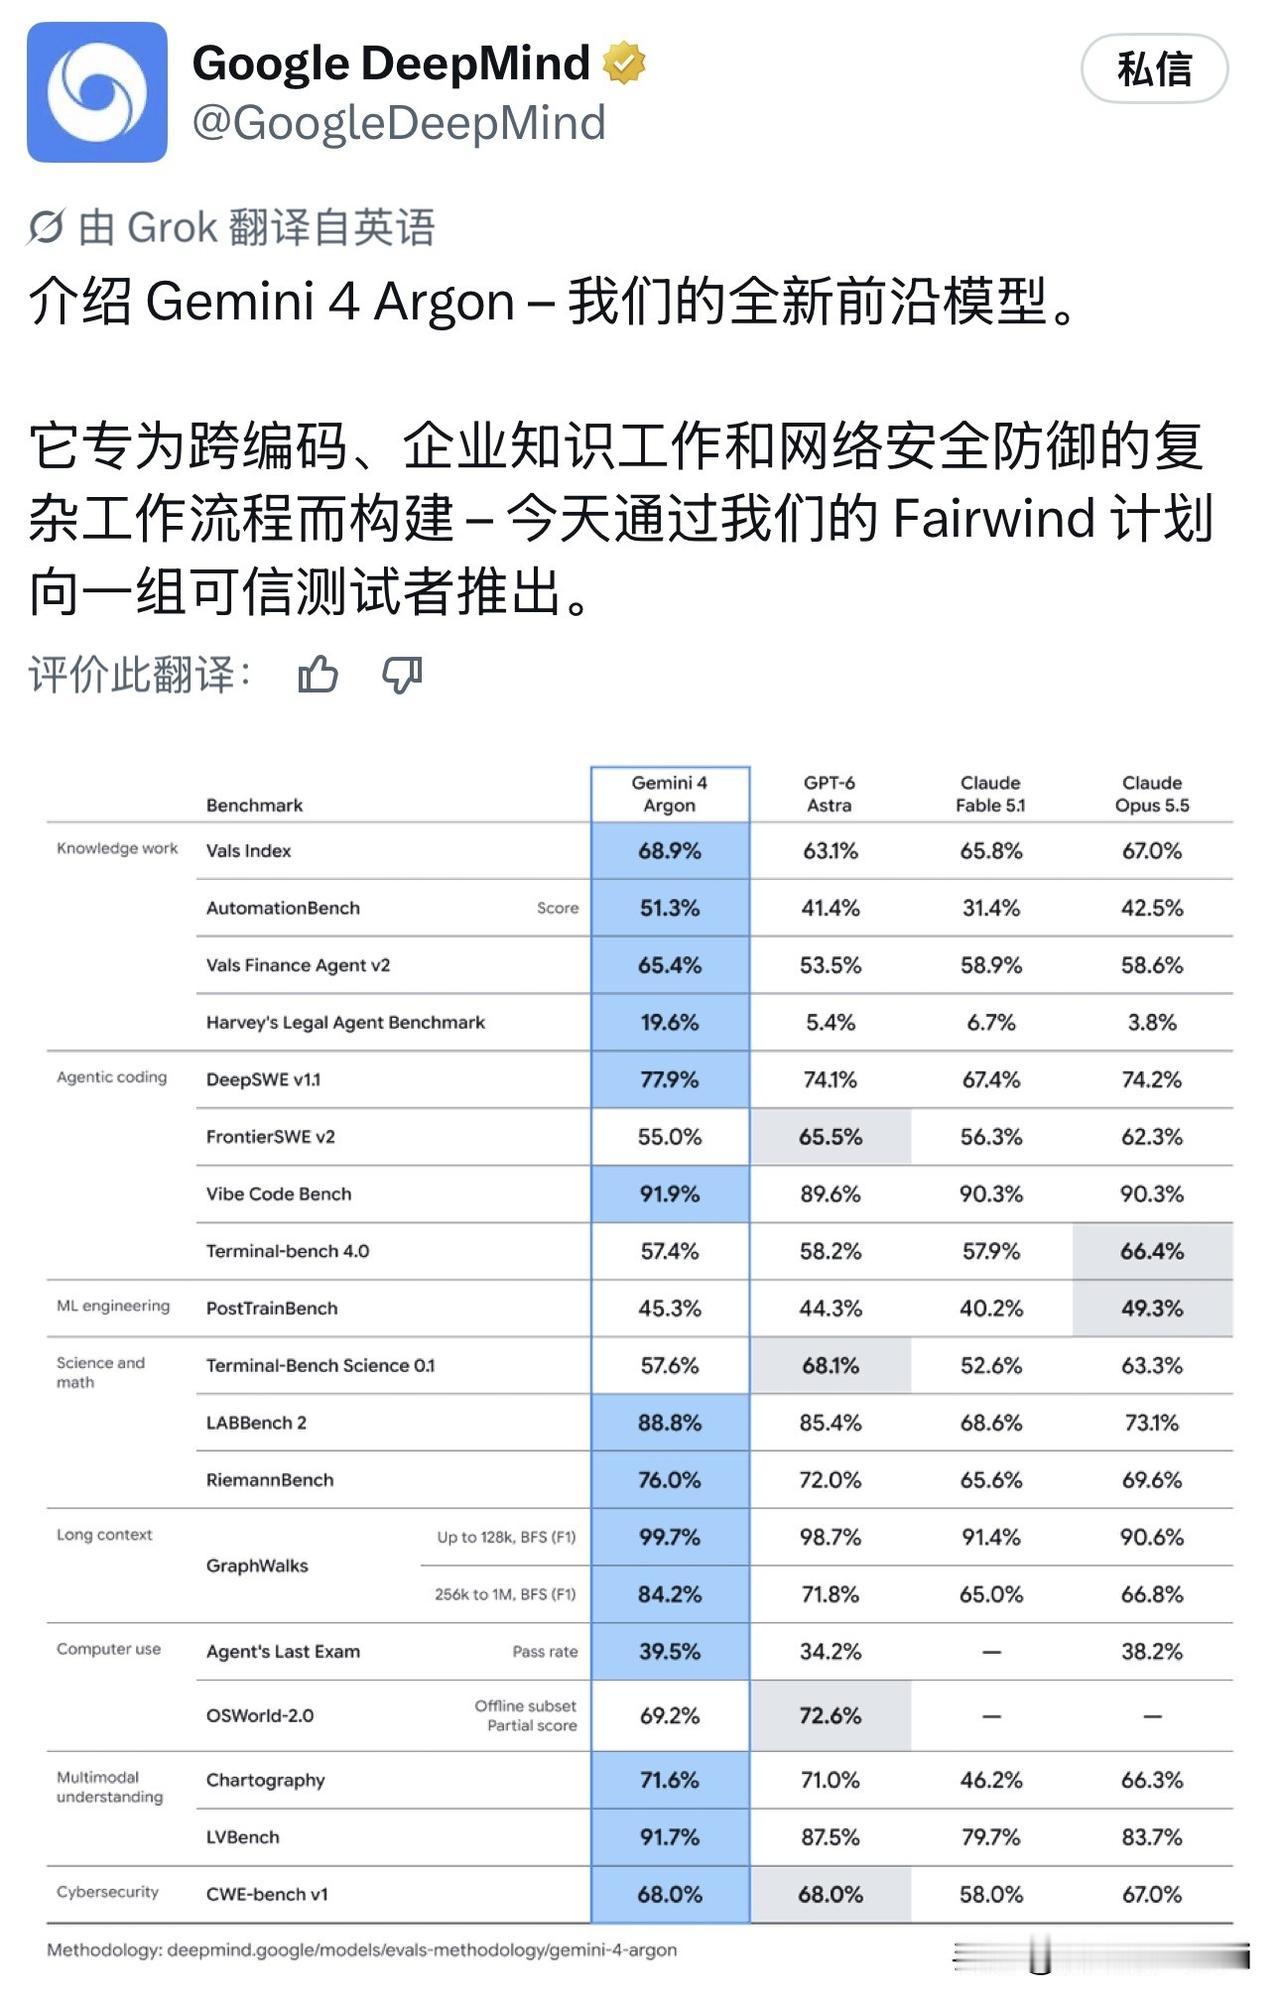
谷歌这张新模型的跑分表里,最扎眼的不是总分,是一个19.6对3.8的数字。
Gemini 4 Argon在Harvey法律代理基准上拿了19.6%,对面GPT-6是5.4%,Claude两兄弟加起来不到11%。五倍的差距,放在任何一张跑分表里都算碾压。
但真正让我高看一眼的,是谷歌没光挑自己赢的贴。FrontierSWE输了65.5对55.0,Terminal-bench 4.0输了66.4对57.4,OSWorld也没守住。敢把败项摆在自家海报里,这份表格的可信度反而上来了。
知识工作四项全胜,长上下文拉到百万token还能拿84.2%,网络安全打平GPT-6,这不是普通的版本更新,是在告诉所有人:主战场已经从聊天框挪到了企业工作流。